大模型面试转向智能体:Harness工程与Langfuse跟踪成必考点

2026大模型应用岗面试转向智能体工程,多智能体、Harness与评估成必问项。
文章基于一位B站讲师的学员面经汇总,指出2026年大模型应用方向面试重心已从八股文和Python语法细节转向AI智能体工程能力,其中多智能体架构、Harness工程、智能体跟踪与评估是三大高频必问板块。企业落地时单智能体难以支撑复杂业务,多智能体协作与编排成为真实工程难点;跟踪与评估则会追问工具调用失败、token管理、提示词升级后的质量回归等场景题,Langfuse等工具出现频率高;若简历含企业级智能体经历,安全机制(skill安全、数据与文件权限)属门槛项。文章同时提醒应届生仍需准备算法笔试,并建议对照JD只学岗位要求内容,先占坑再深耕。
大模型面试的风向变了
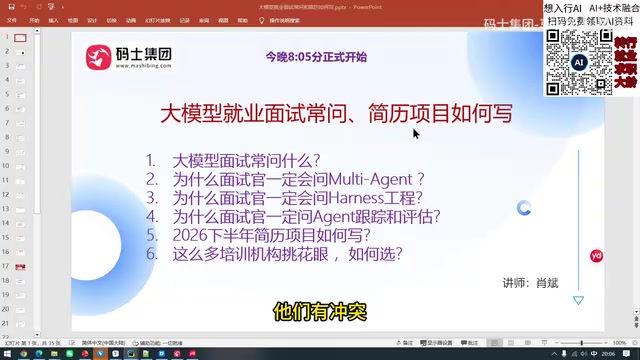
如果你还在死磕八股文和Python语法细节,可能已经偏离了当下大模型岗位面试的真实考察方向。据B站一位长期跟踪学员面试反馈的讲师观察,2026年大模型应用方向的面试重心已经明显转向AI智能体(Agent)相关工程能力,尤其是多智能体架构、Harness工程、智能体跟踪与评估三大板块。
这位讲师在直播中坦言,自己收集了大量学员的一手面经,对应届生和三年以内经验者的情况尤为熟悉。他给出的判断很直接:面试官问什么,你就学什么。语法细节、垃圾回收机制这类前两年还会被问到的内容,从2025年开始已经基本淡出面试范围。
为什么这三个方向成了必问项
多智能体与Harness工程
面试官一定会问多智能体,也一定会问Harness工程——这是讲师反复强调的两点。背后的逻辑并不复杂:企业落地智能体时,单智能体往往撑不起复杂业务,多智能体的协作、编排、冲突处理才是真实工程中的难点。Harness工程则涉及如何把模型能力稳定地接入实际系统,属于工程化落地的核心环节。
讲师的建议是,简历里不要堆砌太多单智能体的内容,把篇幅留给多智能体架构和Harness相关的工程实践。
Harness工程一词在智能体语境下,指的是围绕模型构建的一整套“承载与驱动”框架,包括提示词组织、工具/函数注册与调用、上下文与记忆管理、对模型输出的解析与校验、失败重试与降级、以及对执行过程的日志埋点等。模型本身只负责推理与生成,真正决定一个智能体能否稳定跑在生产环境里的,是这层外围工程。Harness可理解为智能体的“运行时骨架”:它把模型能力与外部工具、数据、业务系统粘合起来,并负责在模型输出不稳定时做兜底。企业面试强调Harness工程,本质上是在考察候选人能否把不可靠的模型封装成可靠的系统,而不仅是会写提示词。
智能体的跟踪与评估
这一块被问得非常密集,而且不局限于概念层面的"怎么评估智能体"。面试官会追问具体场景:工具调用失败了怎么办?token管理怎么做?智能体上线后,随着提示词持续升级、skill不断增加,如何保证新版本的质量评估?这些都是实打实的工程场景题。
讲师特别提到,Langfuse这类跟踪与评估工具在面试中出现频率很高,建议简历往这个方向靠拢。
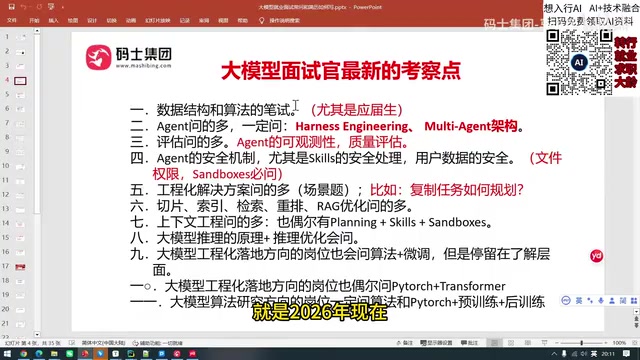
Langfuse是一款开源的LLM应用可观测性平台,常被用于智能体的跟踪(tracing)与评估(evaluation)。它的核心能力包括:以树状结构记录一次请求中各个步骤(模型调用、工具调用、检索等)的输入输出与耗时,形成可回溯的trace;对提示词进行版本管理与在线比对;支持接入人工标注或自动评分(如LLM-as-judge)来对新版本做回归评估;并统计token消耗与成本。面试中提及这类工具,往往是在考察候选人是否理解“智能体上线后如何持续观测质量、定位失败链路、评估版本迭代带来的效果波动”,而不仅是知道工具有哪些功能。
智能体安全机制
如果简历里写了在企业中开发智能体的经历,安全问题是必问项。考察点包括skill的安全问题、用户数据安全、文件权限如何设计。讲师用了"必问"来形容,说明这不是加分项而是门槛项。
Skill在智能体语境下通常指封装好的、可被智能体按需调用的能力单元,可能对应一个工具函数、一段领域流程或一份提示词模板。skill的安全风险主要来自几方面:一是skill可能携带文件读写、网络请求、命令执行等权限,一旦被恶意提示词或不可信输入诱导调用,可能造成越权操作;二是skill的来源若不可信,可能被植入恶意逻辑;三是skill数量增长后,权限边界容易失控。常见防护思路包括最小权限原则、对高风险skill做人工确认或沙箱隔离、对输入输出做校验与审计日志,以及按角色限制可调用的skill集合。
应届生还要面对算法笔试
需要区分的是,智能体方向的考察主要针对应用和工程化落地岗。如果是应届生或工作三年内的候选人,数据结构与算法的笔试或面试出现概率依然较高。讲师的原话是"这句话我只讲一遍",提醒应届生不要因为智能体热就把算法基础完全丢掉。
先占坑,再深耕
直播中有一段相当务实的建议值得单独拎出来。讲师面对毕业季找工作的人群,给出的策略是:快速对照市面上大模型岗位的JD,只学岗位要求里的那部分内容,先拿到offer占住一个大模型的坑,哪怕薪资暂时低一些,进去之后再边工作边补。
他的理由很现实:工程类专业的第一要务是解决工程问题,而不是从底层原理一路啃到底。工作后真正要用到的技术,不一定非得在面试前全部学完,入职后一两周内补上也来得及。这话听着功利,但对时间窗口紧张的求职者来说,方向感比完美主义更重要。
简历该怎么调整
综合讲师透露的面试趋势,简历调整可以抓住几条主线:弱化单智能体的独立项目描述,突出多智能体协作与Harness工程经验;把智能体的可观测性写实,包括跟踪、评估、提示词版本管理和skill迭代带来的质量波动处理;如果涉及企业级落地,明确写出安全机制的设计思路。复杂任务规划这类场景题也要提前准备,面试官可能会临场给出一个业务场景让你现场拆解。
需要注意,以上内容来自单一讲师的直播分享与学员反馈汇总,属于经验性判断而非官方统计,读者可以结合自身面试经历交叉印证。
背景补充
LLM-as-judge是智能体评估中常用的自动评分方法:用一个能力较强的模型作为评审,按预设评分标准对被评模型的输出打分或做偏好比较。它适合处理开放式、难以用精确匹配衡量的任务(如回答质量、工具调用是否合理),成本低于人工标注,但存在评审模型自身的偏见、位置偏好和对提示词敏感等问题。工程实践中通常需要人工标注样本做校准、设计明确的评分细则(rubric),并与规则类指标(如工具调用成功率、任务完成率)结合使用,避免单一自动评分带来的误判。
相关推荐
LangChain Agent 不再持有 Stripe 密钥:退款需 Slack 审批
开发者分享 LangChain Agent 凭证管理方案:Agent 不持有 Stripe 密钥,敏感操作如退款通过本地代理转发,并在 Slack 中人工审批后才执行,附代码示例与工程细节。
LangChain真让Agent开发更简单?开发者反思抽象代价
Reddit开发者反思LangChain与LangGraph在多智能体工作流中的抽象代价:入门容易,但StateGraph、状态管理、调试与成本控制带来新复杂度。讨论调试方法、是否混用原生Python+模型SDK,以及生产环境中的经验取舍。
实测TimesFM 3.0、Chronos-2、Toto 2.0:时序大模型跑不赢简单基线
开发者零样本实测TimesFM 3.0、Chronos-2和Toto 2.0在24只美股及ETF上的预测表现,方向准确率仅49.9%-51.1%,模拟交易跑输买入持有策略,时序基础模型在金融数据上未展现超越简单基线的能力。