Databricks VLDB2026:Agent-Native数据基础设施全解析

Databricks在VLDB 2026展示Agent-Native数据平台愿景,以Lakebase、LTAP和学习型优化器重构AI时代数据基础设施。
Databricks在VLDB 2026大会上以黄金赞助商身份系统阐述了其「Agent-Native」技术路线:当LLM驱动的AI智能体取代人类成为数据系统的主要调用方时,传统数据库在接口设计、查询优化和架构融合等层面都需要根本性重构。本次会议重点展示了三大技术方向:以AutoLiquid和Ultron为代表的学习型查询优化器,以Lakehouse//RT、Lakebase(PostgreSQL兼容存储引擎)和LTAP(湖仓事务分析融合处理)构成的统一数据技术栈,以及面向AI工作负载的系统级设计哲学转变。联合创始人Reynold Xin的主题演讲将这些技术收敛为一个核心判断:Agent时代需要同时支持事务、分析和实时流处理的融合平台,而非在现有架构上叠加AI功能。
Databricks的Agent-Native愿景
VLDB 2026正在进行中,Databricks作为黄金赞助商带来了一系列面向未来的技术创新。这家数据湖仓公司正在重新定义数据基础设施的形态,核心理念是构建「Agent-Native」(原生智能体)的数据系统。
Databricks联合创始人Reynold Xin在主题演讲中阐述了为何Agent时代需要Lakebase Postgres。这一论断背后,是对AI应用架构根本性变化的深刻洞察——当大语言模型驱动的智能体成为数据处理的主要参与者时,传统数据库架构面临的已不是优化问题,而是范式重构的挑战。
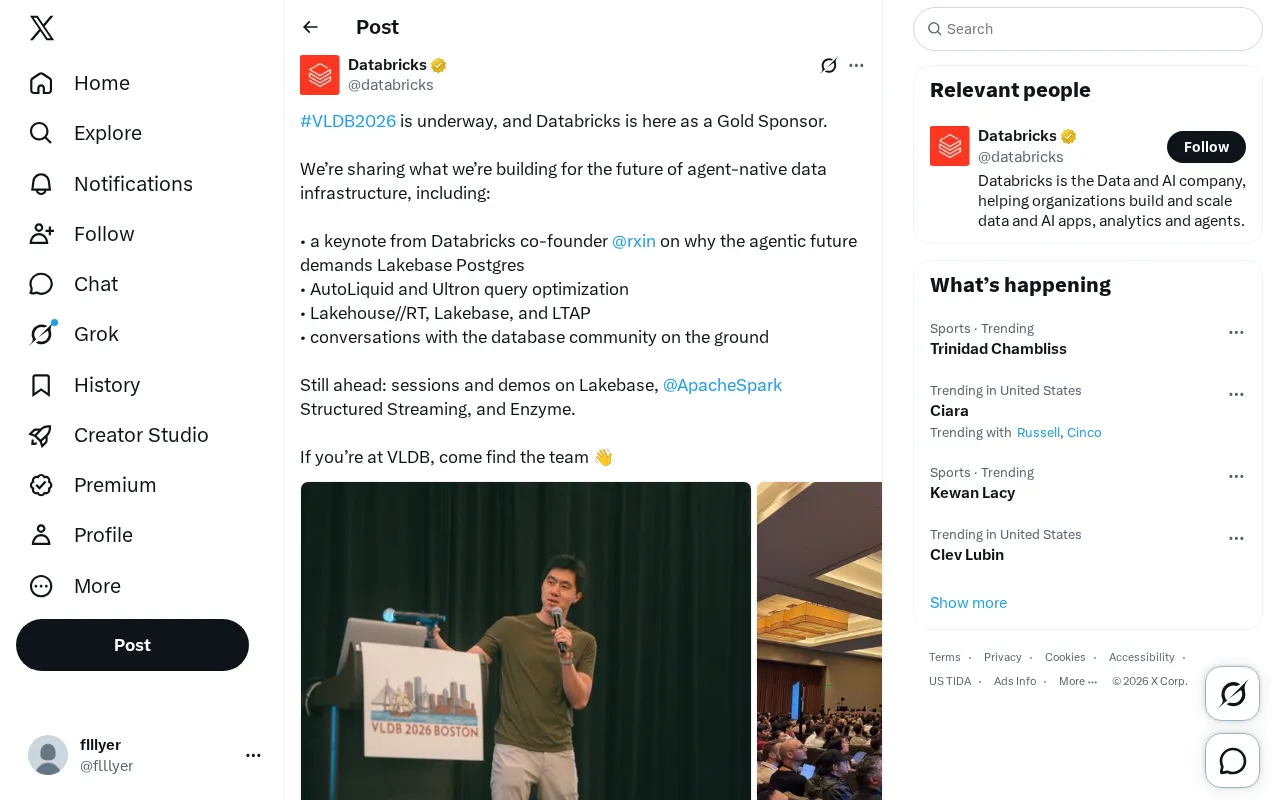
「Agent-Native」的概念源于软件架构设计的演进逻辑。传统数据系统以人类用户为中心设计接口和优化策略——SQL是人类可读的声明式语言,查询计划缓存基于人类重复操作的规律,权限模型假设用户具备主动的意图判断能力。而在以LLM为核心的Agent架构中,数据库的调用方变成了自主运行的AI程序:它们以极高频率动态生成查询、在多步推理中反复读写状态、并发执行多个子任务,且无法像人类DBA那样提前规划或人工干预异常。这要求数据系统在接口语义、并发控制、错误恢复和可观测性等层面重新设计,而不仅仅是在现有架构上叠加AI功能。
三大核心技术突破:查询优化、实时处理与统一架构
此次VLDB会议上,Databricks重点展示了三大技术方向,每一项都指向Agent时代的数据处理需求。
查询优化的革命性进展
AutoLiquid和Ultron代表了新一代查询优化器的技术方向。AutoLiquid实现了自动化的液态查询优化,能够根据工作负载特征动态调整执行策略,而非依赖静态规则。Ultron则更进一步,将机器学习深度集成到查询计划生成过程中,使优化器能够从历史执行数据中持续学习、自主进化。
两者的共同目标很明确:当查询来自AI Agent而非人类DBA时,优化器必须具备更强的自适应能力。
查询优化器的演进历史可以分为三个阶段:基于规则的优化(RBO)依赖专家预设的启发式规则;基于代价的优化(CBO)引入统计信息和代价模型来枚举执行计划;而以Ultron为代表的学习型优化器(Learned Optimizer)则尝试用机器学习模型替代或增强代价估算模块。学界在这一方向已有大量探索,包括用深度强化学习做Join顺序选择的DQ(Deep Q-Network)方法,以及用图神经网络建模查询结构的Bao等系统。工程落地的挑战在于:ML模型在训练分布之外的泛化能力有限,而生产查询的多样性远超离线训练数据,AutoLiquid试图通过持续的在线学习机制来缓解这一问题。
Lakehouse架构的三大支柱
Lakehouse//RT(实时湖仓)、Lakebase和LTAP(湖仓交易分析处理)构成了Databricks完整的技术栈:
- Lakehouse//RT 专注于低延迟流式数据处理,满足实时决策场景的需求
- Lakebase 提供PostgreSQL兼容的存储引擎,降低迁移和学习成本
- LTAP 打通事务处理和分析查询的壁垒,实现真正统一的数据平台
这三者的组合,本质上是在回答一个问题:AI Agent需要怎样的数据底座?答案是一个同时支持事务、分析和实时流处理的融合平台。
LTAP(Lakehouse Transactional-Analytical Processing)是对HTAP(混合事务/分析处理)概念的湖仓化延伸。传统HTAP系统通过在同一数据库引擎内维护行存与列存两份数据副本,实现事务与分析的并行处理,Oracle、TiDB、SingleStore均走这一路线。LTAP则将这一思想与开放表格式(如Delta Lake)结合:事务写入直接落到对象存储上的共享数据层,分析查询通过向量化引擎扫描同一份数据,无需ETL搬运。这一设计的优势在于消除数据冗余、降低一致性维护成本,但对存储层的并发控制和元数据管理提出了更高要求,也是Lakebase选择深度绑定PostgreSQL兼容协议的工程背景之一。
与学术界的深度对话
Databricks在VLDB上不仅展示产品,更重视与数据库研究社区的交流。会议现场的对话环节聚焦于一个关键命题:当查询不再由人类编写,而是由AI自动生成时,数据库需要怎样的接口和优化策略?
即将进行的技术分享涵盖多个方向:
- Lakebase架构的深度剖析
- Apache Spark Structured Streaming的最新进展
- Enzyme编译优化技术的实战应用
这些话题反映了Databricks在系统层面的持续深耕,也为学术研究提供了丰富的工程实践参考。
Apache Spark Structured Streaming是Spark在2016年引入的统一流批处理框架,其核心设计思想是将流数据处理抽象为对无界表的连续查询,底层采用微批(Micro-Batch)或持续处理(Continuous Processing)两种执行模式。与早期的Spark Streaming相比,Structured Streaming提供了端到端的Exactly-Once语义保证,并与DataFrame/Dataset API统一,大幅降低了流批一体开发的复杂度。在Agent时代,流处理的重要性进一步凸显——AI Agent的实时感知、多轮对话的状态维护、以及在线特征的低延迟计算都依赖高吞吐、低延迟的流处理能力,这也是Lakehouse//RT在Databricks整体架构中占据独立支柱地位的根本原因。
技术趋势解读:Agent时代的数据基础设施走向何方
Databricks的技术路线揭示了数据基础设施的三个重要趋势:
趋势一:智能体优先设计
传统数据库假设用户精通SQL,但在LLM驱动的Agent时代,数据库需要能够理解自然语言意图、自动生成优化查询,并提供可解释的执行计划。这不是功能层面的增强,而是设计哲学的转变。
趋势二:湖仓融合持续深化
Lakebase的推出表明,单纯的存算分离已不足以满足需求。市场需要的是一个能同时保证事务一致性、支撑大规模分析、处理实时流数据的统一平台。湖仓一体正在从概念走向成熟落地。
趋势三:优化器从规则驱动转向学习驱动
AutoLiquid和Ultron所代表的自适应优化技术,预示着查询优化将完成从基于规则到基于学习的范式迁移。优化器本身正在成为一个持续进化的智能系统。
对数据工程师的启示
对于数据工程师和架构师而言,Databricks在VLDB 2026上展示的这些创新意味着数据平台选型标准需要更新。除了传统的性能指标和成本考量,系统对AI工作负载的原生支持能力正在成为关键评估维度。
具体来说,需要关注的评估要素包括:数据库是否支持Agent友好的接口设计、查询优化器的自适应学习能力、以及平台在事务-分析-实时处理之间的融合程度。
相关推荐
富士 Instax Pal 2 迷你相机:补齐屏幕短板的升级之作
富士发布 Instax Pal 2 迷你数码相机,相比初代新增屏幕与取景器,采用微缩化相机造型,补齐了初代盲拍的核心短板,成为一款更实用的便携即时成像设备。
Linux from Scratch:从零手工构建你的Linux系统
Linux from Scratch(LFS)是一个教你从源代码手工构建 Linux 系统的开源项目。本文介绍 LFS 的核心价值、BLFS/ALFS 项目生态及适用人群,帮助你理解 Linux 底层机制。
TechCrunch Disrupt 2026参展倒计时:初创企业的曝光机会
TechCrunch Disrupt 2026 参展报名 9 月 18 日截止,仅剩 4 天。展会 10 月 13-15 日举办,预计吸引超万名创始人、投资人与科技领袖,是初创企业曝光与融资的重要机会。