Datamimic:给AI编程助手一个可控的测试数据世界
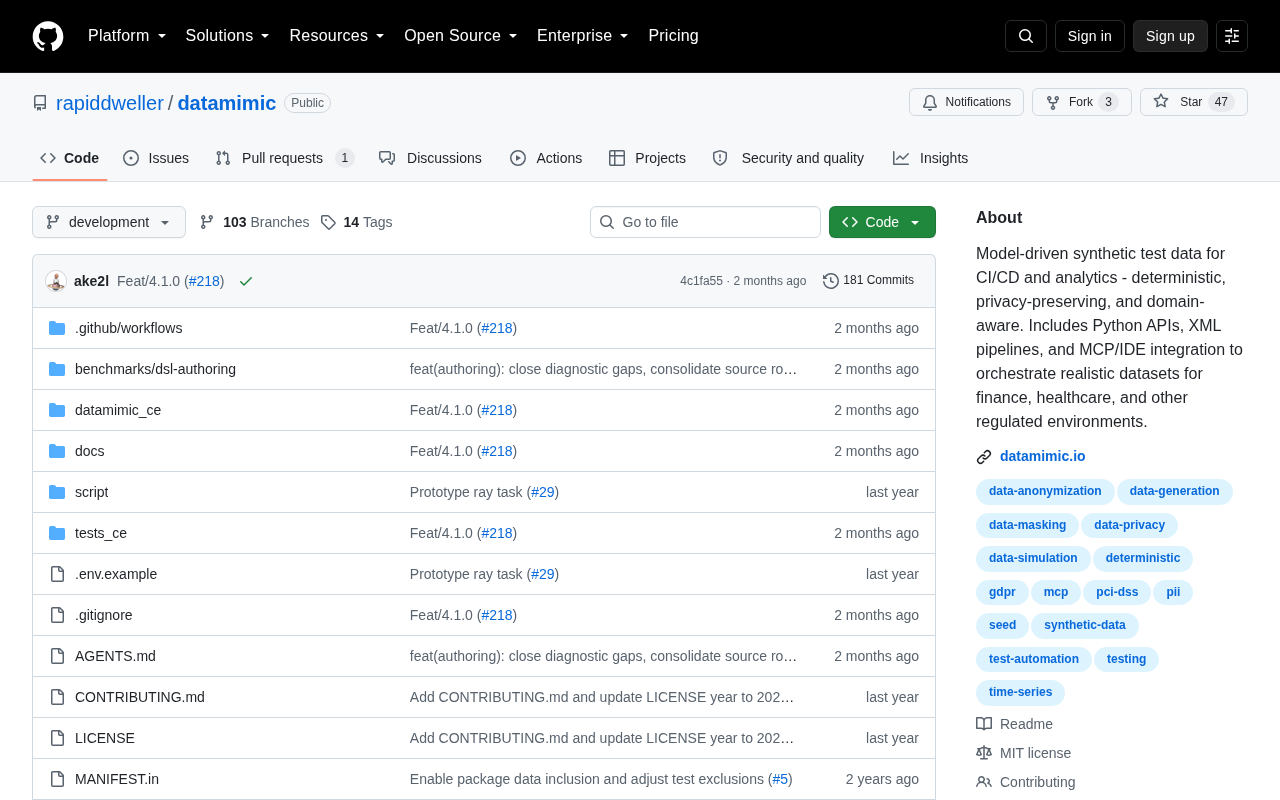
开源工具Datamimic主张用规则驱动替代AI随意捏造测试数据,守住AI辅助开发的测试质量底线。
随着AI编程助手大规模进入开发流程,一个被忽视的隐患逐渐显现:编码代理在生成测试数据时往往依赖随机占位符,无法保证字段格式合规、边界值覆盖完整以及数据关系自洽,由此产生的「虚假通过」会给开发者带来错误的安全感。开源项目Datamimic针对这一问题,主张将数据生成控制权从AI的即兴发挥转移到声明式规则与模型约束,使测试数据既贴近真实业务分布、又具备可复现性。文章指出,这一方向代表了AI辅助开发中「配套治理基础设施」的新兴需求,尽管Datamimic本身社区热度有限、成熟度仍待验证,但其提出的核心矛盾——效率与可控性之间的平衡——已是每个大规模采用编程助手的团队必须正视的工程治理问题。
当编程助手开始「自己造世界」
随着AI编程助手在开发流程中承担越来越多的任务,一个隐蔽的问题浮出水面:当你让编码代理(coding agent)编写或运行测试时,它往往会凭空「捏造」测试数据。这些数据看似合理,实则脱离真实业务场景——字段格式随意、边界值缺失、数据关系不自洽。开源项目 Datamimic 正是针对这一痛点提出的解决方案,其核心主张一目了然:不要让你的编码代理自己发明测试世界。
这个命题背后反映的是AI辅助开发中的信任边界问题。代理生成的测试数据如果不可控,测试结果的可信度就会大打折扣,甚至可能让开发者对「已通过」的测试产生虚假的安全感。
为什么AI生成的测试数据不可靠
编码代理在缺乏约束时生成测试数据,通常存在几个结构性缺陷。它倾向于使用最简单的占位符(如 test@test.com、John Doe),无法覆盖真实数据的多样性;对于有依赖关系的字段——比如订单金额与商品明细的加总关系——代理很难保证一致性;针对特定地区的格式规范(身份证号、电话号码、邮政编码等)也经常出错。
这些问题在单个函数的单元测试中或许影响有限,但在集成测试或数据密集型场景中,虚假数据会掩盖真实的边界条件和异常路径。Datamimic 的思路是把测试数据的生成从「代理的随机想象」转变为「基于规则和模型的可控产出」,让数据既贴近真实分布,又保持可复现性。
从测试工程的视角来看,测试数据质量问题可以用「测试预言机问题」(Test Oracle Problem)来理解:当测试数据本身由同一个AI系统生成时,测试验证的实际上是AI对自身输出的自我一致性,而非代码对真实业务需求的符合度。这类「自我验证」的测试可以全部通过,却对真实缺陷毫无检测能力。在更技术化的层面,AI语言模型生成数据时依赖的是训练语料中的统计分布,这导致它会优先产出「最常见」的样本,天然回避低频但关键的边界情况——例如超长字符串、特殊Unicode字符、跨时区的时间戳边界、以及数值溢出场景。这些恰恰是真实系统中最容易出现故障的地方。
Datamimic 想解决的核心问题
从项目定位看,Datamimic 试图充当编码代理与测试数据之间的一层「护栏」。开发者可以定义数据的结构、约束与分布特征,由工具生成符合规范的模拟数据,而不是任由AI在每次运行时即兴发挥。这样带来的直接好处是:
- 可复现性:测试数据可以在不同环境、不同运行中保持一致,便于定位问题。
- 贴近真实:生成的数据遵循真实世界的格式与关系约束,测试更有意义。
- 降低幻觉风险:把数据生成的控制权交还给明确的规则,减少AI「一本正经胡说」带来的隐患。
对于正在大规模引入AI编程助手的团队来说,这类工具触及了一个实际的工程治理问题:如何在享受代理效率的同时,守住测试质量的底线。
在测试数据管理的工具谱系中,Datamimic 所处的位置接近「合成数据生成器」(Synthetic Data Generator)与「基于模型的测试」(Model-Based Testing)的交叉地带。传统方案大致分为三类:以 Faker、Mimesis 为代表的随机占位符库,主要解决数据格式问题;以数据库 fixture 和快照为代表的静态测试数据管理,依赖人工维护;以及从生产环境脱敏导出真实数据的方案,存在隐私合规成本。Datamimic 的思路是让开发者通过声明式规则描述数据的结构约束与字段间关系,由引擎保证生成结果的内部一致性——这一方式在自动化测试规模较大时,可以显著降低手动维护 fixture 的负担,同时避免纯随机生成的不可预期性。
一个值得关注但仍需观察的方向
需要客观指出的是,Datamimic 目前在社区中的讨论热度还比较有限(Hacker News 上仅有个位数的点赞与评论),这意味着它更多代表了一个新兴的问题意识,而非已被广泛验证的成熟方案。测试数据生成本身并非全新领域,业界早有各类 mock 数据、fixture 与合成数据工具。Datamimic 的差异化价值,在于它明确地把「AI编程助手」作为使用场景来设计。
随着编码代理逐渐成为开发工作流的常态,围绕它们的配套治理工具——包括测试数据管理、输出验证、权限控制等——很可能会成为下一波值得关注的基础设施。Datamimic 提出的这个视角,恰好点出了AI辅助开发中一个容易被忽视却影响深远的环节。
结语
「不要让你的编码代理自己发明测试世界」这句口号,抓住了当下AI编程工具落地过程中的一个真实矛盾:效率与可控性之间的平衡。对于开发者而言,认识到AI生成测试数据的局限,并主动引入约束机制,是让AI真正成为可靠助手的关键一步。Datamimic 是否会成为该领域的标准工具尚待时间检验,但它提出的问题本身,已经足够引起每个使用编程助手的团队认真思考。
相关推荐
一个月为M4 Mac Mini开发Linux GPU驱动的技术挑战
开发者Cody Ho用一个月时间为M4 Mac Mini构建Linux GPU驱动,本文解析Apple Silicon GPU逆向工程的核心难点、开源社区协作价值及其对Linux硬件生态的意义。
SEO Page Builder Enhanced:让AI生成的SEO内容摆脱套路味
开发者基于octelens原版seo-page-builder打造的增强版开源工具,通过引入编辑审校、一手经验、事实与时效校验及写作风格护栏,专门解决AI生成SEO内容套路化、缺乏原创洞见的问题。
分层RAG架构研究求助:独立开发者如何叩开学术研究之门
一位独立开发者在Reddit求助信息检索领域教授,指导其分层RAG架构研究。本文剖析异构文档检索的技术背景,探讨独立AI研究者面临的学术门槛困境,并给出公开成果、社区协作等实用建议。