Deep Agent子智能体解析:LangChain生态下的企业级AI Agent框架

Deep Agent是LangChain团队为长周期任务打造的高稳定智能体框架,核心机制是子智能体。
文章围绕LangChain团队推出的Deep Agent展开,首先解释其诞生动因:已有LangChain和LangGraph之后,仍需要一个专门面向长周期任务、以稳定性为首要目标的智能体框架。接着梳理LangChain生态分工——LangChain提供模型封装、RAG、工具调用、记忆等零件,LangGraph提供状态循环、分支、断点恢复等运行底盘,LangSmith负责监控,而Deep Agent像Spring Boot一样把前两者组装成完整智能体。文章重点介绍子智能体机制,区分同步与异步两类子智能体,说明其用于让主智能体更高效地处理复杂任务。最后指出企业级项目已普遍基于该理论构建更自主稳定的Agent,并建议学习者把LangChain与LangGraph视为基础组件来理解。
为什么需要Deep Agent?
如果你接触过LangChain或LangGraph,可能会疑惑:已经有了这些框架,为什么LangChain团队还要推出Deep Agent?答案在于长周期任务的稳定性。Deep Agent定位为构建复杂、长周期任务的智能体框架,核心目标不是“能跑起来”,而是“能长期稳定地跑下去”。
据LangChain团队介绍,Deep Agent大约在2025年11月左右推出,它并非从零打造,而是站在LangChain和LangGraph的肩膀上,通过Harness等形态帮助开发者构建更强、更自主的Agent。
长周期任务(Long-Horizon Tasks)指的是需要数十乃至数百步操作、跨越多次工具调用与状态切换才能完成的复杂任务,例如端到端的代码重构、多轮研究调研报告的撰写、跨系统的工单处理流程等。这类任务与单轮问答或短链工具调用有本质区别:执行链路越长,中间步骤出错的概率按乘法累积,上下文窗口也容易被历史信息撑满,模型还可能在多轮循环中偏离初始目标。因此,评估一个智能体框架的关键指标从“单次任务成功率”转向“在长序列执行中的稳定性与可恢复性”——包括失败后的重试、状态持久化、上下文压缩与任务分解能力。Deep Agent把稳定性放在首位,正是针对这一痛点做的工程取舍。
Deep Agent在LangChain生态中的位置
要理解Deep Agent,先要看清LangChain生态的全貌。这个生态里包括LangChain(封装模型、RAG、工具调用、记忆管理、上下文处理等能力)、LangGraph(提供状态循环、分支、断点恢复等运行机制)、LangSmith(智能体监控),以及Deep Agent。
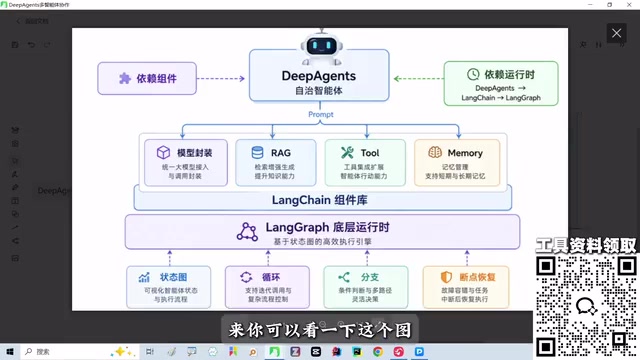
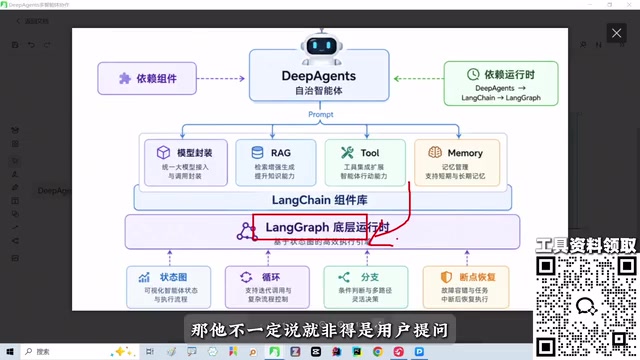
从架构上看,LangChain提供各种“零件”,LangGraph提供“运行底盘”,而Deep Agent则是把两者组装成一个更完整的智能体。这种关系类似于Java生态中的Spring Boot——开发者不需要直接操作Spring和Spring MVC的底层细节,Spring Boot已经将它们集成好了。Deep Agent在LangChain家族中的定位正是如此。
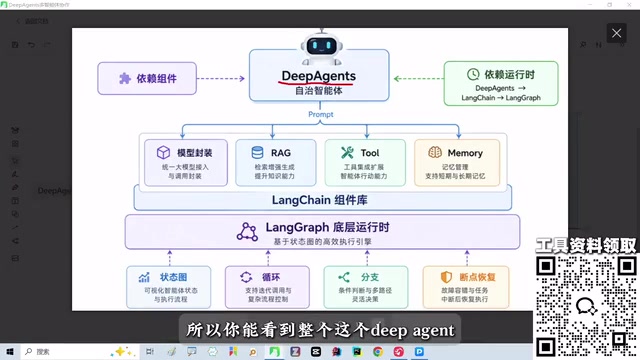
Harness(运行外壳/执行骨架) 是智能体工程中的一个关键概念,指的是包裹在模型之外的整套执行结构:它负责组织提示词、调度工具调用、管理循环与中断、注入上下文、处理错误重试,并把模型的单次推理串成一条可持续推进的执行流。可以把它理解为智能体的“运行时脚手架”——模型本身只提供推理能力,而 Harness 决定了这份推理能力能否被可靠地编排成多步骤行为。不同 Harness 设计会显著影响智能体的鲁棒性、可观测性和成本。Deep Agent 以 Harness 形态出现,意味着它不只是若干 API 的集合,而是一套带有约定执行流程的智能体运行时,开发者在其上填充业务逻辑即可。
子智能体:Deep Agent的核心机制
本次课程的重点是Deep Agent中的子智能体(Sub-Agent)。子智能体分为同步子智能体和异步子智能体,它们的设计目的是让主智能体能够更高效地处理复杂任务。为什么要这样做?因为长周期任务往往需要多个步骤、多种能力协作,单一智能体难以兼顾稳定性和灵活性。
讲师强调,很多非VIP学员可能只接触过Python、LangChain或LangGraph,对Deep Agent和Harness这些较新的概念还不熟悉。但不必担心,课程会以思维导图的形式沉淀重点,跟着节奏走即可。
主智能体 / 子智能体(Orchestrator–Sub-Agent) 是一种分层协作架构。主智能体充当调度者,负责理解整体目标、拆解任务、决定何时调用哪个子智能体,并汇总结果;子智能体则是面向特定领域或特定工具集的专精单元,拥有独立的上下文与提示词,只专注于自己那一小块工作。这种拆分带来两个直接收益:一是上下文隔离,子智能体不必携带主流程的全部历史,避免上下文膨胀与信息干扰;二是职责收敛,每个子智能体只需在其窄领域内保持稳定,整体系统的可靠性由编排层兜底。同步子智能体需等待返回结果后再继续,适合有严格依赖顺序的步骤;异步子智能体则可并行发起、稍后回收结果,适合彼此独立、耗时的子任务。
企业级应用与学习建议
Deep Agent并非玩具框架。讲师提到,VIP课程中的项目正是基于这套理论讲解的,而企业中构建更强、更自主、更稳定的Agent时,基本都在使用Deep Agent。对于初学者,不需要把LangGraph想得太复杂——它本质上就是Agent的运行底盘,负责状态循环、分支、断点恢复等机制。
学习Deep Agent时,可以把LangChain和LangGraph视为基础组件,重点理解Deep Agent如何将它们组装成完整的智能体系统。这样即使对底层细节掌握不深,也能跟上课程节奏,逐步建立起对子智能体机制的清晰认知。
本文内容整理自B站视频《ChatGPT到Codex完整入门|安装登录、界面详解与AI排查Bug实战一次讲透!》中关于Deep Agent子智能体的讲解片段。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。