DeepFinance基准:AI能否胜任百亿级私募尽调?

DeepFinance基准显示最强AI仅满足57.6%专家标准,尽调仍需人类判断。
DeepFinance 是面向私募股权与投资银行的端到端评测基准,包含21个任务,人类平均耗时27.1小时,每个任务配有平均19个文件的数据室和84条专家评分标准,覆盖输出结果、工作流程与判断质量。研究评估22种模型配置,最佳配置GPT-6 Astra搭配最大推理强度仅满足57.6%的标准,前四名统计上无法区分。前沿模型呈现两类典型失败:从错误输入算出正确答案,以及找到关键证据却不据此行动。基准将评测焦点从答案正确性转向过程可靠性,说明当前模型适合信息整理与计算核验等辅助角色,而权衡冲突信息、设定关键假设仍需人类判断。
当AI走进私募股权尽调室
私募股权(PE)和投资银行(IB)的日常工作,远不止从财报里找数字那么简单。一份真实的交易备忘录背后,是分析师在 conflicting 的数据源之间做取舍、在信息不全时做出合理假设、并把每一步推理都留下可审计的痕迹。现有的AI评测大多停留在“检索答案”和“算对数”的层面,这与真实的高强度金融工作之间存在一道鸿沟。
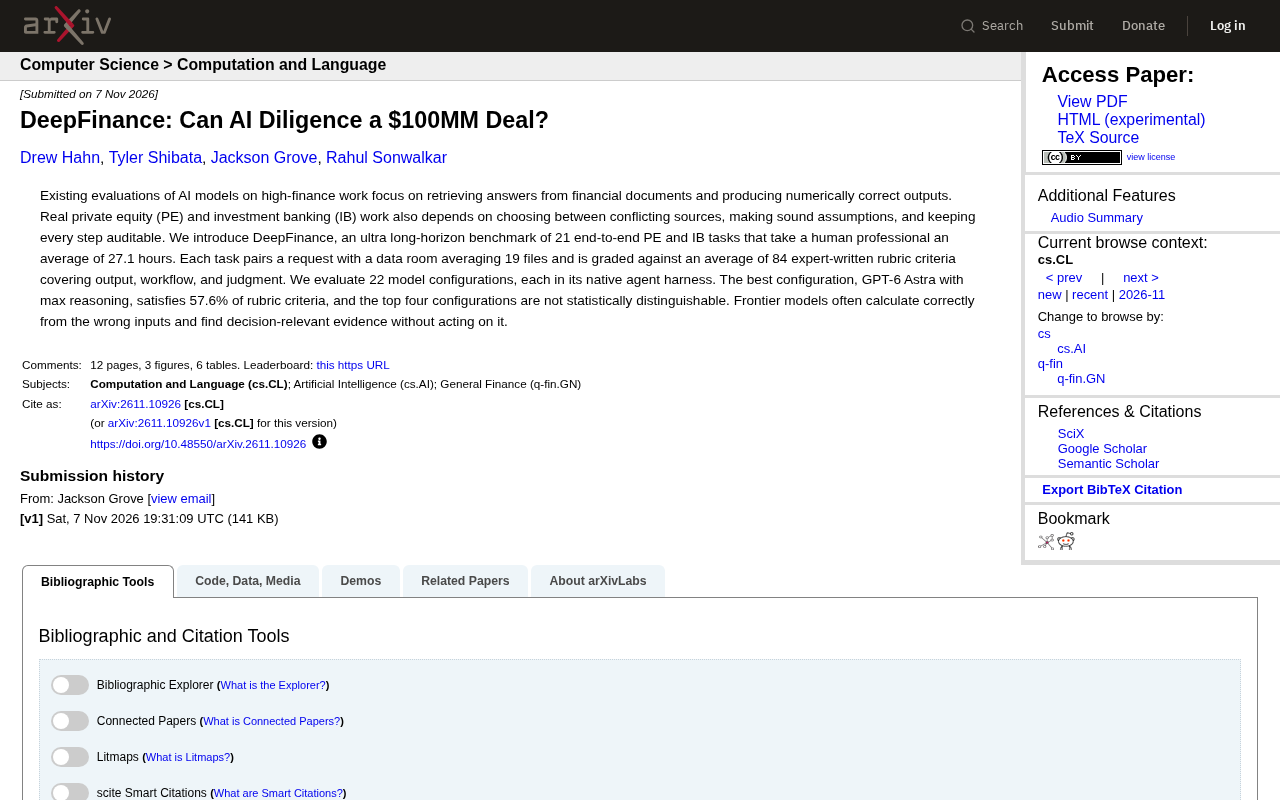
DeepFinance 基准正是为了填平这道鸿沟而设计的。它包含 21 个端到端的 PE 和 IB 任务,人类专业人士完成每个任务平均需要 27.1 小时。每个任务配有一个平均含 19 个文件的数据室,并由平均 84 条专家撰写的评分标准来打分,这些标准覆盖输出结果、工作流程和判断质量三个维度。
评测设计:长周期、多文件、重判断
DeepFinance 的“超长周期”属性是其区别于以往基准的核心。27.1 小时的平均人类耗时意味着任务不是单轮问答,而是需要持续多步操作、反复查阅数据室、并在中途做出阶段性判断的复杂工程。19 个文件的平均数据室规模,则模拟了真实交易中信息过载与信息冲突并存的常态。
评分体系同样值得注意。84 条专家评分标准并非只核对最终数字,而是把“怎么得出这个数字”纳入考核。这意味着一个模型即使最终答案碰巧正确,如果在工作流程或判断依据上站不住脚,也无法获得高分。这种设计直接回应了金融行业对可审计性的刚性需求。
Agent harness 指围绕大语言模型搭建的运行框架,负责工具调用、上下文管理、多步任务编排与中间结果保存。同一个模型在不同 harness 下表现可能差异显著:harness 决定模型能调用哪些工具(如文件检索、代码执行、表格解析)、如何切分长任务、以及何时把中间结论写回上下文。DeepFinance 让每种配置在其原生 harness 中运行,评测的因而是“模型+工具链”的整体系统能力,而非孤立模型权重。这也解释了为何工程侧编排策略与实际模型选型同样影响最终得分。
22种配置的成绩单:最高57.6%的满足率
研究团队评估了 22 种模型配置,每种都在其原生的 agent harness 中运行。表现最好的配置是 GPT-6 Astra 搭配最大推理强度,它满足了 57.6% 的评分标准。更值得玩味的是,排名前四的配置在统计上无法区分——这说明当前前沿模型在这一类任务上的能力差距,并没有排行榜上常见的名次差异那么显著。
57.6% 这个数字本身也传递了明确信号:即便是最强配置,也有超过四成的专家标准未能满足。对于动辄涉及巨额资金的 PE 和 IB 场景,这样的可靠性水平距离独立承担尽调工作仍有明显距离。
前沿模型的两种典型失败模式
论文指出了一个颇具洞察力的现象:前沿模型经常“从错误的输入算出正确的答案”,也能“找到与决策相关的证据,却不据此采取行动”。前者意味着模型的计算能力已经相当可靠,但信息甄别和假设设定环节仍是短板;后者则指向从“发现”到“行动”之间的断裂——模型可以定位关键信息,却没有把这条信息转化为后续推理或结论的一部分。
这两种失败模式恰好对应了金融尽调中最考验经验的部分:判断哪个数据源更可信,以及一条不利证据是否足以推翻整个投资逻辑。这些能力很难通过扩大检索范围或增加计算步数来自然获得。
“从错误输入算出正确答案” 在金融尽调中尤为危险,因为最终数字看似合理会掩盖上游的数据源误选或假设偏差。真实交易中,同一指标常出现在管理层报表、审计底稿和第三方数据库中,口径与时效各不相同;模型若未能识别冲突或误用陈旧数据,后续计算再精确也无法挽回结论。这类失败难以通过增加计算步数发现,需要模型具备对输入来源的溯源与质疑能力,而这正是专家评分标准中“判断质量”维度重点考察的内容。
对AI金融应用意味着什么
DeepFinance 的价值不在于给出一个分数,而在于把评测焦点从“答案对不对”转向“过程靠不靠谱”。对于正在探索 AI 辅助尽调的机构而言,这个基准提示了一个务实的定位:当前模型更适合承担信息整理、初步筛查和计算核验等辅助角色,而在需要权衡冲突信息、设定关键假设的环节,人类判断仍不可替代。
模型在原生 agent harness 中运行这一设计也值得关注。它说明评测的是“模型加工具链”的整体表现,而非裸模型能力。这意味着工程侧的编排、工具调用策略和上下文管理,与实际选用的模型同样重要。
常见问题
DeepFinance 评测的是什么? 它评测 AI 模型在私募股权和投资银行端到端任务上的表现,覆盖输出、工作流程和判断三个维度。
最好的模型表现如何? 最佳配置 GPT-6 Astra 搭配最大推理强度满足了 57.6% 的专家评分标准,前四名配置在统计上无法区分。
模型的主要短板在哪里? 模型常从错误输入算出正确结果,或找到关键证据却不据此行动,反映出信息甄别与判断转化环节的不足。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。