DeepInfer开源:单卡年入33万美元,推理框架如何颠覆AI算力经济

DeepSea开源DeepInfer推理框架,单卡年营收33万美元、毛利率最高97%,靠KV Cache落盘颠覆算力经济。
DeepSea开源自研推理框架DeepInfer,并披露大规模集群部署与单卡营收数据:每张GPU每小时营收38美元,年营收保守估计33万美元,按Token实际售价推算均价可达40万美元,毛利率在87.76%至96.94%之间,远超硬件租赁与云计算行业。其核心创新是将预填充与解码分离部署,并把KV Cache下沉到分布式存储,Agent流量缓存保留三天、聊天流量保留七天,靠计费标识绑定缓存命中,使重复预填充输入中约96%可直接跳过,大幅降低推理成本。文章同时指出RTX 50系列显卡价格全线刷新高位,算力供给瓶颈正成为推理服务商的核心壁垒,而单卡收益的确定性明显高于挖矿。
DeepInfer开源:单卡年入33万美元,推理框架如何颠覆AI算力经济
当显卡价格持续走高,AI推理的算力成本成为行业焦点。DeepSea开源推理框架DeepInfer,并首次公开单卡营收数据——每张GPU年营收保守估计33万美元,毛利率最高逼近97%。这组数字不仅揭示了AI推理的暴利潜力,更指向一场围绕KV Cache的工程革命。
显卡市场:涨价潮下的算力焦虑
据B站显卡日报,英伟达RTX 50系列显卡价格全线刷新历史高位:RTX 5080涨至16849元,甚至超越RTX 5090的建议零售价;RTX 5070 Ti、5070、5060 Ti等型号也分别涨至11188元、7349元、3849元。价格走势图显示,当前价格仍有平台补贴压制,否则中低端显卡可能再高出一两百元。
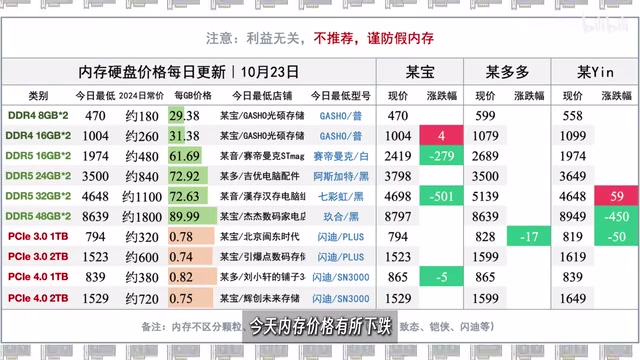
内存价格虽有小幅下跌,但底价未变,整体呈横盘状态;CPU散片价格涨跌互现,底价同样稳定。二手市场方面,闲鱼成交价一周未变,有猜测认为平台可能不再公开数据。显卡的持续涨价,折射出AI算力需求的炽热——而DeepInfer的发布,恰好为这种需求提供了一个高效率的注脚。
DeepInfer开源:把集群部署和营收账本摊开
DeepSea近期开源了自研推理框架DeepInfer,并发布《DeepSea v4.1 Flash大规模推理部署实践》一文,详细披露了集群部署方案,甚至包括每张卡每小时的营收数据。
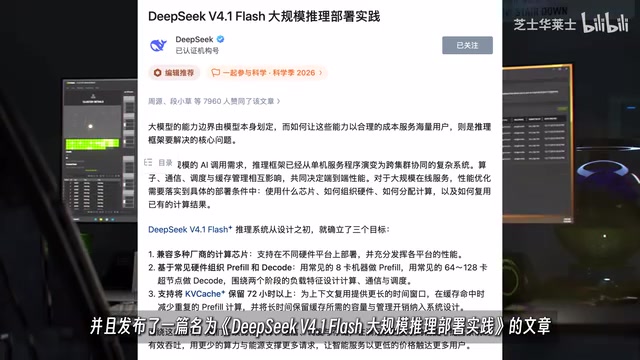
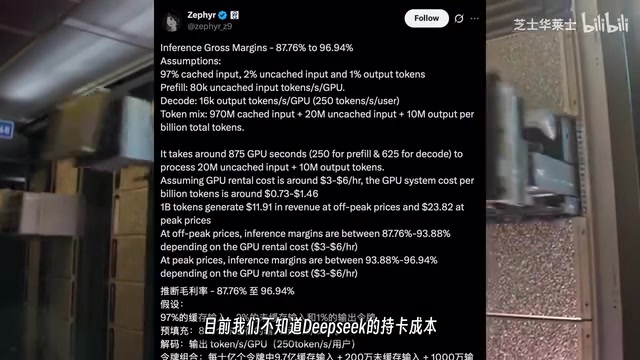
根据文章数据,即便全部按股价计算,单卡每小时营收为38美元,一年最保守营收为33万美元。但DeepSea不可能全按股价售卖Token——Token风价是股价的两倍,外界猜测单卡每小时营收均价可能在46美元左右,对应年营收约40万美元,折合人民币约267万元。这或许解释了为何“大肥鱼”会到处抢卡。
目前DeepSea的持卡成本未公开,但第三方机构估算,DeepInfer推理框架的毛利率大约在87.76%到96.94%之间。如此高的毛利率,在硬件租赁和云计算领域都堪称炸裂。
架构拆解:预填充与解码分离,KV Cache落盘
DeepInfer的核心创新在于将服务器拆分为两部分:一部分专门负责预填充(prefill),另一部分专门负责解码(decode)。这种分离式架构针对Agent类应用的特殊负载进行了优化——Agent需要反复调用工具和上下文,导致推理过程中重复预填充,严重影响效率。
DeepSea的解法是将KV Cache放在分布式存储上:Agent流量保留三天,聊天流量保留七天。当下次请求的“钱坠”(即计费标识)对得上时,直接从硬盘读取结果,跳过重算步骤。重复预填充的过程变成读取硬盘,相当于原来要重算的输入中有96%被直接跳过,推理成本大幅降低。
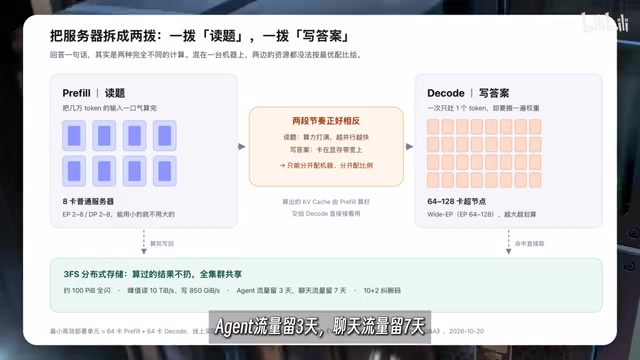
这一设计的关键在于“计费标识”与缓存命中逻辑的绑定——只有付费请求才能命中缓存,既保证了商业闭环,又避免了缓存被滥用。从工程角度看,这是将存储层级引入推理流水线的典型案例,用分布式存储换取了GPU计算时间。
KV Cache(键值缓存) 是大模型推理中的核心优化机制。Transformer 在自回归生成时,每生成一个新 token 都需要对之前所有 token 重新计算注意力,注意力计算依赖每个 token 的 Key 和 Value 向量。KV Cache 将这些已算好的 K、V 张量按层缓存在显存中,后续解码时直接复用,避免重复计算,从而把生成阶段的计算复杂度从与序列长度平方相关降为线性。代价是缓存占用大量显存,序列越长、并发越高,显存压力越大。DeepInfer 将 KV Cache 从显存下沉到分布式存储,本质上是把“显存墙”问题转化为存储带宽问题,用更大容量、更低成本的存储换取 GPU 计算时间。
预填充(prefill)与解码(decode)分离 源于两类阶段的计算特征差异。预填充阶段一次性处理整段输入 prompt,属于计算密集型,GPU 利用率高;解码阶段逐 token 生成,属于访存密集型,算力大量闲置。二者混跑会互相干扰,导致延迟抖动和资源浪费。将两者拆到不同服务器上独立调度,可以分别按各自负载配置硬件和并发策略,是当前大模型推理系统的主流优化方向之一,vLLM 的 disaggregated prefill 等方案也属于同一思路。
对比挖矿:收益确定性更高的算力生意
在这套推理框架下,单卡收益的稳定性远超当年的挖矿。挖矿收益受币价波动、难度调整和电力成本多重影响,而推理服务的收入确定性更高——需求来自真实的AI应用调用,且DeepInfer通过缓存复用进一步压低了边际成本。
对DeepSea而言,当前最大的风险可能不是需求不足,而是买不到足够的卡来满足需求。显卡涨价潮与推理框架的高毛利率形成呼应:算力供给的瓶颈,正在成为AI推理服务商的核心竞争壁垒。
DeepInfer的开源,让外界第一次能清晰看到大规模推理部署的经济账。对于想要自建推理集群的团队,这套预填充/解码分离加KV Cache落盘的架构,提供了一条可复用的降本路径;而对于整个AI行业,单卡年入33万美元的数字,或许会重新定义“算力即收入”的估值逻辑。
相关推荐
FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
FlyEnv 推出 llama.cpp 官方插件,提供多个 Metal 运行时并存管理、公共 GGUF 仓库索引与模型文件类型标注,以及上下文、线程、GPU 层数等推理参数可视化配置,支持模板与投机解码随模型保存,一键启动本地 LLM 推理服务。
前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构
从B站公开课演示的OpenClaw出发,拆解系统级AI智能体的三层架构与通用公式,分析前端开发者基于TypeScript切入Agent开发的路径、插件化设计与安全记忆层难点,附面试回答框架。
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。