#KV Cache
共 7 篇相关文章
·5 分钟
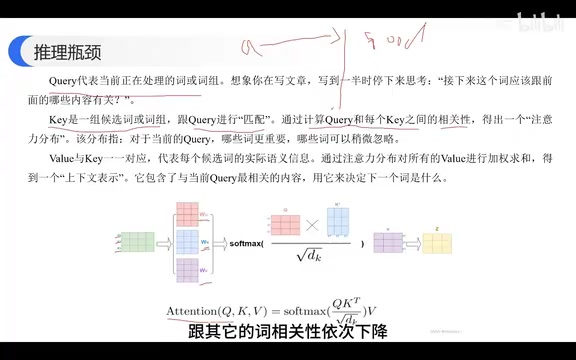
大模型推理瓶颈与KV Cache:核心机制与主流优化方案
从自注意力机制的重复计算出发,解析KV Cache如何缓存K、V矩阵加速大模型推理,并分析其显存碎片与重复存储挑战,对比vLLM、SGLang、LMDeploy的优化方案与选型建议。
阅读全文 →

·7 分钟
KV Cache 泄漏事故:Cloudflare AI 串聊 155 次的技术真相
Cloudflare Workers AI 因 KV Cache 页面未清零与跨机器交接缺陷,导致 155 次用户对话串流泄露。本文拆解 KV Cache 原理、故障链条与三方修复方案,并给出开发者可复用的缓存安全启示。
阅读全文 →
·5 分钟
KV Cache如何重塑AI Agent成本结构
解析KV Cache如何影响AI Agent运行成本:缩小缓存节省显存容量、复用前缀减少重复计算、就近存放降低传输延迟,三者节省的资源各不相同,需按瓶颈做成本归因与优化取舍。
阅读全文 →

·8 分钟
DeepSeek静默换模型:KV缓存算术才是真公告
DeepSeek静默将deepseek-flash换成V4.1-Flash-1017检查点,官方称小幅更新但基准全线上涨。本文从公开config.json出发,重算KV缓存每token成本,揭示890字节说法为何是范畴错误,并拆解50倍缓存折扣背后的定价逻辑与模型别名静默替换风险。
阅读全文 →

·4 分钟
从零实现GPT-2 KV Cache:正确性、延迟与内存实测
从零实现GPT-2 small的KV Cache并实测:logit误差6.1e-5,上下文1000时单Token延迟仅快6倍而非1000倍,内存公式72KiB/token外还有8.5MB cuBLAS workspace偏移,附多Token解码失败案例。
阅读全文 →

·5 分钟
LLM如何生成一个词:从Token到KV Cache的完整链路
从token切分到transformer注意力,从Prefill/Decode两阶段到KV Cache成本,再到LLM为何没有记忆,一文讲清大模型生成一个词的完整链路与长上下文昂贵的根本原因。
阅读全文 →
