KV Cache 泄漏事故:Cloudflare AI 串聊 155 次的技术真相

Cloudflare 因 KV Cache 未清零与交接协议缺漏,导致 155 次用户对话串流。
文章复盘了 Cloudflare Workers AI 在 8 月 27 日至 9 月 9 日间发生的 155 次对话串流事故。触发条件是提示词超过 681,000 个 token,根因是 page pool 容量小于模型一百万的上下文窗口,且缓存页归还时从不清零。当超长提示词到达时,Prefill 判定超出容量并替换为单 token 占位符,但跨机器交接协议只检查任务是否完成、不检查是否被拒绝,Decode 遂按原计划读取八页,其中七页属于上一位用户,导致对方提示词与半截答案被加工成通顺回复返回。修复包括池子扩容、SGLang 0.5.22 入口拦截,而页面清零因性能代价仍停留在草稿阶段。文章由此引出对缓存所有权、跨组件契约与性能取舍的工程启示。
一个让 AI「串聊」的缓存 Bug
把整个代码库粘贴进 AI 对话框,按下发送,回来的答案却流畅地讲着别人的项目、别人的提示词,甚至还带着对方答案的后半截。这不是科幻情节,而是 Cloudflare Workers AI 上真实发生的事故。据 YouTube 频道 Frame by Bytes 的复盘,Cloudflare 官方确认这类事件在 8 月 27 日至 9 月 9 日之间共发生 155 次,触发条件高度一致:提示词长度超过 681,000 个 token。没有黑客入侵,没有密码泄露,罪魁祸首只是一个缓存。
这个故事的科普价值在于,它把大模型推理中最不起眼、却最关键的组件——KV Cache——推到了台前。理解它,才能理解为什么一次「缓存没清干净」会直接变成一次数据泄露。
KV Cache 到底是什么:旅馆前台的那本便签
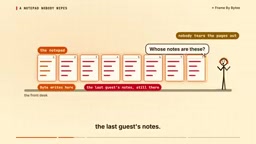
视频用了一个很形象的比喻:旅馆前台有一本便签,每位客人分到几页纸,写完后交还,但没人会把写过的页面撕掉。下一位客人入住,从第一页开始写,翻看时却把后面几页旧内容也读了进去——那些正是上一位客人留下的笔记。
这本便签就是 KV Cache。模型每读入一个 token,就会计算出一组 key 和 value,存入 GPU 显存,供生成后续内容时复用,避免每次重新「读一遍」整段对话。它存在的理由很实际:读提示词是推理中最慢的环节之一。UP 主在自己的笔记本上用小型模型做了对照实验,读入一篇长文档后,保留缓存再追问一个问题,响应速度相比丢弃缓存重新计算有数量级的提升。缓存保住了,速度就保住了;缓存丢了,等于每次都要从头读起。
Token 与上下文窗口
要理解 KV Cache 的容量问题,需要先明确 token 和上下文窗口这两个概念。token 是模型处理文本的基本单位,一个英文单词可能被切成一到多个 token,一个汉字通常对应一至两个 token。模型并不能一次性「看见」无限长的文本,它被训练时约定了一个最大处理长度,即上下文窗口(context window)。当输入超过这个长度,模型要么截断,要么报错。
关键在于,上下文窗口是模型的逻辑上限,而 KV Cache 的容量是硬件的物理上限。二者的关系类似「说明书上写着最多载重 1 吨」和「这辆车的车厢实际只有 0.7 吨容积」——规格与实现并不自动对齐。本文事故的根源正是这两个数字被人为地分开设定:模型窗口设为一百万 token,而 page pool 只有约 681,000 token。理解这一点,才能明白为什么「提示词合法却装不下」不是矛盾,而是配置层面的疏忽。
故障链条:池子装不下,页面却没清
所有请求共享同一块 GPU 显存。模型权重占据大头,剩下的部分被切分成「页」,构成所谓的 page pool。据视频披露,Cloudflare 机器的池子容量约为 681,000 个 token,但模型被告知可以处理一百万个 token 的上下文窗口。于是出现了一个致命的缝隙:提示词可以塞进模型的窗口,却塞不进缓存的池子。而页面在归还时从不清零,下一个请求直接覆写。
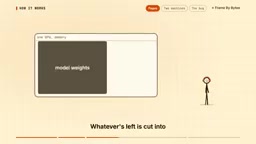
在这个规模下,单台机器已经扛不住,请求被拆分到 Prefill 和 Decode 两个环节。Prefill 负责读入提示词、填充页面;Decode 逐 token 生成答案,页面通过网络在两者之间传递,路由器会提前告诉 Decode 需要预留多少页。
事故就发生在这个交接协议上。当 Byte 的超长提示词到达时,Prefill 判定它超出池子容量,标记为拒绝,并把提示词替换成一个单 token 的占位符。如果只有一台机器,这会直接返回 400 错误。但跨机器交接时,Decode 只问了「任务是否完成」,从未询问「任务是否被拒绝」。于是 Decode 按原计划预留了八页,Prefill 只发来一页占位符,Decode 却把八页全读了——其中七页属于上一位用户,带着对方的提示词和写了一半的答案。模型把这些残留内容加工成一段通顺的回复,还附上了 200 OK 的状态码。
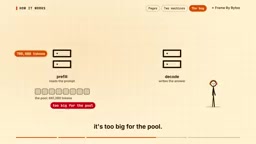
这里的技术教训相当清晰:状态码 200 从来不等于内容正确。当系统在分布式组件之间传递状态时,任何未被显式检查的「隐含假设」都可能成为漏洞的入口。
Prefill 与 Decode 的分工
大模型推理通常分为两个阶段。Prefill(预填充)阶段把用户输入的整段提示词一次性读入,并行计算所有 token 的 key 和 value,写入 KV Cache;这个阶段计算密集、耗时随输入长度线性增长。Decode(解码)阶段则逐个 token 生成回答,每生成一个 token 都要读取之前所有 token 的 KV 缓存,因此是访存密集型。
把两个阶段拆到不同机器上,可以让 Prefill 机器专心处理长输入、Decode 机器持续产出,从而提升整体吞吐。但这种拆分引入了网络传输和状态同步问题:Decode 机器必须提前知道要为哪些页面预留空间,而这一信息完全依赖 Prefill 的告知。一旦告知内容不完整——比如只说了「完成」却没说「被拒绝」——Decode 就会按错误的预期读取内存,这正是 155 次串聊事故在架构层面的成因。
三方修复:池子扩容、入口拦截、清理仍是草稿
Cloudflare 的修复分为三步。第一,把 page pool 扩容到超过模型上下文窗口,从根本上消除「装得进窗口、装不进池子」的错配。第二,推理引擎 SGLang 在入口处就拒绝超长提示词,在预留任何页面之前完成拦截,这一改动随 0.5.22 版本发布。第三,在页面归还时执行清零——但截至视频发布,这一项仍停留在草稿阶段。
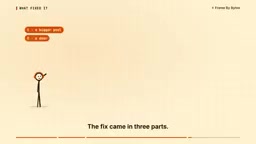
第三项迟迟不落地,原因直白得有些残酷:清零要付出速度代价,而速度正是缓存存在的全部意义。安全与性能在这里形成了真实的张力,这不是某个团队疏忽,而是整个技术路线的结构性取舍。
SGLang 是什么
文中提到的 SGLang 是一个开源的大模型推理引擎,专注于高吞吐、低延迟的服务端部署,其核心特性之一就是基于分页(paged)的 KV Cache 管理,思路借鉴了操作系统的虚拟内存分页。它把显存切成固定大小的页,按需分配给不同请求,从而支持长上下文和并发批处理。
正因为 SGLang 掌管着页面的分配与回收,修复才落在它身上:0.5.22 版本在入口处增加了长度校验,使超长提示词在预留任何页面之前就被拒绝。这也说明一个工程规律——缓存的生命周期管理应当由负责分配的那一层统一收口,而不是散落在多个组件的隐含约定里。理解 SGLang 的定位,有助于判断这类修复为何选择在该层落地,以及清零为何会因为改动推理热路径而迟迟难以推进。
对开发者的启示:缓存是别人的记忆
Frame by Bytes 在结尾给出的建议适用于所有写代码的人:无论你操作的是 GPU 里的 KV Cache,还是自己应用中的任何缓存,都要记住它的本质——那是别人刚刚用过的内存。在读取一页之前,先确认这页归谁所有。
从工程视角看,这起事故值得反复咀嚼的地方有三层。其一是生命周期管理:缓存的分配、复用、回收必须有明确的所有权边界,而不是依赖「大概率会被覆盖」的侥幸。其二是跨组件契约:Prefill 与 Decode 之间的接口只传递了「完成」而遗漏了「拒绝」,这类信息缺失在单体架构中无伤大雅,在分布式架构中却直接导致数据串流。其三是对性能的警惕:任何以速度为名省略的清理步骤,都会在某个时刻以安全事件的形式回来讨债。
对于普通用户,这起事件也提供了一个判断依据:当你使用托管式 AI 服务时,你的提示词长度、内容是否可能触及底层资源的容量边界,并非完全不可感知的风险。服务商的容量规划与隔离机制,直接决定了你的数据会不会出现在陌生人的对话框里。
常见问题
KV Cache 泄漏会泄露哪些内容?
根据这起事故的复盘,泄露的是上一位用户的提示词以及已经生成的部分答案,二者都以缓存页的形式残留在显存中,被下一个请求误读。
为什么只在超长提示词时触发?
因为只有提示词超出 page pool 容量时,Prefill 才会触发拒绝流程并替换为占位符,而跨机器的交接协议恰好没有检查这个拒绝状态,导致 Decode 读取了超出实际发送量的页面。
普通用户该如何看待这类风险?
这类事故的根因在服务端架构,用户侧无法直接防范。可行的做法是关注服务商的事故披露与修复进度,并对敏感内容的上传保持审慎。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。