DeepSeek Harness实时压缩插件Live-Compact开源解析

开源插件Live-Compact用每2万Token小切片替代80%阈值大压缩,将压缩耗时降至毫秒级。
B站UP主开源了DeepSeek Harness插件DSH Live-Compact,针对现有Harness在上下文80%阈值触发强制压缩带来的延迟、信息漂移和频繁触发问题,提出“边做边压”思路:每2万Token按预设规则切一刀,不调用模型和工具,仅处理当前切片并保留切点前原文以维持缓存命中。短任务测试中费用从1.5元降至1.15元,全程未触发强制压缩;长任务中压缩耗时从14秒降至74毫秒,上下文较原版减少约40%。插件仍存在摘录文件持续增长、非代码场景缺乏验证等不足,UP主主张Harness层优化与模型效率同等重要。
在Agent应用日益普及的当下,上下文管理正成为影响效率与成本的关键环节。B站UP主在其最新分享中开源了一款名为DSH Live-Compact的DeepSeek Harness插件,核心思路是"边做边压"——用高频、轻量的小切片取代传统的一次性大压缩。这款插件没有复杂的技术栈,却试图解决一个长期困扰用户的痛点:"雷霆大压缩"带来的延迟、漂移与频繁触发。
为什么现有压缩机制让人头疼
UP主从自身使用多个Harness的体验出发,指出一个普遍现象:无论是Claude、Codex还是Grok,都写死了一个压缩阈值,通常在上下文使用到80%左右时触发强制压缩。这种设计在模型推理速度较快时问题不大,但一旦切换到本地部署的27B模型,256K上下文的一次压缩可能耗时数分钟——UP主将其形容为"雷霆大压缩"。
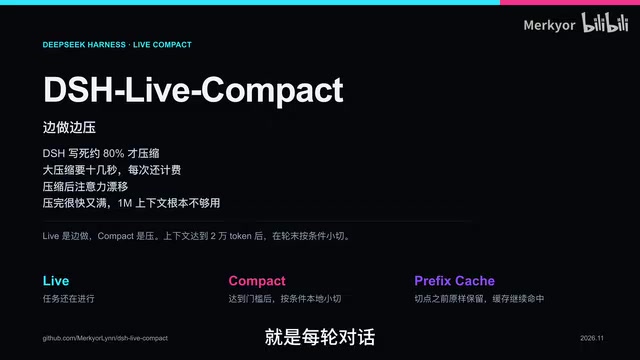
压缩后的信息漂移同样棘手。即便模型足够聪明,压缩过程中丢弃的信息是否有用,用户无从判断。更麻烦的是压缩后的上下文很快又会填满:在长任务测试中,原版Harness跑到第15轮左右就触发压缩,压到15万Token后又在20轮附近回到50多万,很快面临再次压缩。UP主希望找到一种方法,让压缩在上下文增长时不再如此频繁地出现。
上下文窗口与压缩阈值:大语言模型的上下文窗口指单次请求中可容纳的最大 Token 数(如 256K、1M)。由于显存和计算成本随 Token 数增长,模型厂商和 Harness 通常会在使用量接近上限时触发压缩,把历史对话摘要成更短的文本。80% 阈值是工程折中——留出余量给后续几轮交互,避免请求直接溢出。但阈值一旦写死,压缩时机就与任务节奏脱钩:长任务可能在第 15 轮就撞线,而短任务却永远用不到压缩。
解决方案:每两万Token切一刀
Live-Compact的规则可以用一句话概括:每达到20,000 Token就按预设条件切一刀。这个数字并非随意设定,而是UP主经过实践验证的折中点——足够小以保持压缩的轻量,又不会频繁到影响任务执行。
与传统方案最大的区别在于,不调用模型、不调用工具、不拆开结果。UP主特别提到,有B站小伙伴指出其他插件会调用模型去读摘要再写摘要,他认为这完全没有必要:"如果模型自己能写摘要,我干嘛还要再去读一下呢?"这种做法在代码场景中尤其明显——代码片段本身结构明确,完全可以用摘录规则替代模型生成,从而将压缩耗时降到毫秒级。
缓存命中是另一个关键考量。插件只处理当前切片片段,切点前的用户消息和最终回答保持原样,原文的字节内容也不做改动,后续请求可以直接复用相同前缀。UP主表示,实测下来缓存命中率与原版Harness基本一致,对DeepSeek广告本身的省钱特性没有造成破坏。
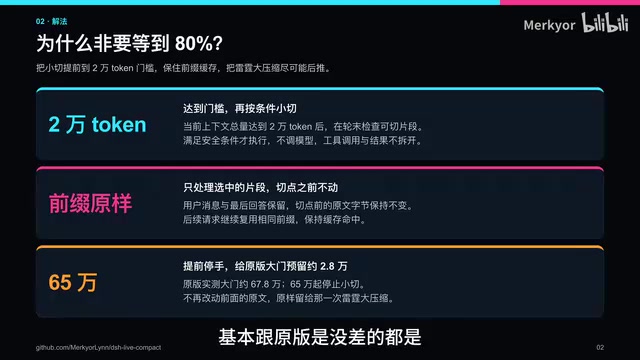
关于65万这个数字,UP主解释在100万上下文场景下,压缩点大约在67.8万左右,留出约二点几万的余量给原有的强制压缩机制,避免把重要内容误切。
KV Cache 与前缀缓存:在 Transformer 推理中,已处理 Token 的键值对会被缓存(KV Cache),后续请求若前缀相同即可直接复用,避免重复计算。DeepSeek 等 API 按缓存命中与未命中分别计费,命中价格显著更低。因此压缩机制若改动了切点前的原文,就会导致缓存失效、费用上升。Live-Compact 只处理当前切片、保留切点前字节不变,正是为了维持相同前缀,让缓存继续命中。
测试结果:短任务与长任务的双重验证
UP主选取了开源基准中的150道短任务代码题(涵盖Python、Go、Java、Rust等语言)和20道长任务代码题进行对比测试。
短任务方面,原版与插件版均通过全部题目。从缓存命中量看,插件版明显更低,因为一直在进行小切片;未命中量也相应减少,费用从一块五降到一块一毛五。上下文峰值方面,原版最高达到670,已经历过一次约12.8秒的压缩,而插件版为589,全程未触发强制压缩——切了145刀,累计压缩时间仅2.2秒。任务总耗时上,两者分别为8500秒和6000秒,UP主谨慎表示这可能是单次测试的波动,但从逻辑上分析,持续保持干净的上下文有助于模型输出更简练的结果。
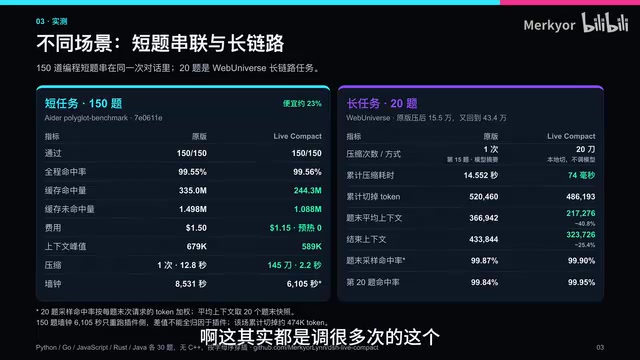
长任务测试选取了WebUniversal中20道最长的题目,均为需要多次调用工具、数十轮交互的复杂场景。原版Harness仅压缩一次,耗时14秒;插件版切了20刀,压缩耗时74毫秒,差距达到两个数量级。如果换成27B模型,这种差异会更加显著。上下文方面,原版在题末平均上下文为36万,结束上下文已达43万,按此节奏很快需要再次压缩;插件版平均上下文21万,比原版少约40%,结束上下文32万,少约25%。缓存命中率两者均保持在99%以上,插件版在最后一题时仍维持高位。
UP主由此引申出一个观点:解决模型效率不应只靠模型本身,Harness同样重要。"既然要搞效率,就把这个事搞彻底。"
Token 计量与成本口径:文中“一块五降到一块一毛五”“上下文 670 与 589”等数字,均以 Token 为计量单位。缓存命中量指请求中复用 KV Cache 的 Token 数,未命中量则需重新计算并计费。上下文峰值反映单次请求携带的历史长度,直接决定显存占用和延迟。理解这些口径有助于判断:插件版费用下降并非因为任务变简单,而是小切片让每次请求携带的历史更短、缓存复用更充分。
未完成的部分与开放思路
Live-Compact目前存在一个明显缺陷:由于持续切片,压缩后的摘录被存放在单独的查看目录下,而非像原版那样直接替换对话日志中的对应段落。150道短任务切了145刀后,摘录文件约2.6兆,且只增不减。UP主坦言这不是大问题,但长期增长仍需解决,暂时留给社区小伙伴发挥。
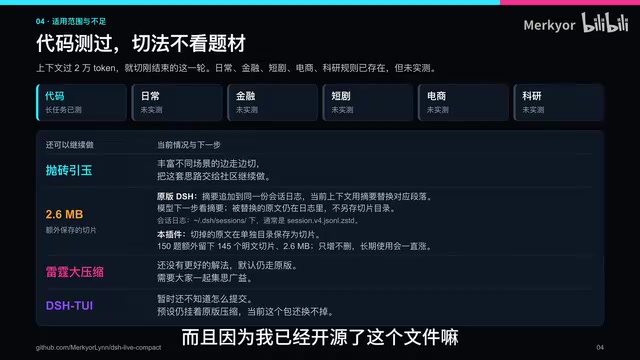
另一个未解难题是模型的"雷霆大思考"与Harness强制压缩之间的共存。UP主研究后未找到能同时保持缓存命中率的方案,最终决定不修改原版压缩机制,只是将其推迟触发。
测试集覆盖的局限性也被如实说明:UP主只有代码测试集,日常对话、金融、电商、科研等场景的规则虽已编写,但缺乏对应数据验证。由于文件已开源,用户可以根据自身场景调整规则。UP主将自己的角色定位为"炮车运营"——开出一条路,大家觉得合适就走一走。
编辑观察
Live-Compact的价值不在于技术复杂度,而在于问题视角的转换:与其优化一次大压缩,不如让压缩消失在日常操作中。这种思路与模型后训练中追求Token效率的方向一脉相承,也呼应了Agent工程中一个容易被忽视的事实——Harness的设计对最终成本和体验的影响,可能不亚于模型本身。当然,摘录文件的持续增长、非代码场景的验证缺失,以及强制压缩机制的未能替代,都是这款插件走向成熟需要跨越的台阶。
相关推荐

9家AI订阅套餐积分换算:每亿Token真实成本揭秘
B站UP主实测火山、阿里、腾讯、百度、智谱、小米、MiniMax等9家AI订阅套餐,统一换算每亿Token真实成本,拆解固定额度与三档系数两类计费逻辑,揭示缓存、时段折扣和窗口限额对实际额度的影响。

Vibe Coding入门:用意图表达代替手写代码
Vibe Coding 是什么?B站137集实战课程给出定义:核心不是写代码而是表达意图。本文解析 Vibe Coding 的生产力逻辑、适合人群与入门预期,帮助零基础者判断是否值得投入学习。
LangChain入门指南:从LangGraph到Deep Agents的智能体开发路线
理清LangChain、LangGraph和Deep Agents的封装关系,掌握智能体开发框架的学习路线与选型逻辑,适合大模型开发入门者参考。