DeepSeek Harness是什么?模型外的一切工程层

DeepSeek Harness是模型之外的工程系统,以一切皆插件的方式驾驭Agent能力。
文章围绕DeepSeek发布的Harness开发预览版展开,澄清它既不是新模型也不是普通客户端,而是模型之外的一整套工程系统,涵盖系统提示词、工具调用、文件系统、沙箱、记忆、上下文管理、约束机制与编排逻辑。文章借用"马具"隐喻说明其定位:模型负责判断,Harness负责其余一切。在架构上,Harness主张"一切皆插件",模型、工具、技能、沙箱、存储、循环、UI均可自由替换组合,一条命令即可安装并同步开源。文章还讨论了四种运行模式对任务复杂度的适配意义、记忆系统在长任务中的关键作用,以及开源Agent工程层对生态的价值。作者提醒,开发预览版接口仍可能变动,现阶段适合探索验证,不宜直接用于生产环境。
自DeepSeek发布Harness开发预览版并同步开源代码以来,围绕这个新概念的讨论就没有停过。有人把它当成又一个客户端,有人以为它是新模型。如果你也有类似的困惑,这篇文章或许能帮你把这件事讲清楚。
从"马具"这个隐喻说起
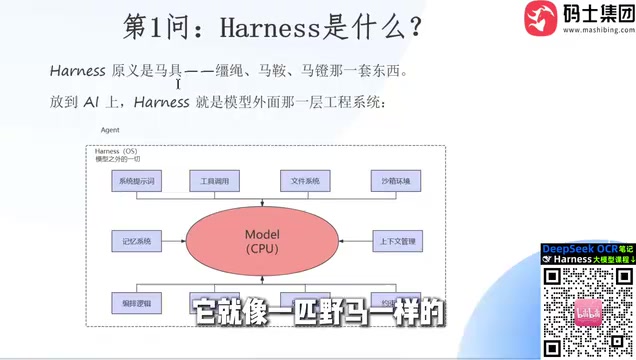
Harness这个词的原意是马具——缰绳、马鞍、马灯这一整套装备。B站UP主在视频里的解释很形象:AI大模型能力再强,使用起来也像一匹未经驯服的野马,必须在它身上套上缰绳和马鞍,才能让它按人的意图去跑。
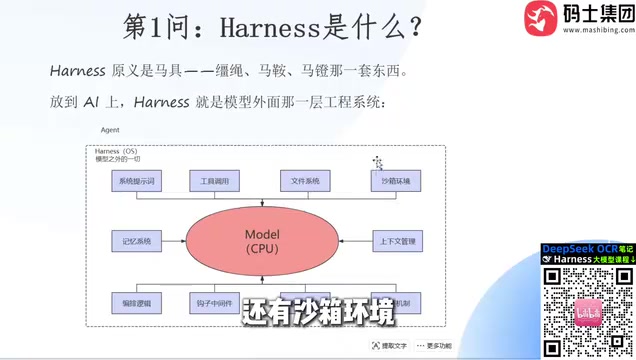
放到AI语境里,Harness指的就是模型之外那一层工程系统。它不负责"思考",而是负责让模型的思考变得可控、可落地。视频里给出的定义相当完整:系统提示词、工具调用、文件系统、沙箱环境、记忆系统、上下文管理、约束机制、反馈回路、钩子中间件、编排逻辑,这些统统属于Harness的范畴。
一句话概括:模型负责判断,Harness负责剩下的一切。
**Agent(智能体)**是理解Harness的前提概念。Agent指由大模型驱动的、能够自主感知环境、制定计划、调用工具并执行多步任务以达成目标的软件系统。与传统问答式调用不同,Agent的核心特征是"自主性"和"多轮循环":它根据任务目标自行决定下一步动作,观察执行结果,再决定是否继续或调整。这也解释了为什么Agent需要Harness——模型提供推理与决策能力,而从工具调用的格式约定、执行结果的回传、失败后的重试,到上下文的裁剪与记忆的持久化,都需要外部工程层来承载。没有Harness,模型只是一个被动的文本生成器;有了Harness,模型才能被组织成一个可运行、可观测、可约束的Agent。
面试场上的一道好题
UP主发起这一连串追问,起因是这类概念在面试中越来越常见。遇到"什么是Harness"这样的问题,能答出"模型之外的一切东西",基本就抓住了要点。
这个回答之所以成立,是因为它划清了一条边界。过去几年里,围绕大模型的很多工程创新——提示词工程、检索增强、Agent框架、工具链——本质上都在填充模型与真实任务之间的缝隙。Harness把这片缝隙正式命名为一个工程层,意味着它不再是零散技巧的堆砌,而是一个有明确职责范围的系统组件。
对开发者来说,这个视角的转换很有价值:当你不再把模型当作全部,而是把模型当作系统里的一个判断单元,很多设计决策会变得清晰起来。
一切皆插件:Harness的架构思路
Harness开发预览版提出了一个明确的设计理念——"一切皆插件"。模型、工具、技能、沙箱、存储、循环、UI等Agent所需的能力,全部由插件组成,可以自由替换、灵活组合。
这个思路的工程意义在于解耦。传统做法里,Agent的能力往往和框架深度绑定,换一个模型就要重写一遍调用逻辑,加一项工具就要改一遍核心代码。插件化之后,每一块能力都是可插拔的单元,替换模型或增删工具不再牵动全局。
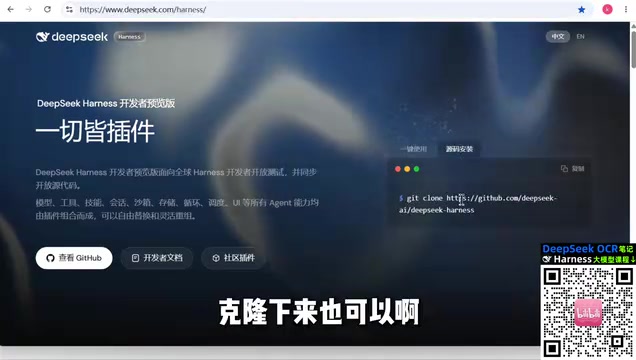
据UP主演示,安装只需一条命令即可一键完成,想研究源码的话也可以直接从代码托管平台克隆下来。面向全球开发者开放测试并同步开源代码,这个姿态说明DeepSeek广告希望Harness成为生态的基础设施,而不是自家产品的附属功能。
**工具调用(Function Calling / Tool Use)**是Agent运行的关键机制,也是Harness最核心的职责之一。其基本流程是:系统向模型描述一组可用工具(名称、功能、参数Schema),模型在推理后输出结构化的调用请求,Harness解析该请求、实际执行对应函数(如读写文件、发起网络请求、运行代码),再把执行结果作为新消息回传给模型,进入下一轮循环。这个机制把模型的语言能力与外部世界连接起来,但也带来了一系列工程问题——参数校验、超时控制、错误处理、权限与安全边界、调用次数与成本限制,这些都不由模型负责,而由Harness统一处理。插件化设计正是为了让这些工具可以按需注册、替换和组合,而不影响主循环逻辑。
四种运行模式的看点
视频标题提到Harness有四种模式,原始内容里没有逐一展开细节。从Agent工程的通用范式推断,这几种模式大概率对应不同的任务复杂度与自动化程度——有的偏向单轮问答式的轻量调用,有的偏向多步任务编排,有的涉及沙箱环境下的代码执行,有的则强调记忆与上下文的持续维护。
具体模式的定义,建议以官方文档和源码为准。这里想强调的是模式划分本身透露的信息:Harness并不假设所有任务都长一个样。轻量任务用重编排是浪费,复杂任务用轻调用又撑不住。把运行模式显式地区分开,是一种务实的工程取舍。
记忆系统在截图里被单独点名,也值得留意。上下文管理一直是Agent落地的难点,记忆的写入、检索、淘汰策略直接决定了一个Agent能不能在长任务中保持连贯。
**沙箱(Sandbox)**是Agent执行代码与操作文件时的隔离环境,在Harness体系里承担安全兜底的角色。大模型生成的代码或命令无法保证绝对正确,直接在生产主机上执行可能造成数据损坏、越权访问甚至安全漏洞。沙箱通过容器、虚拟机或受限进程等方式,为执行提供一个隔离的、可回滚的、资源受限的空间:文件系统与宿主隔离,网络访问可被限制,CPU、内存、运行时长可设上限,异常退出不会波及外部系统。对Harness而言,沙箱既是能力(让Agent能真正运行代码、验证结果),也是约束(把风险控制在边界之内),这正是"模型负责判断、Harness负责其余一切"这一定位在安全维度的具体体现。
开源生态意味着什么
Harness以开发预览版的形式开源,对国内大模型生态是个值得关注的信号。开源Agent工程层,意味着第三方开发者可以在此基础上构建自己的插件生态——工具插件、技能插件、UI插件都可能长出独立的社区项目。
这和模型开源是两回事。模型开源交付的是能力,Harness开源交付的是驾驭能力的方法论和基础设施。前者决定上限,后者决定下限:同样一个模型,套上成熟的Harness,实际可用性会明显不同。
当然,开发预览版意味着接口和设计还可能变动,现阶段更适合探索和验证,不建议直接押注到生产环境。
小结
回到最初的问题:DeepSeek Harness不是模型,也不是普通意义上的客户端,而是模型之外那一层工程系统。它把提示词、工具、记忆、沙箱、编排这些原本零散的工程要素收拢成一个可插拔的整体,用"一切皆插件"的方式降低替换成本。理解了这条边界,你也就理解了Agent工程当前正在往哪个方向走。
相关推荐
Cursor、Devin、TRAE、Copilot价格怎么比?先算额度再比月费
横向对比Cursor、Devin Desktop、TRAE、Copilot四家AI编程工具的个人与团队定价,拆解额度规则、第三方模型是否含在月费、超额计费方式,并给出付费前测消耗、设支出上限和选型的实操方法。
Copilot下架三款模型:Pro用户替代选择只剩一个
GitHub Copilot 自 11 月 16 日起下架 Claude Opus 4.8、Claude Opus 5、GPT-5.6 Tera 三款模型,覆盖 Chat、代码补全与 Agent 模式。Pro 用户三个替代中仅剩 GPT-6 Luna 可用,年付 Legacy 计划拿不到 Opus 5.5,管理员需手动开启替代模型。

Gemini 4 Carbon登场:大模型竞赛进入百万上下文与万亿开源时代
谷歌发布Gemini 4 Carbon并推出多智能体工具Swarm,Anthropic推出百万上下文Fable 5.2与Mythos 5.2,OpenAI发布安全专版GPT-6 Cyber,Mistral与Kimi同步开源万亿参数模型,大模型竞赛全面提速。