DeepSeek V4.1 Flash 实测:小尺寸新架构能否问鼎开源
DeepSeek V4.1 Flash以新MoE编解码架构大幅降低KV缓存,用极低成本实现远超上代的生成能力。
DeepSeek V4.1 Flash是一次被低调命名掩盖的架构创新:总参约5520亿的MoE模型,输入侧仅激活80亿参数、输出侧160亿,并通过新架构大幅压缩KV缓存占用,使长上下文推理的显存成本趋于平缓。模型权重已开源至Hugging Face,定价低至输入0.30美元/百万token。实战测试中,它以全程约5.9美元完成了BrowserOS交互界面、多款游戏demo、可3D打印发动机模型及高质量手表渲染网站等高难度任务,3D生成能力尤为亮眼。短板集中在多模态视觉处理和真实机械臂控制任务,本地运行可行性也有待验证。整体而言,它将"小活跃参数、大生成能力"的边界又向前推进了一步,是开源模型性价比领域值得关注的新选项。
一次值得关注的架构升级
DeepSeek 悄然放出的 V4.1 Flash,从命名上看只是此前 Flash 系列的迭代,但从实际规格来看,它更像是一次全新的架构尝试。这次测试的 UP 主直言,它"根本就是个新模型——新架构、新尺寸、价格超便宜",甚至认为叫 V4.5 都不为过。
模型采用 Mixture-of-Experts(MoE,混合专家)结构,总参数量约 5520 亿,采用编解码(encoder-decoder)架构:输入侧激活约 80 亿参数,输出侧约 160 亿参数。这种设计让人联想到 2019 年谷歌推出的 T5——同样是 encoder-decoder 结构的 Transformer 家族,如今这种老思路在超大模型上被重新激活,颇有"旧瓶装新酒"的意味。
与体量对比来看,它相较动辄 2.8 万亿参数的同期竞品(如视频中提到的 Kimi K3 级别)要小得多,但作者认为其性能"比 Waste Pro(上一代 Flash Pro)强多了,虽然体积更小",这一点是本次测试最令人兴奋的部分。
Mixture-of-Experts(MoE)是一种将模型划分为多个"专家"子网络的架构,每次推理时只激活其中少数几个专家,而非全部参数。这种设计的核心优势在于:模型的"总参数量"可以做得很大(覆盖更广泛的知识),但每次前向传播的"激活参数量"却远小于总量,从而大幅降低单次推理的计算成本。Google 的 Switch Transformer(2021)和 Mistral 的 Mixtral 系列是 MoE 在大语言模型领域的典型代表。V4.1 Flash 将 MoE 与 encoder-decoder 架构结合,输入侧和输出侧分别激活不同规模的参数(约 80 亿与 160 亿),这种非对称设计在主流开源模型中较为少见,理论上可以让模型在理解长输入时付出更少算力,在生成时保持较高表达能力。
核心亮点:KV 缓存大幅降低与长上下文
UP 主反复强调的一个技术点,是新架构下 KV 缓存的显著减少。KV 缓存是大模型推理时占用显存的主要来源之一,缓存越大,处理长上下文的成本越高。
视频中展示的图表显示,随着上下文变长,V4.1 Flash 的内存占用增幅越来越平缓——换句话说,"不用那么多内存,就能处理更长的 context"。这意味着在同等硬件条件下,它能以更低的资源成本支撑更长的输入窗口,对实际部署是实打实的好处。
另一个关键细节是所谓的"记忆参数"。作者在 Hugging Face 上翻查模型文件时发现,有一部分参数(约 1960 亿量级的记忆相关部分)明显比模型其他组件大得多。理论上,这部分参数可以卸载(offload)到 CPU 内存,甚至通过高速 SSD 直接从硬盘读取,而不必全部塞进 GPU 显存。这为在"贵一点的业余级设备"上运行大模型留下了想象空间——作者甚至设想用两台 DGX Spark 就能跑起来,尽管本地运行的可行性仍需验证。
KV 缓存(Key-Value Cache)是 Transformer 模型在自回归推理时的核心机制:模型每生成一个 token,都需要访问此前所有 token 的 Key 和 Value 向量,为避免重复计算,这些向量会被缓存在显存中。问题在于,缓存大小与上下文长度成线性关系——处理 100K token 的长文本时,KV 缓存可能占据数十 GB 显存,严重限制了批处理能力和实际部署规模。降低 KV 缓存的常见技术手段包括多查询注意力(MQA)、分组查询注意力(GQA)以及滑动窗口注意力等。V4.1 Flash 通过新架构实现缓存占用随上下文增长趋于平缓,意味着它可能采用了更激进的注意力压缩或记忆分离策略,这对需要处理长文档、长对话的生产场景具有直接的成本意义。
价格与可用性:开源且便宜
这次发布最实在的一点是价格和开放度。模型权重已第一时间上传至 Hugging Face,采用宽松许可证,没有拖延发布。
定价方面,即便按最贵档位计算,输入每百万 token 约 0.30 美元,输出每百万 token 约 1.20 美元,在同级别模型中相当有竞争力。此外,它"天生支持多模态",能够看图——这是此前 DeepSeek 模型(包括 Vision 实验版)所欠缺的能力,尽管本次测试因框架配置问题未能完整验证图像输入。
39 分钟实战:从 BrowserOS 到 3D 建模
作者用一套代号 Deep-C Karnas 的测试框架(V2.7),在最高难度模式下让模型完成一系列高强度生成任务,全程花费仅约 3 美元左右,整体成本控制得相当出色。
交互式应用生成
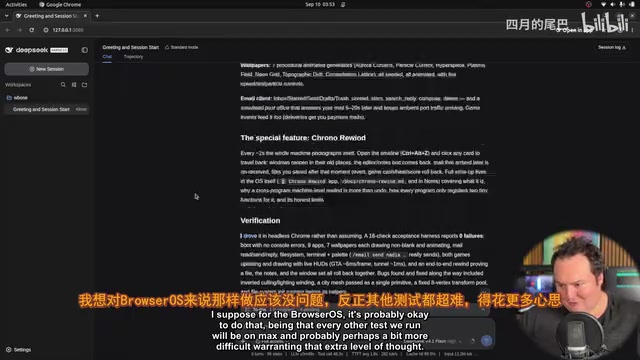
第一个任务是生成 BrowserOS——一个浏览器内的模拟操作系统。仅花费 0.25 美元,模型就产出了包含多个可交互应用的界面:可回放的时间轴、音效模拟、网络设置、随机地形与星座网格壁纸、粒子前景等自定义功能一应俱全。作者评价"总体挺不错的,毕竟没用什么特殊工具"。
游戏与物理模拟
模型还尝试生成了 GTA 克隆版(含行走动画、高密度 NPC、可投掷炸弹)、滑板/特技游戏(X Games 风格的 U 型池物理模拟)、地铁 FPS 射击(受伦敦地铁标识启发)等。这些 demo 虽有显示瑕疵——比如 NPC 疯狂奔跑、行人行为怪异——但基本都能运行、能玩,考虑到成本已属难得。
机械臂视觉控制的短板
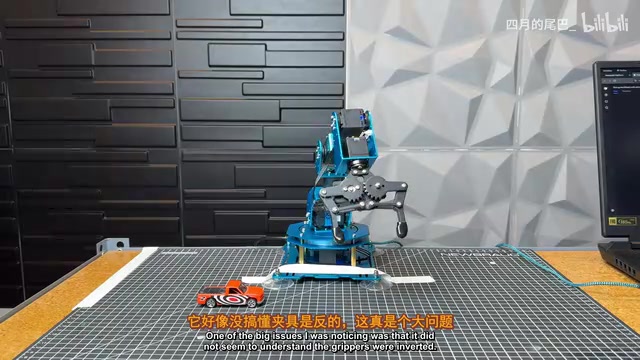
并非所有测试都顺利。一项要求模型通过摄像头画面控制机械臂、把橙色小车搬到平台另一侧的任务,耗时 45 分钟仍未成功。作者认为主要瓶颈在"视觉处理"而非模型智能本身——相机曝光固定失败、视野太差、家具方向识别错误等问题拖累了表现。有意思的是,模型在过程中展现出较强的逆向工程能力,不断尝试用边界框放大、调整策略来让机械臂工作。
3D 建模的惊艳表现
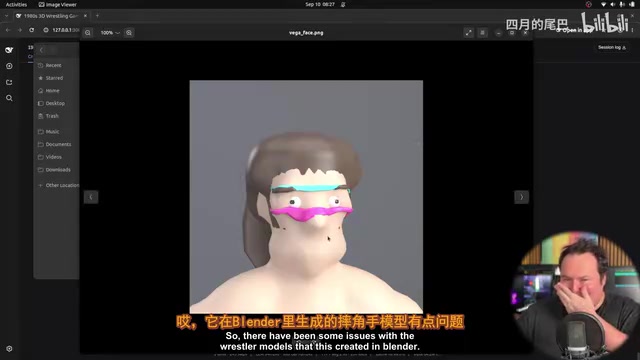
真正让作者印象深刻的是 3D 相关任务。一个用 Blender + Godot 制作的 80 年代风格 3D 摔跤游戏,虽然出现"胳膊穿出衣服""角色掉进地板"等故障,但模型会主动为角色重新生成带合身服装的 GLB 模型来修复问题,展现出可观的自我迭代能力。
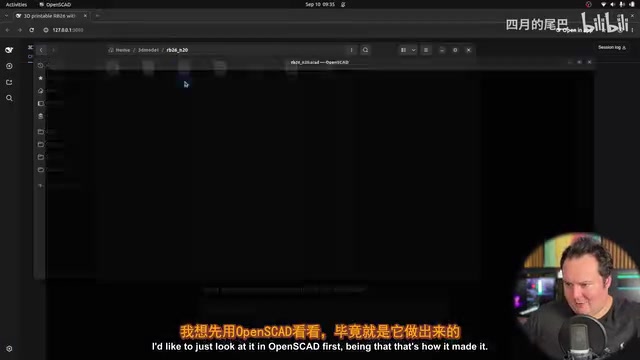
更亮眼的是一个用 OpenSCAD 生成的可 3D 打印发动机模型——包含油盖、进气管、两个涡轮增压器、N20 引擎与变速箱,结构"干净得离谱",细节丰富到可以直接进入打印流程。而一个耗时约 100 分钟生成的手表展示网站,被作者称为"见过最棒的高清渲染流程之一",滚动动画、爆炸拆解图、材质表现都相当出色。
总结:小活跃参数的性价比之王
整场测试全程(含反复重试)总花费约 5.9 美元,作者反复强调"这价格真的超划算"。综合来看,V4.1 Flash 的意义不在于单点跑分,而在于它用极小的活跃参数量,配合新架构和大幅降低的 KV 缓存,实现了远超上一代 Flash 的实际生成能力。
视频中也引用了 Digital Spaceport 等第三方的观察,认为在如此低的活跃参数下取得这样的成绩相当罕见。当然,短板也很明确:视觉/多模态在实际测试中问题不少,机械臂等真实控制任务表现不佳,本地运行的可行性仍待更多验证。
对于关注开源模型性价比的开发者而言,DeepSeek V4.1 Flash 提供了一个值得动手一试的选项——权重已开放、价格低廉、架构思路有前瞻性。它是不是"最强开源"或许见仁见智,但它无疑把"小尺寸、大能力"的边界又向前推了一步。
OpenSCAD 是一款基于脚本的参数化 3D 建模工具,用户通过编写代码(而非拖拽操作)来描述几何体的形状、尺寸与布尔运算关系,输出结果可直接用于 3D 打印切片。由于其建模逻辑高度结构化、语法接近编程语言,它是目前 LLM 生成可打印 3D 模型的最主流路径之一——模型只需输出文本代码,无需生成二进制网格数据。文章中提到的发动机模型能"结构干净到直接进入打印流程",说明模型不仅掌握了 OpenSCAD 语法,还能在几何约束层面保持一致性,这对纯文本大模型而言是一项非平凡的空间推理能力。
相关推荐
微软官宣10月7日Windows与Surface发布会:本地AI成主角
微软宣布将于10月7日在旧金山举办Windows与Surface发布会,时隔两年再度重磅亮相,核心议题聚焦本地AI如何塑造Windows的未来,或深化AI PC产品形态。
Meta 推出 WhatsApp Business MCP 服务器,让 AI 代理接管繁琐配置
Meta 推出全新 WhatsApp Business MCP 服务器,让开发者可借助 Claude、Cursor、Codex、ChatGPT 等 AI 编程代理自动处理平台配置、消息模板、测试与故障排查,大幅降低接入门槛。
Claude Code v2.1.273更新详解:修复权限漏洞与远程控制增强
Claude Code v2.1.273 版本更新详解,涵盖权限检查安全修复、远程控制会话分叉、MCP 重连、错误提示优化及 Slack 集成与代码审查改进,帮助开发者了解升级要点。