DeepSeek开源推理引擎DeepInfer:155万亿token背后的系统工程
DeepSeek开源线上推理引擎DeepInfer,公开其应对Prefill与Decode瓶颈的工程优化。
DeepSeek在GitHub开源了其线上推理引擎DeepInfer,代码从vLLM派生,采用Apache 2.0协议,单集群日处理155万亿Token。引擎针对Prefill吃算力、Decode吃带宽两个瓶颈设计:混合专家模型采用Prefill窄、Decode宽的相反专家并行策略,最小高效部署128卡起步;投机解码DSpark用三层草稿模型一次猜五个位置,再按负载动态决定检查数量,每卡60并发下吞吐提升4%到7%;SWA缓存采用近似重算策略,只重算最后128个Token,使Prefill总计算量接近减半。开源的是离线推理版,KV缓存系统、PD分离部署与跨副本负载均衡未开放,主要面向云厂商与推理工程师。
DeepSeek在GitHub上开源了推理引擎DeepInfer,这不是一个新模型,而是DeepSeek线上正在使用的推理系统——你在DeepSeek收到的每一个回答,都是由它一个Token一个Token算出来的。据官方数据,单个集群一天要处理155万亿个Token。代码从vLLM派生而来,采用Apache 2.0协议,但前提是你手上得有Blackwell或昇腾950级别的硬件。
从零件到整机:一年半的开源路线
DeepSeek广告并非第一次触碰推理基础设施。2025年2月,他们曾在一周内连续放出Flash MLA、DeepEP、DeepGEMM、3FS存储系统等底层库,但整台引擎一直没给。2025年4月的一篇说明解释了原因:这套引擎是一年多前从vLLM分出来的,早已改得面目全非,还和内部集群管理工具深度耦合,硬拆出来外面的人也跑不起来。当时的决策是把优化一点点贡献回vLLM和SGLang。
一年半之后,整台引擎还是拿出来了。不少文件开头仍留着一行注释:派生自vLLM,由DeepSeek修改。目前它只支持一个模型——DeepSeek V4.1 Flash。
Flash MLA、DeepEP、DeepGEMM 是 DeepSeek 在 2025 年初陆续开源的三个底层组件,分别解决推理链路中不同环节的问题。Flash MLA 是多头潜在注意力(MLA)的高效实现,针对 DeepSeek 模型特有的注意力结构做了访存优化;DeepEP 是专家并行(Expert Parallelism)场景下的通信库,负责混合专家模型中 Token 在不同 GPU 之间的分发与回收;DeepGEMM 则是面向矩阵乘法的底层算子库。三者都属于“零件”级别,需要嵌入完整的推理框架才能发挥作用,这与 DeepInfer 作为“整机”定位不同。
两个瓶颈:Prefill吃算力,Decode吃带宽
大模型本身只是一个巨大的文件,里面全是数字。要让它说话,就得拿这些数字反复做计算:根据前面所有的字算出下一个字,接上再算下一个。一个人用这很简单,麻烦在于同一时刻有成千上万个人在问——谁先算、谁和谁拼成一批、数据放哪张卡上、中间结果存到哪里,这些杂事就是推理引擎的工作。
每个请求都要过两关。先是Prefill,把你的问题一次读完,几千个Token同时计算,GPU算力被吃满;然后是Decode,答案一个Token一个Token往外写,每写一个都得把权重从显存里再读一遍,算力闲着,带宽先撑不住了。DeepInfer里的大部分优化,都是冲着这两个瓶颈去的。
混合专家模型:算得少所以便宜
V4.1 Flash是一个拥有5520亿参数的混合专家模型。可以把它想成一栋楼里坐满了专家,每来一个Token,门口的路由器只叫醒其中几位,其他人接着睡。所以每个Token真正用到的参数只有一小部分:读输入时约80亿,生成时约160亿。算得少,所以便宜。
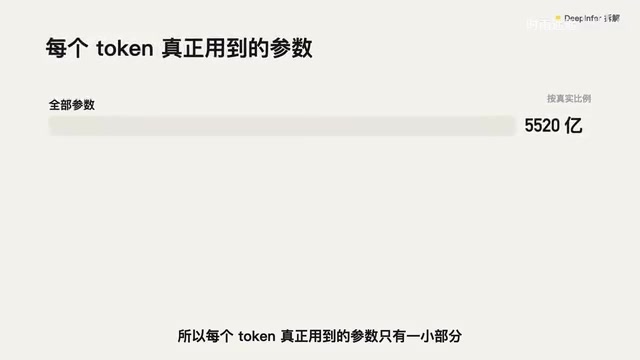
可这5000多亿参数总得有地方放,一张卡放不下。办法是把专家分到很多张卡上,每张卡只管一部分,这叫专家并行。但Prefill和Decode的分法正好相反:Prefill时每个专家本来就能分到一大批Token,活够多,两到八张卡一组就够了,组越小卡间通信越少;Decode时每走一步每张卡都要把自己身上的专家读一遍,卡上专家越多这一步就越慢,所以Decode摊得很开,64到128张卡一组。从8张卡摊到64张,每张卡上的专家只剩原来的八分之一。
热门专家会被挤爆,一批负载均衡器负责给它们多复制几份放到别的卡上,再按实际流量定期重新排。也不是越宽越好,超过32张卡通信和同步的开销就开始抵消收益。官方给出的最小高效部署是64张卡做Prefill、64张卡做Decode,128张卡起步。
专家并行(Expert Parallelism)是混合专家模型分布式推理的核心手段。由于总参数量远超单卡显存,必须把不同专家分配到不同 GPU 上,每个 Token 经路由器选择专家后,其隐藏状态需要被发送到持有对应专家的卡上计算,再把结果传回。这一过程引入了额外的卡间通信开销,且通信量与专家分布的广度正相关。因此专家并行的宽度需要在显存容量、单卡计算效率和通信成本之间权衡,这也是文中 Prefill 与 Decode 采用不同并行度的根本原因。
投机解码DSpark:猜五个,查几个看忙闲
Decode一次只出一个Token,大模型每走一步大部分时间都花在搬数据上。投机解码的思路是让一个小草稿模型先连猜五个,大模型一次性检查,前面猜对几个就收集几个。DeepInfer用的是DSpark,它的草稿模型只有三层,一次就能把五个位置一起猜出来。
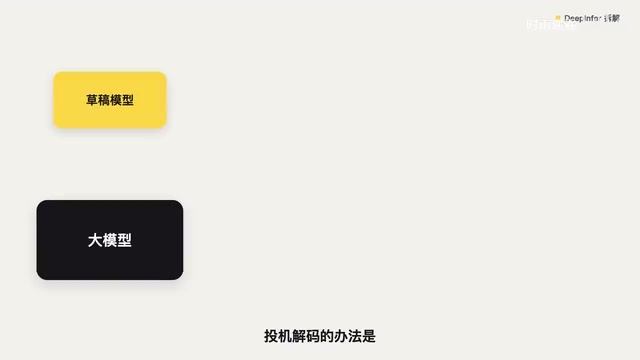
可检查也要花算力,越靠后的猜测越不靠谱,每次都查满五个常常是白算。所以DSpark给每个猜测付了一个分数——它被接受的可能性有多大,调度器再看当下有多忙:卡闲就多查几个,卡忙就只查最有把握的。官方数据显示,每步检查的Token从五个降到3.2到4.4个,平均被接受的长度几乎没变。落到吞吐上,每张卡60个并发左右能快4%到7%,并发越高越划算,很低的时候反而略亏。
缓存与调度:那些不那么显眼的工程活
模型读过的每个Token都会留下一份中间结果,叫KV缓存,下次遇到同样的开头直接拿来用。DeepSeek把这些缓存放在3FS上,大约100PB的固态硬盘,聊天的留7天,Agent的留3天,刚好能跨过一个周末。
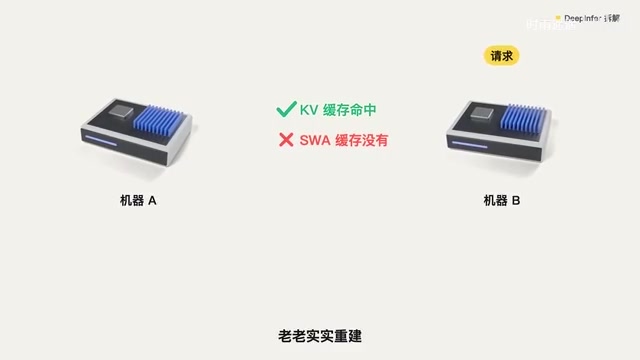
但V4.1 Flash还有一份小缓存是滑动窗口注意力用的,叫SWA缓存,它不进3FS,只待在算出它的那台机器的内存里。请求换一台机器,大缓存命中了、小缓存却没有,老老实实重建要把最后2560个Token过一遍20层解码器。DeepInfer选择凑合一下:只重算最后128个Token,注意力也只看到重算的起点为止。这样得到的缓存是近似的,但重算量固定了,上下文是10万还是100万都一样。官方说Prefill的总计算量因此接近减半。
还有一招很朴素:GPU每算完一步,CPU要收尾再把下一批排好,这段时间GPU只能干等。DeepInfer让CPU提前一步——GPU在算第N步,CPU已经在排第N+1步。这个做法来自SGLang和NanoFlow,默认开启。需要输出JSON的时候,格式规则会先编译成一台状态机,每一步只放行合法的Token。
KV 缓存(Key-Value Cache)是自回归生成中的关键机制。Transformer 解码时,每个新 Token 的注意力计算都需要前面所有 Token 的 Key 和 Value 向量,若不缓存则每步都要重新计算整个前缀,代价随上下文长度平方增长。KV 缓存将这些中间结果保留在显存或外部存储中,使每步只需计算新 Token 的注意力。缓存命中可以跳过重复的 Prefill 计算,但缓存容量有限,需要按策略淘汰,文中按对话类型设置 7 天与 3 天的保留期即为此类策略。SWA 缓存则是滑动窗口注意力特有的轻量缓存,只保留最近若干 Token 的注意力状态。
开源了什么,没开源什么
能不能拿它自己搭一个DeepSeek?暂时不行。这次放出来的是离线推理版,线上服务还需要的KV缓存系统、Prefill与Decode分离部署、跨副本负载均衡都没给,理由是和内部基础设施绑得太紧。再加上只支持一个模型、只支持最新的卡,个人电脑就别想了。它真正的读者是云厂商和合作推理的工程师。按官方的数字,这套系统在股票价格下每张GPU每小时能带来大约38美元收入。
DeepSeek的模型权重早就公开了,这一次连怎么把它便宜地跑起来也一起交了出来。对推理基础设施领域来说,这或许比再发一个模型更有参考价值。
相关推荐

Hermes Agent零基础教程:自进化AI智能体实战
Hermes Agent零基础教程:详解这个GitHub两月获41.7K星的开源自进化AI智能体,从Harness Engineering核心理念、学习循环、三层记忆系统到WSL安装与实战配置,小白也能轻松上手。
AI Agent落地实战:用WorkBuddy打造智能办公助理
本文通过实战案例演示如何用腾讯WorkBuddy完成文件批量转换与归档,对比聊天大模型与AI Agent的能力差异,分析WorkBuddy的积分体系、适用场景与产品定位,为办公自动化选型提供参考。
从单卡瓶颈到千亿参数:大模型分布式并行6大关键问题
基于B站教程梳理大模型分布式并行核心知识:从decoder-only架构的逐token生成与X乘W计算本质出发,解析单卡瓶颈下数据并行、张量并行、流水线并行等6个关键问题,适合私有化部署与模型训练场景的学习者建立系统认知。