DeepSeek新模型+推理引擎实测:开源AI逼近前沿

DeepSeek开源新模型实测逼近前沿闭源模型,并公开推理引擎优化细节。
文章基于B站UP主的实测视频,全面评估了DeepSeek新开源的C.E Flash 1017模型与推理引擎DeepInfer。模型采用5520亿总参数、160亿激活参数的MoE架构,在地球周长讲解视频、虚幻引擎3D游戏、EDM音乐创作、找青蛙视觉定位、脑肿瘤识别、深度研究报告与创意构想等任务中表现不一:整体约达前沿模型八成水平,找青蛙任务甚至超越闭源模型,医学图像识别则全部失败。全部测试成本仅6美元。DeepInfer公开了单集群日处理155万亿token、96%输入缓存命中率与约80%毛利率等细节,并同时支持英伟达与华为昇腾芯片,被视为对闭源实验室竞争格局的有力挑战。
DeepSeek在假期后迅速放出重磅更新:新一代开源模型DeepSeek C.E Flash 1017(命名来自10月17日发布日)以及推理引擎DeepInfer。据B站UP主“AI Search”的实测视频,这款模型在多项高难度任务中展现出接近前沿闭源模型的实力,而DeepInfer则首次公开了大规模推理优化的核心细节——包括96%的输入缓存命中率和约80%的毛利率。这不仅是技术迭代,更可能改变开源与闭源模型的竞争格局。
模型实测:从地球周长到3D游戏,能力全面逼近前沿
UP主设计了一系列极具挑战性的任务来检验模型的实际能力。第一个任务是制作一个极简风格的地球周长测量讲解视频,要求模型自行规划场景、生成配音(借助Gemini TTS)、使用Hyperframes开源工具制作动画。模型运行36分钟,消耗约2200万token,缓存命中率99%,最终产出的视频质量“比得上从Claude和GPT这类前沿模型那里得到的结果”。
第二个任务更复杂:在Unreal Engine中制作一款程序化3D游戏,场景为中国古代皇家风格,资产在Blender中生成,并要求模型启动一个“批评智能体”进行自我评分迭代。模型实际运行了16轮,批评智能体最高只给出5.5分(满分10分),未达到8.5分的3A标准。UP主评价其“大概达到了前沿模型八成水平”,但渲染出的角色、建筑变体以及移动、冲刺、跳跃等玩法机制已经具备基本框架。该任务消耗约3.75亿token,缓存命中率99.5%。
在音乐创作测试中,模型需要自主找到DAW(Waveform)并使用VST插件制作一首欧洲流行EDM。首轮结果“挺糟糕”,经过用户反馈调整后,第二轮旋律与市面上其他模型相似,UP主认为“不如GPT-6 Astra或OPS,但达到80%到90%的水平”。
Hyperframes 是文中提到的开源动画工具,属于一类基于浏览器渲染的可编程动画框架,开发者通过代码描述时间轴、图层变换与合成操作,再逐帧导出为视频。它与传统剪辑软件的区别在于完全可脚本化,因此适合由 AI 智能体以代码方式驱动:模型只需生成结构化的场景与关键帧描述,即可自动渲染出成片。这类“代码即动画”的工具是近期智能体制作视频任务得以可行的重要前提,也是此类任务 token 消耗量巨大的原因之一——模型需要同时生成规划、代码和素材描述。
视觉与推理:找青蛙惊艳,医学识别全错
最令人惊讶的是“找青蛙”测试。UP主上传一张藏有青蛙的图片,不提示动物存在,仅要求识别并圈出。模型将图片拆分成多个区域,调整对比度和饱和度,甚至试图提取EXIF元数据(已被清除),最终成功定位青蛙。UP主称“这差不多是我遇到的唯一一个能真正成功找到青蛙的模型,就连Opus或GPT-6都找不到”。
但在脑肿瘤识别任务中,模型对六张脑部扫描图的肿瘤类型判断全部错误。UP主指出,即便是最好的模型六道题大概也只能做对一道,因此这一结果并不意外。
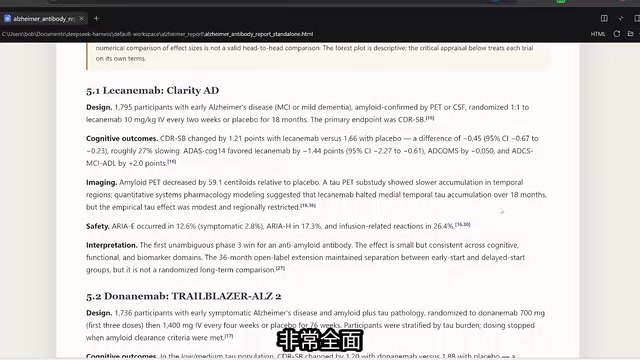
深度研究任务中,模型用20分钟生成了一份关于阿尔茨海默病中β淀粉样蛋白和tau蛋白传播机制及抗体疗法三期临床试验的HTML报告,包含表格、图表和完整参考文献。UP主评价“全面又简洁,和GPT-6 Astra不相上下,远好于OPS5.5”。
创造力测试要求提出三个改善工厂化农场动物福利的可行构想。模型思考10分钟后给出“气候自动驾驶”和“觅食自动驾驶”等方案,详细阐述了问题背景、产品逻辑和预期效果,展现了较强的结构化思维能力。
EXIF 元数据 是数码相机和手机在拍摄时写入图像文件的附加信息,通常包括拍摄设备型号、时间戳、光圈快门参数,以及部分设备记录的 GPS 坐标。在“找青蛙”这类视觉任务中,模型尝试读取 EXIF 是一种“绕过视觉推理”的捷径:若图片保留了拍摄地点或时间等线索,可能辅助定位目标。而该图已被清除元数据,因此这一路径失效,模型最终仍依靠图像本身的区域切分与对比度增强完成定位,这反而更能说明其视觉推理能力是真实的而非依赖元信息。
成本与规格:5520亿参数,总测试成本仅6美元
全部测试任务(包括数小时的Blender和游戏开发任务)总成本仅6美元——UP主充值50美元后余额还剩44美元,“便宜得离谱”。
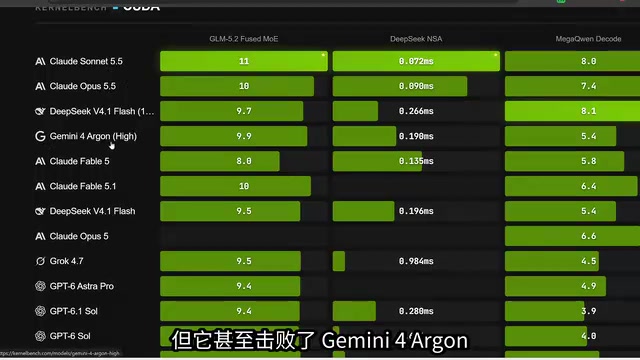
模型采用混合专家架构,总参数5520亿,激活参数160亿,效率极高。在智能体编程、通用智能体、知识、自动化等基准测试中,新版本比上一代提升几个百分点,击败了GLM5.3和Kimi K3等开源模型,性能几乎与GPT-5.6 Sol持平。在KernelBench(GPU底层代码编写)中排名第三,仅次于最新Claude模型,但击败了Gemini 4 Argon、Claude Fable和GPT Leo Astra。
效率对比图显示,在“智能水平 vs 单任务成本”坐标系中,DeepSeek广告位于最左端,效率甚至超过顶级GPT和Claude模型。模型已在Hugging Face和ModelScope开源,全量约510GB,社区已推出量化版本(如Unsloth的4bit GGUF仅233GB),但仍需高端GPU才能本地运行。
混合专家架构(MoE) 指模型内部由多个独立的“专家”前馈网络组成,配合一个路由网络,对每个 token 只激活其中少数几个专家。文中 5520 亿总参数与 160 亿激活参数的组合即典型 MoE 配置:参数总量决定知识容量,激活量决定单次推理的计算与显存开销。这正是其“智能水平高但单任务成本极低”的结构性原因。与稠密模型相比,MoE 可用更大的总参数换取更强的知识覆盖,同时把每 token 的计算量控制在较小规模,但代价是对显存容量和专家并行通信的要求更高,也是其全量权重仍达约 510GB 的原因。
KernelBench 是用于评测大模型编写 GPU 底层内核代码能力的基准,题目通常要求模型用 CUDA 或 Triton 实现矩阵乘、归约、注意力等算子,并以相对 PyTorch 基线的加速比作为评分依据。这类任务对模型的硬件理解、并行思维和数值正确性要求极高,是衡量“代码能力上限”的硬指标之一。文中模型在此项排名第三,说明其在系统级编程上已进入第一梯队,但仍有提升空间。
DeepInfer:公开推理优化机密,支持华为昇腾
DeepInfer并非新模型,而是DeepSeek数据中心大规模运行模型的推理引擎。官方披露的数据令人震惊:单集群每天处理高达155万亿token,每GPU小时收入38美元,估算毛利率约80%(仅计算GPU成本)。96%的输入缓存命中率意味着大部分计算复用先前结果,这是高吞吐和高利润的关键。
这一发布之所以重要,是因为所有前沿实验室都将推理优化视为最高机密——这是它们通过订阅服务盈利的核心。DeepSeek却选择免费公开,允许研究和商业使用。不过UP主也指出,DeepInfer并非完整生产系统,缺少缓存和负载均衡基础设施,不能直接复制其经济效益。
另一关键细节是DeepInfer不仅支持英伟达芯片,也能在华为昇腾芯片上运行。UP主分析认为,这为英伟达提供了切实可行的替代方案,对中国企业尤为重要——在出口限制下,降低对英伟达的依赖意味着更强的供应链韧性,也有助于缓解全球芯片短缺和定价压力。
输入缓存(prefix caching)命中率 指推理服务端把此前处理过的提示词前缀的键值缓存(KV Cache)保存下来,当新请求包含相同前缀时直接复用,无需重新计算。对智能体类负载尤为有效,因为多轮工具调用中系统提示、历史对话和文件内容大量重复。96% 的命中率意味着绝大部分输入 token 的计算被跳过,直接转化为吞吐提升与成本下降,是解释其 80% 毛利率的关键机制。需要注意的是,缓存命中依赖前缀完全一致,实际部署还需配合调度与淘汰策略,这也是该引擎无法被简单复制的原因。
华为昇腾 是华为自研的 AI 加速芯片系列(如 Ascend 910 系列),配套 CANN 软件栈与 MindSpore 框架。让推理引擎同时适配英伟达 CUDA 与昇腾,意味着算子实现、显存管理和通信原语都需要双套后端,工程量可观。对受出口限制影响的中国企业而言,这一适配提供了真实的替代路径,也解释了为何该细节被视为此次发布中具有产业意义的部分。
总结:开源智能的新高度
综合实测与基准数据,DeepSeek C.E Flash 1017在智能体任务、深度研究、代码生成等方面已接近GPT-5.6 Sol水平,部分场景(如找青蛙)甚至超越前沿闭源模型,但在3D游戏、音乐创作等任务上仍有约20%的差距。其极致效率和开源策略,加上DeepInfer揭示的推理优化秘密,构成了对闭源前沿实验室的有力挑战。UP主总结道:“这么强的智能水平加上优化软件,估值可能高达数十亿美元,但DeepSeek竟然决定免费发布,这太疯狂了。”
相关推荐

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。

Anthropic IPO前,早期投资人账面回报有多高?
Anthropic IPO前早期投资人账面回报引发关注。本文分析其纸面收益来源、资本结构、IPO预期下的博弈与风险,以及对AI创业生态的启示。