DeskForge:用桌面环境密集标注训练计算机操作智能体

DeskForge通过可控组合真实桌面应用生成120万条密集标注数据,系统性提升AI智能体的视觉接地与长程任务能力。
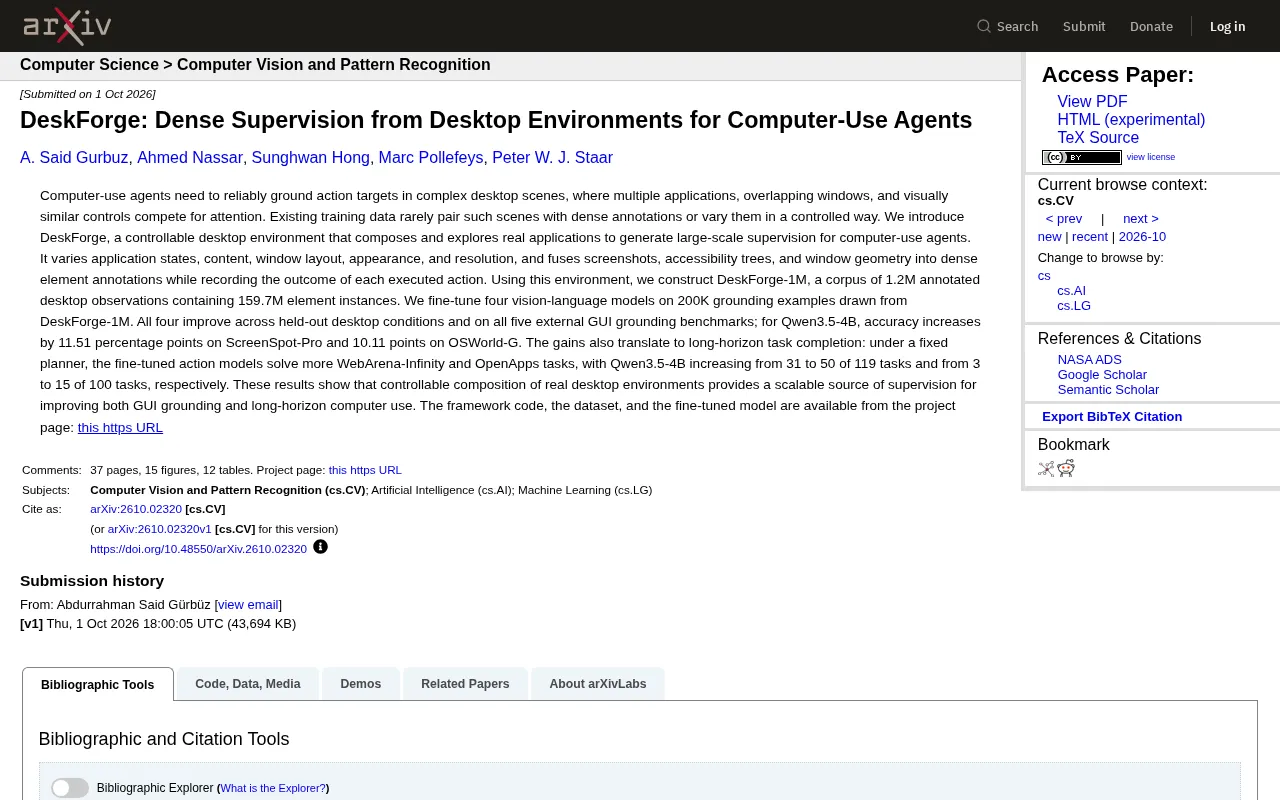
DeskForge是一个针对计算机操作智能体"视觉接地"瓶颈而设计的可控桌面监督环境,通过在应用状态、窗口布局、外观、分辨率等多维度系统性变化真实应用程序,融合截图、无障碍树与窗口几何信息,构建了包含120万条观测、逾1.59亿元素实例的DeskForge-1M数据集。研究团队用其中20万条样本微调四个视觉语言模型,结果显示所有模型在保留测试条件和五个外部GUI基准上均获全面提升,Qwen3.5-4B在ScreenSpot-Pro和OSWorld-G分别提升11.51和10.11个百分点。更重要的是,这种定位准确率的改善在长程任务中产生了显著的乘数效应:Qwen3.5-4B在WebArena-Infinity上从31/119提升到50/119,在OpenApps上从3/100提升到15/100,完成能力接近五倍提升。框架、数据集与模型均已开源。
计算机操作智能体的"视觉接地"难题
让AI智能体像人一样操作电脑,核心挑战之一在于动作目标定位(grounding):在一个布满多个应用程序、重叠窗口和外观相似控件的桌面场景中,智能体必须准确识别出"该点哪里"。现实中的桌面远比干净的测试界面复杂——弹出菜单、浮动窗口、相似的按钮图标都在争夺模型的注意力。
问题在于训练数据。现有的数据集很少能把这类复杂场景与**密集标注(dense annotations)**配对,也缺乏在受控条件下系统性地变化场景的能力。这意味着模型往往难以泛化到真实、多变的桌面环境中。arXiv上新发布的研究《DeskForge》正是针对这一瓶颈提出了一套可控的数据生成方案。
动作目标定位(grounding) 在多模态AI领域特指将自然语言指令或意图映射到具体视觉元素坐标的能力——例如将"点击提交按钮"转化为屏幕上精确的像素坐标。这与图像描述、视觉问答等任务不同,它要求模型输出的不是文字,而是可执行的界面操作位置。当前主流的视觉语言模型(如GPT-4o、Qwen-VL系列)虽然具备强大的图像理解能力,但在密集UI场景下的精确定位上仍存在明显短板:相似图标、小尺寸控件、动态弹出层都会导致定位失准,而一次定位错误在多步骤任务链中往往会引发级联失败。这正是为何grounding被视为计算机操作智能体的核心瓶颈之一。
DeskForge:一个可控的桌面监督环境
DeskForge 的核心思路是构建一个可控的桌面环境,通过组合与探索真实应用程序来大规模生成监督数据。它不是简单截图,而是在多个维度上系统性地变化场景:
- 应用状态:程序处于不同的运行与交互状态
- 内容:界面中显示的实际数据与文本
- 窗口布局:窗口的排列、重叠与位置
- 外观:主题、配色等视觉风格
- 分辨率:不同屏幕尺寸下的渲染
更关键的是,DeskForge 将三种信息源融合成密集的元素级标注:屏幕截图、无障碍树(accessibility tree)以及窗口几何信息。话说回来,它还记录每个被执行动作的实际结果。这种多源融合让每一个界面元素都获得了可靠的位置与语义标注,而非依赖人工逐个标记。
无障碍树(accessibility tree,简称AT) 是操作系统为辅助技术(如屏幕阅读器)提供的结构化界面描述,它以树状形式记录了每个UI控件的类型、名称、状态与边界框坐标。与纯截图相比,无障碍树提供了像素之外的语义信息——例如一个按钮的可点击状态、文本框的当前内容、菜单项的层级关系。DeskForge 将无障碍树与截图及窗口几何信息三者对齐融合,使得每个视觉元素都同时拥有"看起来像什么"和"语义上是什么"的双重标注。这种融合方式避免了纯视觉标注依赖人工逐像素标记的瓶颈,也规避了纯无障碍树方案无法捕捉视觉遮挡与渲染细节的局限。
DeskForge-1M 数据集规模
借助这一环境,研究者构建了 DeskForge-1M 语料库,规模相当可观:
- 包含 120 万条带标注的桌面观测
- 涵盖 1.597 亿个元素实例
这种量级的密集标注在 GUI 领域此前较为罕见。它的价值不仅在于数量,更在于每条数据都来自真实应用的可控组合,兼具真实性与多样性——这正是训练鲁棒的操作智能体所需要的监督信号。
四个视觉语言模型的一致性提升
为验证数据的有效性,研究团队从 DeskForge-1M 中抽取 20 万条 grounding 样本,对四个视觉语言模型(VLM)进行了微调。结果显示出相当一致的改进:
所有四个模型在保留的桌面测试条件以及全部五个外部 GUI grounding 基准上都获得了提升。以 Qwen3.5-4B 为例:
- 在 ScreenSpot-Pro 上准确率提升 11.51 个百分点
- 在 OSWorld-G 上提升 10.11 个百分点
四个不同模型的全面改进,说明 DeskForge 提供的监督信号具有普适性,而非针对某个特定架构的过拟合。
从元素定位到长程任务完成
单纯的元素定位准确率提升,并不必然转化为真实任务的成功。DeskForge 的研究进一步验证了**长程任务(long-horizon task)**上的收益。
在固定规划器(planner)的设定下,微调后的动作模型能够完成更多复杂任务:
- 在 WebArena-Infinity 上,Qwen3.5-4B 从解决 119 个任务中的 31 个提升到 50 个
- 在 OpenApps 上,从 100 个任务中的 3 个提升到 15 个
后者的提升尤为显著——从近乎失败(3/100)到 15/100,相当于任务完成能力提升了约五倍。这表明更准确的视觉接地确实能在多步骤操作链条中累积为实质性的任务成功率改善。
长程任务(long-horizon task) 指需要连续执行多个相互依赖步骤才能完成的目标,例如"在网页上找到某商品、加入购物车、填写收货信息并提交订单"。与单步定位不同,长程任务中任意一步的失误都可能导致后续步骤无法执行,错误会沿任务链累积放大。这也是为何即便单步grounding准确率提升看似有限,也能在完整任务成功率上产生显著的乘数效应——一个从85%提升到90%的单步准确率,在10步任务中可将整体成功率从约20%提升到约35%。DeskForge在OpenApps上从3/100到15/100的五倍提升,正体现了这种非线性的累积效益。
可扩展监督的意义
DeskForge 的核心贡献,在于证明了对真实桌面环境进行可控组合是一种可扩展的监督来源。相比依赖人工标注或受限的合成界面,这种方法既保留了真实应用的复杂性,又能以程序化方式无限扩展与变化。
对于计算机操作智能体这一快速发展的方向而言,数据往往是比模型架构更根本的瓶颈。DeskForge 提供的框架代码、数据集与微调模型均已在项目主页开放,这为后续研究者在 GUI grounding 与长程计算机操作上的工作提供了可复用的基础设施。
对于关注 AI Agent、自动化操作与多模态模型的开发者,这项工作值得关注——它指向了一条用可控真实环境大规模生成高质量监督数据的清晰路径。
相关推荐
触屏MacBook与混乱的苹果:一场刻意为之的冒险
The Vergecast 深入讨论触屏 MacBook Pro 的发布逻辑、ProLed 命名争议、iPad 被 iPhone 与 Mac 两头挤压的困境,以及苹果在 AI 时代如何靠高端硬件维持竞争力。

研究权力50年:Robert Caro的写作与权力洞察
Robert Caro研究权力50年,在访谈中谈Lyndon Johnson的说服力与杠杆、Robert Moses从理想主义到冷酷的变迁、大规模建设的困境,以及传记写作中压缩主题与孤独专注的方法。

2万美元的机器人能替你干家务吗?实测结果令人意外
一段YouTube实测视频展示2万美元机器人如何响应洗碗、关灯、倒垃圾、喂狗等指令。本文分析其真实能力边界、语音交互技术现状,以及家务机器人距离普及还有多远。