DexDICE:双专家离线模仿学习平衡安全与性能
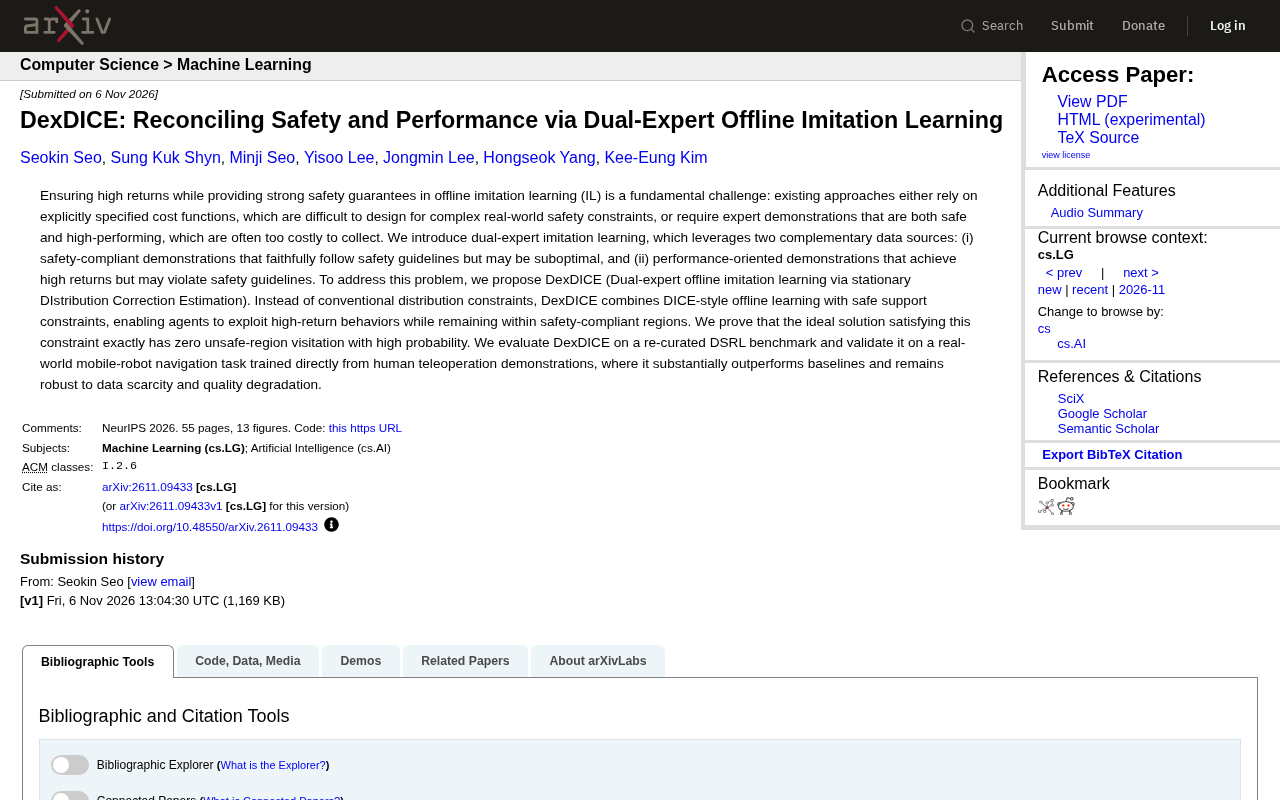
DexDICE 融合安全与高性能两类演示,实现离线安全模仿学习。
DexDICE 提出一种双专家离线模仿学习框架,旨在解决安全与性能难以兼得的困境。传统方法要么依赖人工设计的安全成本函数,要么需要同时安全且高性能的专家演示,而两者在现实中均难以获取。DexDICE 的创新在于融合两类互补数据:安全但可能次优的演示提供安全边界,高性能但可能违规的演示揭示高回报行为。方法上,它采用平稳分布校正估计(DICE)框架,学习策略使其平稳分布接近高性能演示的高回报区域,同时通过安全支持约束确保分布不超出安全演示覆盖的区域。理论分析表明该约束能以高概率保证零不安全区域访问。在 DSRL 基准和真实移动机器人导航任务中,DexDICE 显著优于基线,并对数据稀缺和质量下降表现出鲁棒性。
在机器人学习领域,安全与性能往往难以兼得。传统的模仿学习方法要么依赖精心设计的安全成本函数,要么需要既安全又高性能的专家演示,而这两者在现实世界中都难以获取。DexDICE 提出了一种新颖的双专家离线模仿学习框架,通过融合两类互补的演示数据——安全但可能次优的演示,以及高性能但可能违反安全规则的演示——来同时实现高回报与安全约束。该方法在 DSRL 基准和真实移动机器人导航任务中均展现出显著优势。
问题背景:安全与性能的权衡困境
离线模仿学习旨在从预先收集的演示数据中学习策略,无需与环境交互。然而,在现实世界的安全关键场景(如自动驾驶、机器人导航)中,仅追求高回报可能导致危险行为,而仅强调安全又会使策略过于保守。现有方法面临两大瓶颈:其一,显式指定成本函数需要领域专家针对复杂约束进行繁琐设计,且难以覆盖所有潜在风险;其二,收集同时满足安全与高性能的专家演示成本极高,甚至不可行。
DexDICE 的核心洞察在于:与其追求完美的单一专家,不如利用两类不完美但互补的数据源。安全合规的演示(如人类操作员遵循安全规程的轨迹)能提供可靠的安全边界,而性能导向的演示(如激进但高效的策略)则揭示了高回报的行为模式。如何有效融合二者,成为关键挑战。
离线模仿学习(Offline Imitation Learning) 是一类仅利用预先收集的固定演示数据集来训练策略、而不与环境进行额外交互的强化学习范式。与在线强化学习不同,它避免了在真实环境中探索可能带来的高昂代价与安全风险,因此特别适合机器人、自动驾驶等安全敏感场景。离线模仿学习的核心挑战在于分布偏移(distribution shift):学习到的策略可能访问演示数据未覆盖的状态-动作区域,导致误差累积。为缓解该问题,研究者常引入保守约束或支持约束来限制策略的分布范围。DexDICE 将这一思想与安全约束结合,通过双专家数据互补来界定安全可行域,从而在离线条件下兼顾性能与安全。
DexDICE 方法:基于平稳分布校正估计的双专家学习
DexDICE 的全称是 Dual-expert offline imitation learning via stationary DIstribution Correction Estimation,即通过平稳分布校正估计实现双专家离线模仿学习。该方法创新性地将 DICE 风格离线学习与安全支持约束相结合,而非采用传统的分布匹配约束。
具体而言,DexDICE 学习一个策略,使其平稳分布尽可能接近性能导向演示的高回报区域,同时通过安全支持约束确保该分布不会超出安全演示所覆盖的区域。这种约束方式允许智能体在安全区域内充分利用高性能行为,而无需显式定义成本函数。理论分析表明,满足该约束的理想解能以高概率实现零不安全区域访问,从而在理论上保证了安全性。
与现有方法相比,DexDICE 的优势在于:它不要求任何单一数据集同时满足安全与高性能,降低了数据收集门槛;通过支持约束而非惩罚项来保证安全,避免了成本函数设计的难题;DICE 框架的离线特性使其适用于无法在线交互的场景。
平稳分布校正估计(DICE,Stationary Distribution Correction Estimation) 是一类离线强化学习与模仿学习方法,其核心思想是直接估计策略访问状态-动作的长期折扣分布(即平稳分布),并通过重要性采样比率进行校正,从而避免传统方法中不稳定的时序差分自举。DICE 框架将策略优化转化为一个凸优化问题,可自然地施加分布匹配或支持约束。在 DexDICE 中,DICE 被用来对齐高性能演示的高回报区域,同时以安全演示覆盖的区域作为支持约束的边界。这种设计使方法无需显式成本函数,也无需在线交互,仅凭两类离线数据即可求解安全且高性能的策略。
安全支持约束(Safe Support Constraint) 是 DexDICE 保证安全性的关键机制。支持约束要求学习到的策略平稳分布必须落在安全演示数据所覆盖的支撑集(support)内,即策略不得访问安全数据中从未出现过的状态-动作区域。与传统的惩罚式成本函数不同,支持约束不依赖人工设计的成本权重,而是直接从数据中隐式定义安全边界。理论分析表明,当约束严格满足时,策略访问不安全区域的概率趋近于零,从而提供高概率的安全保证。这一机制使 DexDICE 能够在安全区域内自由优化性能,而无需担心越界风险。
实验验证:基准测试与真实机器人导航
研究团队在重新整理的 DSRL 基准上对 DexDICE 进行了评估,并进一步在真实世界的移动机器人导航任务中进行了验证。该导航任务直接使用人类遥操作演示进行训练,无需额外的安全标注或成本函数设计。
实验结果显示,DexDICE 在性能上大幅超越基线方法,并且对数据稀缺和质量下降表现出鲁棒性。这意味着即使在演示数据有限或质量不佳的情况下,该方法仍能有效学习到安全且高性能的策略。在真实机器人任务中,DexDICE 的成功进一步证明了其实际部署潜力,尤其是在安全至关重要的应用场景中。
DSRL 基准(Dsrl Benchmark) 是专为安全强化学习与离线安全学习评估而整理的基准测试集,通常包含多个连续控制任务(如安全导航、避障等),每个任务提供离线演示数据及对应的安全成本标注。该基准的难点在于数据往往由不同质量的策略生成,且安全约束与任务回报存在冲突。DexDICE 在 DSRL 上的评估重点考察策略在满足安全约束的同时最大化回报的能力,并测试其对数据稀缺与质量下降的鲁棒性。该基准为比较不同安全离线模仿学习方法提供了标准化平台。
意义与展望
DexDICE 为离线模仿学习提供了一种务实的安全与性能平衡方案。通过双专家数据融合和支持约束,它绕过了传统方法对成本函数或完美演示的依赖,为现实世界中安全关键场景的机器人学习开辟了新路径。未来,该方法有望扩展到更复杂的安全约束和多模态演示数据,进一步推动安全强化学习在工业和服务机器人领域的落地。
相关推荐
Claude Code隐藏设置:开启Idle Compaction省大钱
Claude Code 的 Idle Compaction 设置可避免提示缓存过期后整段上下文按全价重发。本文介绍问题根源、开启路径与注意事项,帮助开发者降低长会话的 API 成本。
13个AI实用技巧:省钱、护隐私、升级数字生活
梳理The Explainer分享的13个AI实用技巧,涵盖用AI代理省钱谈判、数据删除请求、Claude Code诊断电脑、本地离线模型、车内语音学习与运动姿态分析,并强调人类监督与安全边界。
Claude Code省钱三件套:三个免费工具砍掉Token浪费
介绍Claude Code三个免费Token优化工具:RTK压缩终端输出、Caveman精简回复、微软Token Economizer学习仓库剪掉未用工具,测试中成本降低18%到31%,并提醒micro skills默认关闭需手动开启。