DFQI:直接知识迁移提升离线Q学习效率

DFQI通过L1惩罚在贝尔曼更新中联合估计源与目标Q函数,实现离线RL跨环境知识迁移。
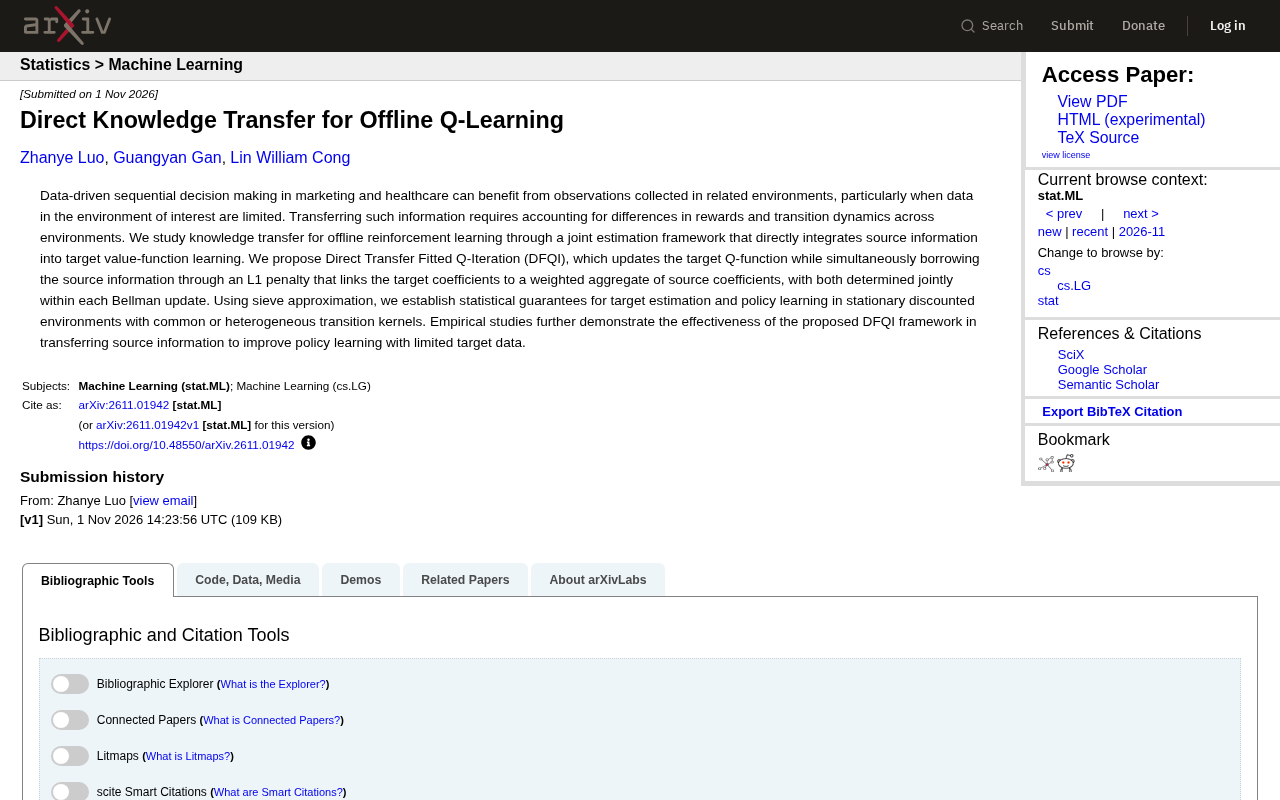
本文介绍了一种面向离线强化学习的知识迁移方法DFQI。针对目标环境数据稀缺而相关环境数据丰富的场景,DFQI在拟合Q迭代框架下,于每次贝尔曼更新中同时更新目标Q函数并引入L1惩罚项,将目标系数拉向源系数的数据自适应加权聚合。该设计能在目标数据不足时更多借用源信息,并在数据充足时自动减少影响,同时带来稀疏性以识别有价值的源信息。论文使用筛网近似处理高维状态空间,在平稳折扣环境下建立了同质与异质转移核的统计保证,表明其收敛速率与仅用目标数据的估计器相当,且能避免负迁移。实证结果显示,在目标数据有限时DFQI显著提升策略回报与稳定性,且框架可扩展到其他基于价值迭代的离线RL算法。
离线强化学习(Offline RL)在营销、医疗等数据驱动决策场景中潜力巨大,但目标环境数据稀缺时,如何利用相关环境的数据成为关键挑战。最近一篇论文提出Direct Transfer Fitted Q-Iteration (DFQI),通过联合估计框架将源环境信息直接融入目标价值函数学习,为跨环境知识迁移提供了新思路。
离线RL的知识迁移难题
离线RL旨在仅利用固定数据集学习策略,避免在线探索的风险。实际应用中,兴趣环境(如新市场)的数据往往有限,而相关环境(如成熟市场)可能积累了大量数据。直接混合数据会引入偏差,因为不同环境的奖励函数和转移动态存在差异。因此,迁移知识时必须显式建模并校正这些差异。
论文指出,现有迁移方法或依赖两阶段估计,或未能联合考虑奖励与动态的差异,导致迁移效果受限。DFQI的核心创新在于在贝尔曼更新中同时进行目标Q函数更新和源信息借用,实现更紧密的耦合。
拟合Q迭代(Fitted Q-Iteration, FQI) 是离线强化学习中的经典算法框架,属于批量强化学习(batch RL)方法。它不依赖在线交互,而是反复利用固定数据集进行贝尔曼备份:在每一轮迭代中,以当前Q函数对数据集中的状态-动作对计算目标值,再通过回归(即“拟合”)更新Q函数,直至收敛。FQI的优点是实现简单、样本效率高,但其性能高度依赖数据覆盖度和函数近似器的质量。在跨环境迁移场景中,FQI的迭代结构为“在每次贝尔曼更新时注入源环境信息”提供了天然的切入点,DFQI正是基于这一框架进行改造的。
DFQI方法:L1惩罚链接源与目标
DFQI采用拟合Q迭代(Fitted Q-Iteration)框架,在每次贝尔曼更新中,目标Q函数通过最小化贝尔曼误差来更新,同时引入一个L1惩罚项,将目标系数与源系数的加权聚合链接起来。具体地,目标系数被拉向源系数的加权组合,权重由数据自适应确定。这种设计允许在目标数据稀缺时更多地借用源信息,而在目标数据充足时减少影响。
L1惩罚还带来稀疏性,有助于识别哪些源信息对目标最有价值。联合估计确保源系数和目标系数在同一个优化问题中求解,避免了误差累积。论文使用筛网近似(sieve approximation)处理高维状态空间,为统计性质分析奠定基础。
筛网近似(sieve approximation) 是统计学习理论中处理高维或非参数估计的一种技术。其核心思想是用一列逐渐增大的有限维函数空间(称为“筛网”)去逼近无限维的目标函数空间,随着样本量增加,筛网复杂度也相应增长,从而在偏差与方差之间取得平衡。在离线RL中,状态空间可能连续且高维,直接使用非参数方法会导致收敛速率极慢;筛网近似通过控制函数类的复杂度(如使用多项式基、小波基或神经网络等),使得统计估计量具有可分析的收敛性质。DFQI利用筛网近似对Q函数进行建模,为后续建立目标估计和策略学习的统计保证奠定了理论基础。
统计保证与理论结果
作者在平稳折扣环境下建立了目标估计和策略学习的统计保证,覆盖了同质和异质转移核两种情形。理论分析表明,在一定的正则条件下,DFQI的目标Q函数估计和策略价值收敛速率与仅使用目标数据的估计器相当,同时能有效利用源数据降低方差。对于异质转移核,DFQI通过加权聚合自动调整源信息的贡献,避免负迁移。
这些理论结果为迁移学习在离线RL中的可行性提供了严谨支撑,也解释了L1惩罚项在偏差-方差权衡中的作用。
负迁移(negative transfer) 是指源环境的知识反而损害目标环境学习性能的现象。在迁移学习中,当源环境与目标环境的奖励函数或转移动态差异较大时,强行借用源数据会引入偏差,导致目标策略次优甚至发散。DFQI通过L1惩罚项对源系数进行加权聚合,权重由数据自适应确定:当目标数据充足或源信息不相关时,惩罚项会压缩源系数的贡献,从而自动抑制负迁移。理论分析中,异质转移核情形下的收敛保证正是刻画了这种自适应机制的有效性,说明DFQI能够在利用源数据降低方差的同时,控制由环境差异带来的偏差。
实证效果:有限目标数据下的提升
实证研究进一步验证了DFQI的有效性。在多个模拟环境中,当目标数据有限时,DFQI通过迁移源信息显著提升了策略学习性能。对比基线(如仅用目标数据、简单数据混合等),DFQI在策略回报和稳定性上均表现出优势。论文还展示了L1惩罚如何自适应地选择相关源信息,减少不相关源的干扰。
说个细节,DFQI框架具有通用性,可扩展到其他基于价值迭代的离线RL算法。未来方向包括处理非平稳环境和更复杂的函数近似。
总结
DFQI为离线RL中的知识迁移提供了一种直接、联合的解决方案,通过L1惩罚链接源与目标系数,在贝尔曼更新中同时估计,并具备统计保证。对于数据稀缺的决策场景,这种迁移思路有望提升学习效率,减少对目标环境大量数据的需求。
相关推荐

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

Mistral Large 4开源权重发布:1万亿参数,激活49亿
Mistral Large 4开源权重发布:约1万亿参数、激活约49亿,支持图文与百万级上下文。解析厂商自测的编码与网络安全数据、修改版宽松许可、数据中心级硬件门槛,以及权重公开后不可回收的安全风险。

AgentScope 2.0实战:Java企业级AI Agent开发指南
AgentScope 2.0是阿里巴巴推出的Java企业级分布式智能体框架。本文解析它为何适合服务端AI应用,对比客户端AI应用在权限、状态管理、并发上的差异,并梳理从环境配置到项目联调的实战学习路线。