顶会论文泛滥:AI代写正在侵蚀学术信任

Reddit爆料AI顶会乱象,呼吁拒收AI生成论文以重建学术信任。
一位研究者在Reddit发帖,呼吁AI顶会采取更严格措施拒收AI生成论文,引发广泛共鸣。帖子描述了顶会现场的荒诞场景:作者无法解释论文中的基本概念,甚至当场用ChatGPT念答案;同一论文同时投中两个会议,代码仓库残留LLM提示词且数据全为伪造。发帖人指出,这导致诚实研究者受害、文献池被污染,研究者心态从“默认可信”转向“默认可疑”。现有同行评审因时间与手段限制难以识别此类论文。出路在于深度答辩、代码复现要求、严格查重与学术诚信文化重建,而非仅靠检测工具。
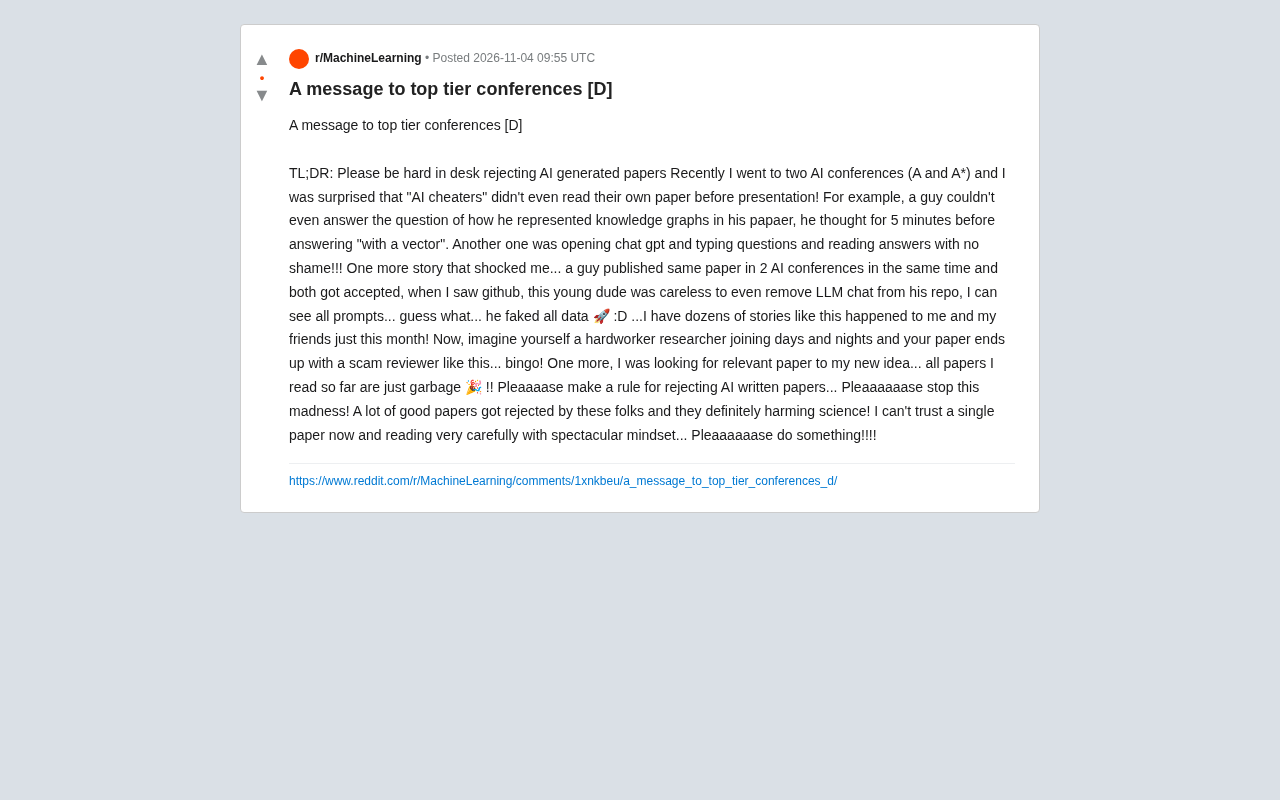
一位研究者在 Reddit 上发帖,呼吁顶会(top tier conferences)采取更严格的措施拒收 AI 生成的论文。帖子迅速引发共鸣,因为它戳中了一个正在蔓延的焦虑:当 AI 能轻松生成看似完整的论文时,学术会议的质量防线还守得住吗?
现场观察:连作者自己都不懂自己的论文
发帖人描述了自己在近期参加的两场 AI 顶会(A 和 A*)上的见闻。一位演讲者在被问及论文中如何表示知识图谱时,思考了五分钟才回答“用向量”。另一位则毫无顾忌地当场打开 ChatGPT,输入问题后照着答案念。更令人震惊的是,有人将同一篇论文同时投中两个 AI 会议,两边都被接收,而且在 GitHub 仓库里连与大模型对话的提示词都没清理,全部数据都是伪造的。
这些不是孤例。发帖人表示,仅一个月内,他和朋友就积累了几十个类似的故事。
勤奋研究者的困境与科学的信任危机
发帖人将矛头指向了系统性后果:辛苦熬夜写论文的诚实研究者,可能因为“骗子审稿人”而功亏一篑。当他为新想法检索相关文献时,发现“读到的所有论文都是垃圾”。这种感受并不孤单——当 AI 生成内容大量涌入,审稿人需要花费更多精力才能甄别,而劣质论文的通过又进一步污染了文献池。
最核心的担忧在于信任崩塌。“我现在无法相信任何一篇论文,”发帖人写道,他不得不以极其审慎的心态逐字阅读。这种从“默认可信”到“默认可疑”的转变,正是学术交流生态受到侵蚀的信号。
为什么现有的同行评审难以应对?
同行评审依赖审稿人的专业判断,但 AI 生成的论文在形式上往往完整、逻辑自洽,甚至能引用真实文献。问题在于,审稿人通常没有时间或手段去验证数据真实性、代码可复现性以及作者对内容的实际理解深度。当作者本人无法解释基本概念时,评审环节本应成为过滤器,但现实是这些论文已经通过了评审。
发帖人呼吁顶会制定明确的规则,拒收 AI 生成的论文。这并非反对 AI 辅助写作,而是要求作者对论文内容具备实质性的掌握。如果连知识图谱的表示方式都答不上来,论文的原创性和真实性就值得怀疑。
同行评审(Peer Review) 是学术出版的核心质量保障机制:作者投稿后,由同领域专家(通常2-4人)匿名或公开评审,评估论文的创新性、方法严谨性与表述清晰度,给出接收、修改或拒稿建议。它依赖的是评审人的专业判断与学术共同体信誉,而非形式化检查。正因如此,它对“形式完整但实质空洞”的内容缺乏免疫力——AI生成的论文往往结构规范、术语堆砌合理,恰好能通过初筛。加之评审多为无偿劳动、时间有限,评审人难以逐一复核数据与代码,这套机制在投稿量激增时更显脆弱。
可能的出路:从规则到文化
单纯依靠检测工具并不可靠,AI 生成文本的检测本身存在高误判率。更可行的方向包括:加强答辩环节的深度提问、要求代码与数据公开可复现、对同一论文多投进行严格查重、以及在评审中增加对作者理解程度的考察。
但技术手段只能解决一部分问题。发帖人的愤怒背后,是对学术诚信文化被稀释的担忧。当“发表”成为目标而非“贡献知识”时,AI 只是加速了这种异化。顶会需要的不只是一条拒稿规则,而是重申学术共同体的基本契约:作者必须对自己写下的每一个字负责。
对于研究者个体而言,这个帖子也是一个提醒:在 AI 工具唾手可得的时代,真正的竞争力仍然是对问题的深刻理解与诚实工作。那些靠 ChatGPT 念答案的人,终将在某个提问面前露出破绽。
AI生成文本检测 目前主要依赖统计特征(如词频分布、困惑度)或水印技术,但面对经过改写、润色或人机协作产出的文本,误判率与漏判率都较高。更根本的问题是,检测工具只能判断“是否像AI写的”,无法判断“作者是否理解内容”,而后者才是学术诚信的实质。因此业界逐渐转向过程性验证:要求代码与数据公开、设置可复现性检查、在答辩中追问方法细节。这些手段不依赖检测器的准确性,而是通过可验证的证据链来约束作者,这也是发帖人呼吁的规则方向更可行的原因。
相关推荐

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

Mistral Large 4开源权重发布:1万亿参数,激活49亿
Mistral Large 4开源权重发布:约1万亿参数、激活约49亿,支持图文与百万级上下文。解析厂商自测的编码与网络安全数据、修改版宽松许可、数据中心级硬件门槛,以及权重公开后不可回收的安全风险。

AgentScope 2.0实战:Java企业级AI Agent开发指南
AgentScope 2.0是阿里巴巴推出的Java企业级分布式智能体框架。本文解析它为何适合服务端AI应用,对比客户端AI应用在权限、状态管理、并发上的差异,并梳理从环境配置到项目联调的实战学习路线。