do-calculus 为何不够用?因果效应普适可识别性研究新进展

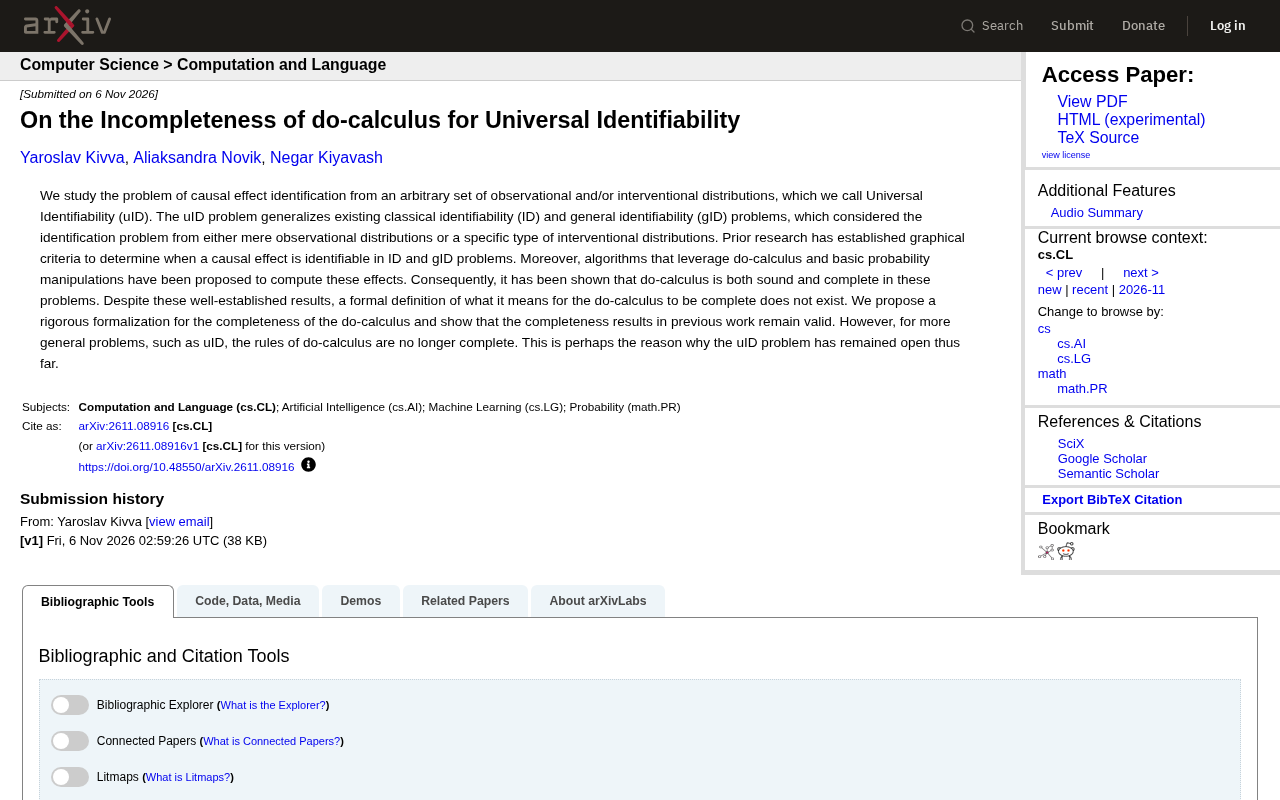
新研究形式化定义 do-calculus 完备性,证明其在普适可识别性问题中不再完备。
因果推断长期依赖 do-calculus 作为识别因果效应的核心工具,但一项新研究揭示了它的边界。论文首先将经典可识别性(ID)和一般可识别性(gID)统一推广为普适可识别性(uID)问题,允许任意观测分布和/或干预分布集合作为输入。作者指出,学界此前从未严格定义“do-calculus 完备”的含义,为此提出了一个严格的形式化框架,并在此框架下确认 do-calculus 在 ID 和 gID 中依然完备。然而核心结论是:在 uID 问题中 do-calculus 不再完备,存在可识别但无法用 do-calculus 规则推导的因果效应。作者推测这正是 uID 问题长期未解的原因,提示未来需要超越 do-calculus 的新推理规则或图形化判据。对实践者而言,当数据来源混杂时不能默认 do-calculus 能覆盖所有可识别效应。
因果推断领域长期依赖 do-calculus 作为核心工具,但一项新研究揭示了它的边界:在更一般的普适可识别性问题中,do-calculus 的规则不再完备。这篇论文不仅给出了 do-calculus 完备性的严格形式化定义,还解释了为何 uID 问题迟迟未能解决。
从经典可识别性到普适可识别性
因果效应识别旨在回答:仅凭观测数据和部分干预数据,能否唯一确定某个因果量?经典的可识别性(ID)问题只考虑观测分布,一般可识别性(gID)问题则限定于特定类型的干预分布。两者都有成熟的图形化判定准则,以及基于 do-calculus 和基本概率操作的计算算法。
论文提出的普适可识别性(uID)问题将上述两类问题统一推广:给定任意一组观测分布和/或干预分布,判断目标因果效应是否可识别。这一推广覆盖了更广泛的现实场景,例如当研究者只能获取某些干预下的数据,而干预集合本身是任意的时候。
do-calculus 是 Judea Pearl 提出的一套用于从因果图中推导干预分布的公理系统,包含三条核心规则(插入/删除观测、插入/删除干预、插入/删除动作),它们分别对应 d-分离等图条件。do-calculus 的可靠性(soundness)指规则推导出的表达式正确,完备性(completeness)指所有可识别的因果效应都能通过规则推导出来。在经典 ID 问题中,do-calculus 已被证明既是可靠的也是完备的。
ID、gID 与 uID 的区别:ID 问题仅给定观测分布,判断干预分布 P(y|do(x)) 是否可识别;gID 问题给定观测分布和某一类干预分布(如 P(v|do(z))),判断另一干预分布是否可识别;uID 则允许任意混合的观测分布和干预分布集合作为输入,判断目标因果量是否可识别。uID 的输入是分布集合而非单一分布,因此其可识别性定义需要处理多个分布之间的约束关系,这也是它比前两者更一般、也更困难的原因。
do-calculus 完备性:一个缺失的形式化定义
尽管此前工作已证明 do-calculus 在 ID 和 gID 问题中既可靠又完备,但论文指出,学界从未严格定义过“do-calculus 完备”究竟意味着什么。这种定义上的模糊性导致无法精确比较不同问题中 do-calculus 的能力边界。
作者为此提出了一个严格的形式化框架来刻画 do-calculus 的完备性,并在此框架下重新验证了先前工作的完备性结论依然成立。这一形式化本身具有独立价值:它为后续讨论 do-calculus 在更复杂问题中的表现提供了共同语言。
在因果推断文献中,“完备性”通常有两种含义:语义完备性指如果因果效应在某个因果模型类中可识别,则存在一个表达式能由允许的操作推导出来;语法完备性指推导系统能生成所有可识别的表达式。此前工作对 do-calculus 完备性的证明多依赖于构造性算法(如 ID 算法、gID 算法),但并未明确“do-calculus 规则集”与“基本概率操作”的边界——例如,是否允许使用条件独立假设、贝叶斯规则、边缘化等。论文的形式化定义正是要固定这些操作,从而精确刻画“仅用 do-calculus 能推出什么”。
普适场景下 do-calculus 不再完备
论文的核心结论是:当问题推广到 uID 时,do-calculus 的规则不再完备。换言之,存在某些在 uID 框架下可识别的因果效应,无法仅通过 do-calculus 的规则和基本概率操作推导出来。
作者推测,这正是 uID 问题长期悬而未决的原因——研究者一直试图在 do-calculus 的框架内寻找判定准则和计算算法,而该框架本身在普适设定下已经不够用了。这一发现提示,解决 uID 问题可能需要超越 do-calculus 的新推理规则或新的图形化判据。
可识别但不可推导的直观例子:假设我们有两个干预分布 P(y|do(x)) 和 P(z|do(x)),以及一个观测分布 P(x,y,z),目标量是 P(y|do(x), do(z))。在 uID 框架下,某些情况下该目标量可由多个分布的组合唯一确定,但 do-calculus 的三条规则只能作用于单个分布内的图操作,无法跨分布组合信息,因此无法生成对应的表达式。这揭示了 do-calculus 的局部性:它设计用于单一分布内的干预推导,而 uID 需要跨分布的全局推理。
对因果推断实践的意义
对于应用因果推断的研究者而言,这项工作的价值在于明确了工具边界。当数据来源混杂了观测分布和多种干预分布时,不能默认 do-calculus 能给出全部可识别的因果效应。实践者需要意识到,某些效应虽然在理论上可识别,但现有基于 do-calculus 的算法可能无法找到对应的表达式。
论文并未给出 uID 问题的完整解法,但它将问题从“算法设计”层面提升到了“推理系统完备性”层面。后续研究若要突破 uID,可能需要引入新的识别规则,或重新审视干预分布集合的结构性质。
实践中的检查清单:当数据包含多个来源(如不同干预下的实验数据与观测数据混合)时,建议先判断问题是否属于 uID 范畴。若属于,则不应仅依赖 do-calculus 工具(如 DoWhy 等库中的识别算法),而应尝试基于分布集合的联合约束进行手动推导,或使用论文提出的形式化框架验证可识别性。此外,若目标效应在理论上可识别但 do-calculus 无法找到表达式,可能需要借助数值优化或半参数方法直接估计,而非寻找解析表达式。
相关推荐

Hermes Agent零基础教程:自进化AI智能体实战
Hermes Agent零基础教程:详解这个GitHub两月获41.7K星的开源自进化AI智能体,从Harness Engineering核心理念、学习循环、三层记忆系统到WSL安装与实战配置,小白也能轻松上手。
AI Agent落地实战:用WorkBuddy打造智能办公助理
本文通过实战案例演示如何用腾讯WorkBuddy完成文件批量转换与归档,对比聊天大模型与AI Agent的能力差异,分析WorkBuddy的积分体系、适用场景与产品定位,为办公自动化选型提供参考。
从单卡瓶颈到千亿参数:大模型分布式并行6大关键问题
基于B站教程梳理大模型分布式并行核心知识:从decoder-only架构的逐token生成与X乘W计算本质出发,解析单卡瓶颈下数据并行、张量并行、流水线并行等6个关键问题,适合私有化部署与模型训练场景的学习者建立系统认知。