冻结基座+轻量校正:让语言模型改错不丢能力
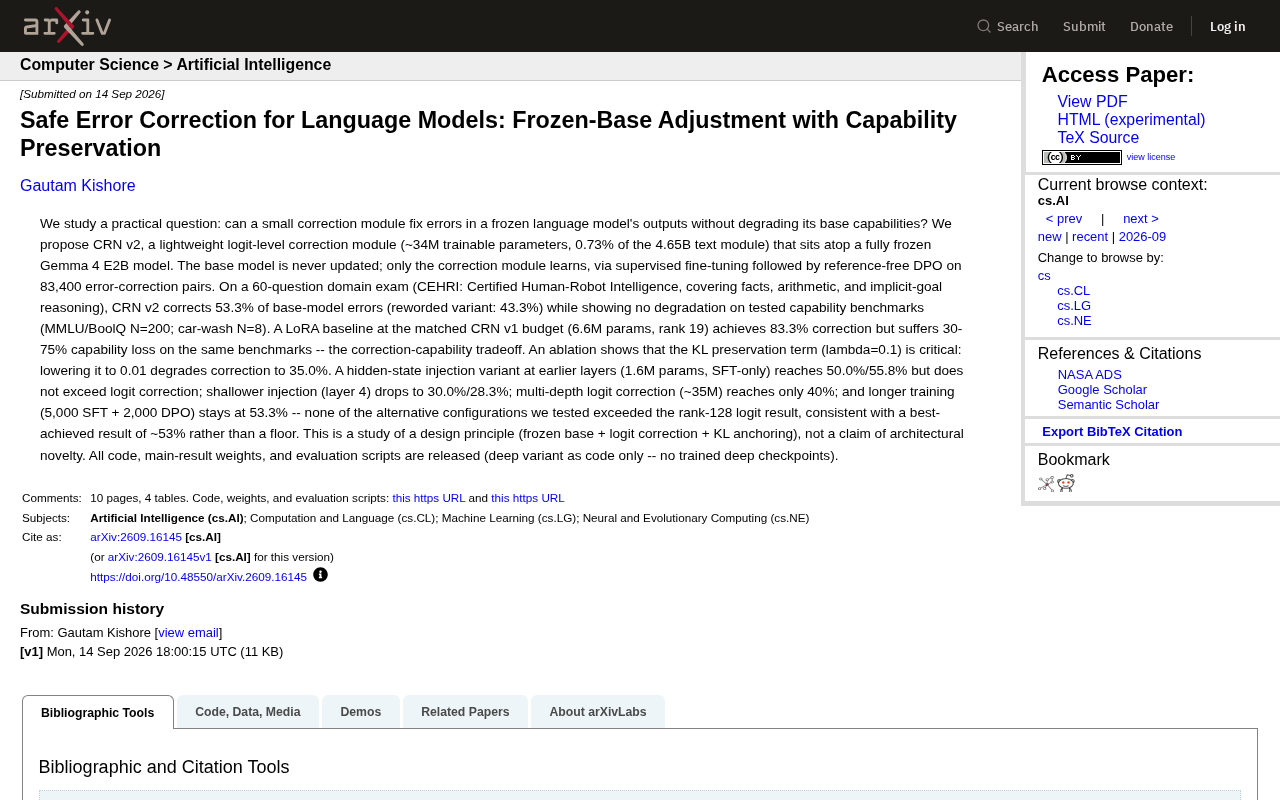
CRN v2 用占基座参数不到1%的冻结外挂模块,实现53%纠错率且零能力损失。
这篇论文提出 CRN v2,一种工作在 logit 层面的轻量校正模块(约3400万参数),扣在完全冻结的 Gemma 4 E2B 基座之上,通过监督微调与无参考版 DPO 训练,在领域考试 CEHRI 上纠正了基座模型 53.3% 的错误,且在 MMLU/BoolQ 等通用基准上没有任何能力退化。对比实验中,参数更少的 LoRA 基线纠错率高达 83.3%,却伴随 30%–75% 的能力损失,清晰勾勒出"纠错-能力权衡"曲线。消融实验进一步揭示 KL 锚定项是核心杠杆,系数从 0.1 降至 0.01 会使纠错率从 53.3% 跌至 35%。作者将这项工作定位为设计原则验证(冻结基座 + logit 校正 + KL 锚定),而非架构创新,并开源了代码与主要权重,为不能或不愿改动基座模型的实际部署场景提供了一个可复用的安全纠错范式。
一个绕不开的取舍:改错 vs 保能力
大语言模型出错时,我们通常有两条路可走:微调整个模型,或者外挂一个校正模块。前者能高效纠错,却往往以牺牲模型原有能力为代价。一篇最新的 arXiv 论文(arXiv:2609.16145)正面回应了这个问题——能否在完全冻结基座模型的前提下,用一个极小的校正模块修复输出错误,同时不损害它的通用能力?
研究团队提出的方案叫 CRN v2,这是一个工作在 logit 层面的轻量校正模块,仅有约 3400 万可训练参数,相当于 46.5 亿参数文本模块的 0.73%。它像一顶帽子一样扣在冻结的 Gemma 4 E2B 模型之上,基座权重全程不动,只有校正模块在学习。
CRN v2 是如何工作的
训练流程分两步:先做监督微调(SFT),再做无参考版 DPO(reference-free DPO),使用了 83,400 对错误-纠正样本。整个设计的核心是三个原则的组合:冻结基座、logit 层校正、以及 KL 锚定(KL anchoring)。
评测在一个名为 CEHRI(Certified Human-Robot Intelligence)的 60 题领域考试上进行,涵盖事实性问题、算术运算和隐含目标推理三类任务。结果显示,CRN v2 纠正了基座模型 53.3% 的错误;在改写变体(措辞重排)上仍能纠正 43.3%。
更关键的是能力保持:在 MMLU/BoolQ(N=200)和 car-wash(N=8)等基准上,CRN v2 没有出现任何能力退化。这正是它想证明的价值所在——纠错不必以遗忘为代价。
无参考版 DPO(reference-free DPO) 是直接偏好优化(Direct Preference Optimization)的一种变体。标准 DPO 需要一个"参考模型"来计算策略偏移的 KL 惩罚项,而无参考版本则通过隐式方式替代这一角色,无需在训练时保存并查询一个完整的参考模型副本,从而显著降低显存占用。在 CRN v2 的设定中,由于基座模型已被冻结,其输出 logit 天然可以充当参考分布,KL 锚定项(KL anchoring)正是以此为基础——直接约束校正后的 logit 分布不过度偏离冻结基座的原始输出,既减少了对参考模型的额外依赖,又将"保持原有能力"这一目标内嵌到了优化目标本身。
与 LoRA 基线的正面对比
为了凸显取舍关系,论文用一个匹配 CRN v1 预算的 LoRA 基线做对照:660 万参数、rank 19。这个 LoRA 方案的纠错率高达 83.3%,看起来遥遥领先。
但代价惊人——它在相同基准上出现了 30% 到 75% 的能力损失。这就是研究者反复强调的"纠错-能力权衡"(correction-capability tradeoff):一味追求高纠错率,很可能把模型原本擅长的东西一并破坏掉。CRN v2 用略低的纠错率,换来了零能力损失,这在很多实际部署场景中是更划算的交易。
LoRA(Low-Rank Adaptation) 是一种参数高效微调方法,其核心思想是:不直接修改模型的完整权重矩阵,而是在原权重旁边插入一对低秩矩阵(rank 决定秩的大小),只训练这对低秩矩阵的参数。rank 越高,可训练参数越多,拟合能力越强,但同时对原始权重分布的扰动也越大。论文中用于对比的 LoRA 基线采用 rank 19、660 万参数,虽然参数量更少,但由于它直接修改了基座权重的有效分布,模型在目标任务上的纠错能力大幅提升的同时,其他任务的表现也随之漂移。这与 CRN v2"基座权重完全冻结"的设计形成了鲜明对比,也正是两者能力保持差异悬殊的根本原因。
KL 保持项是不可或缺的关键
消融实验揭示了一个决定性因素:KL 保持项(lambda=0.1)至关重要。当把这个系数降到 0.01 时,纠错率从 53.3% 直接跌到 35.0%。这说明 KL 锚定不仅仅是防止能力退化的安全带,它本身也参与撑起了纠错的有效性。
换句话说,这个设计的精妙之处在于——约束与性能并非对立。适度的 KL 约束反而稳定了校正模块的学习方向。
KL 散度(Kullback-Leibler Divergence) 是衡量两个概率分布之间差异的指标,常用于语言模型训练中防止策略偏移过大。在 RLHF 和 DPO 等对齐方法里,KL 惩罚项的作用是让训练后的模型不要"跑得太远"——输出分布应与参考分布保持一定相似度。CRN v2 中的 KL 锚定系数 lambda=0.1 扮演着双重角色:一方面防止校正模块过拟合到训练集的错误-纠正对,导致在其他任务上的输出分布崩坏;另一方面,适度的锚定约束相当于给梯度更新提供了正则化方向,反而让校正信号更稳定、更可泛化。消融实验中 lambda 从 0.1 降到 0.01 后纠错率骤降,说明过弱的锚定会让校正模块陷入不稳定的优化景观,而非单纯"限制了自由度"。
多种变体的探索:53% 更像是天花板
研究团队还测试了一系列替代配置,试图突破 53% 这个数字,但都没有成功:
- 隐藏状态注入变体(在较早层注入,160 万参数,仅 SFT):达到 50.0%/55.8%,但并未超越 logit 校正;
- 更浅层注入(第 4 层):跌到 30.0%/28.3%;
- 多深度 logit 校正(约 3500 万参数):只有 40%;
- 更长训练(5000 步 SFT + 2000 步 DPO):仍停在 53.3%。
没有任何一个替代方案超过 rank-128 的 logit 校正结果。研究者据此判断,约 53% 更像是当前方法能达到的最佳上限,而非可以轻易突破的下限。
这项研究的定位与价值
作者明确表示,这是一项关于设计原则的研究(冻结基座 + logit 校正 + KL 锚定),而非声称架构上的创新。这种诚实的定位反而让结论更可信——它验证的是一种可复用的工程范式,而不是又一个花哨的新模型。
对实际应用而言,这套思路有清晰的吸引力:当你手握一个不能或不愿改动的基座模型,又需要修补它在特定领域的错误时,外挂一个占比不到 1% 的轻量校正模块,比冒着能力崩坏风险去微调整个模型要安全得多。
值得肯定的是,团队公开了全部代码、主结果权重和评测脚本(深层变体仅提供代码,未附训练好的检查点),为后续复现和扩展留出了空间。
小结
CRN v2 的意义不在于把纠错率刷到多高,而在于它用严谨的对照实验把"纠错-能力权衡"这条曲线画了出来,并指出 KL 锚定是平衡两端的关键杠杆。对于关心模型可控性和安全部署的团队来说,这是一个值得参考的实用范式。
相关推荐
Claude挑战循环真相:Wayfinder技能修复AI一次构建应用
解析Claude挑战循环(Challenge Loop)的运作原理与两大致命缺陷,以及如何用Matt Pocock的Wayfinder技能生成可验证规格文件,让AI代理一次性构建真实项目而非仅限游戏演示。
Claude Code 令牌耗尽?7个隐藏消耗点审计与修复指南
Claude Code 总是提前撞上令牌限制?本文拆解 Token 复合增长的底层机制,梳理从 /clear 到定时任务的七个隐藏消耗点,并澄清短提示、压缩、截图等无效省钱建议,附实用自查命令与审计方法。
MiniMax H3实测:3步采样打造整首歌口型同步MV
一位创作者用MiniMax H3 Extender制作整首歌口型同步MV的完整实测:音频切片、htdemucs人声隔离、fully_copy保留语法、3步turbo LoRA提速,附三款LoRA对比与自动化质检方案。