多Agent交接的边界:该给什么,该藏什么?
多Agent交接的关键是设计有界工作切片,而非传递全部上下文。
文章围绕多Agent工作流中的交接问题展开,指出核心矛盾在于上下文给多会淹没Agent、给少会让其瞎猜。作者提出交接的本质是界定一个有界工作切片,而非传递状态,并分析了切片过宽与过窄的两种失败症状。针对Coder,交接内容取决于改动耦合度,依赖可按必须与参考分层;针对Reviewer,必须提供spec,因为diff和测试日志只能证明改了什么,无法判断是否改对。切片过窄时,优先让Agent请求命名依赖并返回有界摘录,回退更多历史仅作兜底。最终提炼出一条规则:最小充分集加明确意图说明,再加有界求助通道。
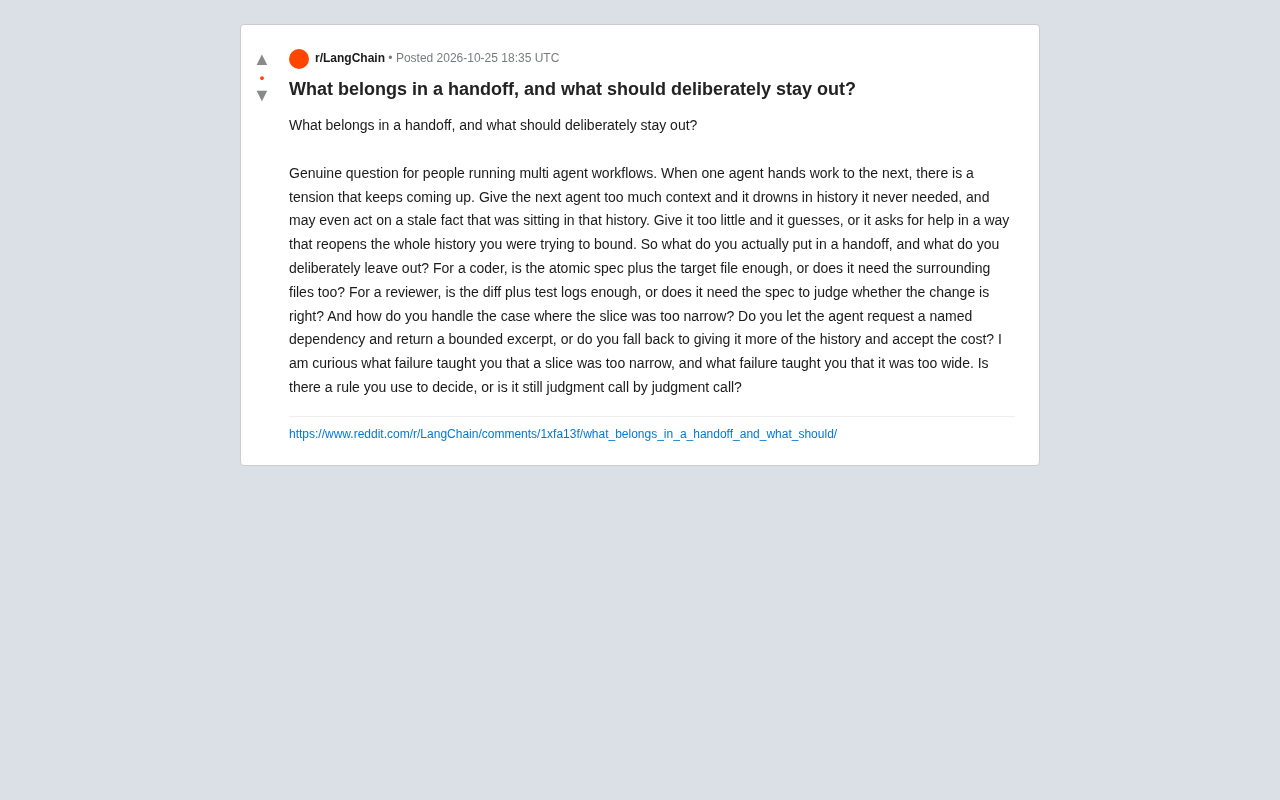
多Agent工作流里最微妙的一环,往往不是单个Agent有多强,而是它们之间怎么"递活儿"。Reddit上一位开发者的提问戳中了痛点:交接时给的上下文太多,下一个Agent会淹没在无关历史里,甚至拿过时事实当依据;给得太少,它只能瞎猜,或者以重新打开全部历史为代价来求助。
这不是一个能靠拍脑袋解决的问题。它背后是上下文工程的取舍:哪些信息是完成任务的最小充分集,哪些是噪音甚至毒药。
交接的本质:界定一个可执行的工作切片
把交接理解为"传递状态"是常见的误区。更准确的说法是:交接是在定义一个有界的工作切片——它包含完成当前原子任务所需的全部信息,同时刻意排除会干扰判断的内容。
原文提问者把这个张力描述得很清楚:历史太多,Agent可能"对一条躺在历史里的过期事实采取行动";历史太少,它会请求帮助,而请求的方式往往是把你想限制住的整个历史重新打开。这个观察指向一个关键结论:上下文不是越多越好,而是越相关越好。多Agent系统的性能瓶颈,常常不在模型能力,而在交接界面设计。

宽与窄的两种失败
提问者追问了一个很有意思的角度:什么失败教会你切片太窄,什么失败教会你切片太宽?这其实是把交接设计从理论拉回到经验层面。
切片太窄的典型症状是Agent反复询问、请求额外文件、或者基于不完整信息做出看似合理实则错误的推断。切片太宽的症状则更隐蔽:Agent开始引用与当前任务无关的模块、沿用旧决策、或者在review时偏离本次改动范围。前者是显性失败,后者是隐性失败——因为它看起来"考虑周全",实则污染了判断。
上下文工程(Context Engineering) 是指为语言模型或Agent系统主动设计、筛选和组织输入上下文的过程,区别于仅靠提示词措辞来引导模型。其核心假设是:模型的推理质量高度依赖输入中信息的密度与相关性,无关或过时的内容会挤占注意力并诱发错误推断。在多Agent系统中,上下文工程具体表现为决定每个Agent在每个时刻能看到哪些历史、文件、工具输出和指令。它强调“最小充分集”原则——即用恰好足够完成任务的信息,而非尽可能多的信息。这也解释了为什么交接界面设计会成为性能瓶颈:模型能力再强,若上下文被噪音污染,判断仍会失准。
有界工作切片(Bounded Work Slice) 借鉴了软件工程中“限界上下文”的思想,指为某个原子任务划定明确的信息边界:切片内包含完成任务所需的全部事实、约束和接口定义,切片外则刻意排除无关历史与旁支决策。它的价值在于同时防止两类失败——信息过载导致的“淹没”和信息缺失导致的“瞎猜”。在实践中,切片边界通常由任务类型、改动耦合度和角色需求共同决定,例如Coder的切片围绕目标文件与直接依赖,Reviewer的切片则必须包含意图说明(spec)与证据(diff、日志)。切片不是静态的,当Agent发现信息缺口时,需要有结构化的通道申请扩展边界。
给Coder:原子规格加目标文件,够不够?
原文提出的具体问题很实在:对一个写代码的Agent,原子spec加目标文件是否足够,还是需要周边文件?
这取决于改动的耦合度。如果任务是纯函数级别的修改——输入输出明确、不依赖外部状态——那么原子spec加目标文件基本足够。一旦涉及接口调用、共享数据结构或跨模块约定,周边文件就成了必要的上下文,否则Agent会发明一个不存在的API或误解类型。
一个实用做法是把依赖按"必须"和"参考"分层:必须依赖随交接一并给出,参考依赖只给签名或摘要。这样既避免了信息过载,又不至于让Agent在关键接口上瞎猜。
原子规格(Atomic Spec) 指针对单一、不可再分任务的精确描述,通常包含输入输出约定、边界条件、错误处理和验收标准,而不掺杂更大范围的设计讨论或历史决策。它的作用是让执行者明确“这一次要做什么、做到什么程度算完成”,从而避免因目标模糊而自行发明需求。在多Agent交接中,原子规格是切片的核心锚点:它既约束Coder不要越界修改,也为Reviewer提供判断对错的意图依据。原子规格的质量取决于是否可验证——若验收标准无法用测试或明确检查表达,规格就退化为模糊描述,交接双方都只能靠猜。
给Reviewer:diff加测试日志,还是需要spec?
原文对reviewer的提问更有张力:diff加测试日志够不够,还是需要spec来判断改动是否正确?
答案是后者。diff能告诉reviewer"改了什么",测试日志能告诉它"测试过什么",但只有spec能告诉它"应该是什么"。没有spec,reviewer只能做风格和局部逻辑检查,无法判断这次改动是否真正解决了问题,甚至可能放过一个"测试全绿但方向错误"的提交。
这里的交接设计原则是:reviewer需要的是意图加证据,而不是单纯的证据。spec提供意图,diff和日志提供证据,三者缺一不可。

切片太窄时:请求命名依赖,还是回退更多历史?
原文给出的两个选项值得拆解:让Agent请求一个命名依赖并返回有界摘录,还是回退到给更多历史并接受成本。
前者是更优雅的方案。它把"我需要更多信息"变成一个结构化的、有界的请求:Agent必须说出它要什么(命名依赖),系统只返回相关摘录。这避免了重新打开整个历史,也迫使Agent明确自己的信息缺口。
后者是兜底方案,代价是上下文膨胀和潜在的历史污染。两者的取舍点在于:如果命名依赖机制能覆盖大多数情况,就应优先使用;只有当请求本身难以结构化时,才回退到更宽的历史。
原文提问者坦言这"仍是逐个判断",没有放之四海皆准的规则。这个诚实很重要——交接设计目前更像一门手艺,而不是一套公式。
命名依赖(Named Dependency) 是一种结构化的求助机制:当Agent发现当前切片信息不足时,不重新拉取全部历史,而是明确说出它所缺的具体对象——某个文件、某个接口定义、某条决策记录——系统据此返回有界摘录。它把模糊的“我需要更多上下文”转化为可审计、可限流的请求,既保护了上下文预算,也迫使Agent自我定位信息缺口。其局限在于依赖必须可被命名;若Agent连自己缺什么都不知道,命名请求就难以发起,此时才需要回退到更宽的历史。设计良好的命名依赖机制通常配有白名单和摘录长度上限,防止变相全量加载。
一条可操作的判断规则
虽然没有万能公式,但可以从原文的讨论中提炼一条经验规则:交接内容 = 完成当前任务的最小充分集 + 明确的意图说明 + 有界的求助通道。
最小充分集保证Agent不被淹没;意图说明让reviewer类角色能判断对错;有界求助通道则在切片确实太窄时提供逃生口,而不至于让整个历史重新涌入。三者配合,才能在"淹死"和"饿死"之间找到那条窄路。
多Agent协作的成熟度,最终体现在这些交接界面的细节上。模型会继续变强,但上下文边界的取舍,仍然需要人来设计。
相关推荐
亲手构建Agent:理解AI Agent的最佳路径
想真正理解AI Agent?本文分享如何从零构建一个最小Agent,拆解大模型与Harness的分工,推荐PiAgent、DeepSeek Harness等学习型框架,并给出八个递进阶段和RAG与Agent的关系分析。
从零构建最小Agent:手把手教你写AI循环调用代码
跟随B站教程从零编写一个最小AI Agent:定义工具schema与finish信号,设计system/user prompt,实现带最大步数限制的循环调用,解析工具调用结果并修复finish后未跳出循环的bug。
Kimi K3.1 Pro实测:开源模型能否挑战Opus 5.5?
Kimi K3.1 Pro实测对比Opus 5.5和DeepSeek V4.1 Flash:基准测试亮眼,但MOBA游戏开发任务暴露短板。速度接近Opus,成本接近DeepSeek,成为开源模型中的性价比之选。