亲手构建Agent:理解AI Agent的最佳路径
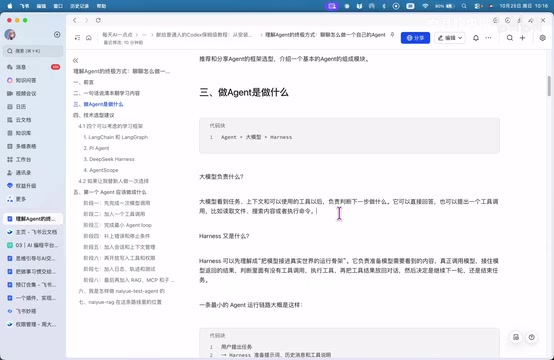
Agent等于大模型加Harness,亲手实现最小循环是理解它的最佳方式。
文章指出,使用AI编程助手时常有一个误解,以为大模型亲自读文件、执行命令。实际上大模型只接收和输出消息,真正执行动作的是Agent Harness。作者引用“Agent = 大模型 + Harness”的公式,说明模型负责决策、Harness负责执行,并拆解了最小Agent的七步运行线路。文章还比较了LangChain/LangGraph、PiAgent、DeepSeek Harness、AgentScope四个学习型框架,推荐优先考虑后两者,并给出把第一个Agent做成只读文件助手、分八个阶段递进实现的路径,最后澄清RAG与Agent是两回事,建议先完成最小Agent再单独学习RAG。
为什么说“做一个Agent”是理解它的终极方式
很多人在使用Codex这类AI编程助手时,会默认一个错误的前提:大模型亲自读取文件、执行命令、修改代码。实际上,大模型只做一件事——接收消息,输出消息。真正帮你打开文件、运行命令、申请权限的,是Agent Harness(运行骨架)。
据B站UP主奈月在“Codex保姆级教程”系列最后一期中的观点,想要真正理解Agent,最好的方式不是继续看概念,而是亲手做一个自己的Agent。这个Agent不需要像Codex那样功能强大、界面精美,只要能完成一条最小主线:接收用户消息、调用一次模型、执行一次工具调用、把结果交回模型、最终返回答案,就足以打通对Agent核心机制的理解。
DeepSig给出了一个简洁的公式:Agent = 大模型 + Harness。大模型负责决策,Harness负责执行。
Agent的核心:大模型与Harness的分工
大模型的工作边界非常清晰:它只能接收语言消息(包括用户输入、系统提示词、工具说明等上下文),然后输出语言消息。当它需要操作外部世界时,会在输出中声明一个工具调用请求,但真正执行这个请求的是Harness。
Harness是一个工程问题,它负责:准备发给模型的消息(系统提示词、工具说明、历史对话)、实际调用模型、解析模型返回的工具调用请求、执行工具、把工具结果追加到对话中、再次调用模型,如此循环直到模型给出最终回答。
据YouTube频道“AI工程笔记”的交叉分析,同一个模型在不同产品中表现差异巨大,核心原因就在于Harness的适配质量。把DeepSeek广告模型接入Codex效果不佳,往往不是模型本身的问题,而是Codex作为Harness对该模型的适配不够好。
工具调用协议(Tool Calling / Function Calling) 是大模型与 Harness 协作的关键接口。模型在输出中并非直接执行代码,而是按照约定的 JSON 结构声明“我要调用某个工具、传什么参数”,例如 {"name": "read_file", "arguments": {"path": "a.txt"}}。Harness 解析这段结构化输出,校验参数合法性,再真正调用本地函数或外部 API。这一机制让模型的“意图”与“执行”解耦:模型只需理解何时该用哪个工具,而不必关心工具如何实现。不同厂商的协议细节略有差异(如 OpenAI 的 function calling、Anthropic 的 tool use),但核心思想一致——用结构化消息表达动作意图。理解这一协议是读懂 Agent 循环的前提。
最小Agent的运行线路
一个最小Agent的完整运行线路可以拆解为:
- 用户发送一条消息
- Harness准备提示词、示例消息和工具说明
- 第一次调用大模型
- 模型返回工具调用请求
- Harness检查工具参数并执行工具
- Harness将工具结果加入消息,再次调用模型
- 模型判断结果是否足够,足够则给出最终回答,否则继续请求工具调用
这个过程在Codex中被完全隐藏,用户只感知到“发一条消息、收一条回复”,但实际上一次交互可能包含多次模型调用和工具执行。
Agent 循环(Agent Loop) 指的是“模型输出工具调用 → Harness 执行 → 结果回填 → 再次调用模型”这一反复进行的控制流。它的终止条件通常是模型不再请求工具、而是直接给出面向用户的最终回答。循环中每一轮都会把历史消息(含此前的工具结果)重新发给模型,因此上下文会不断增长,这也是为什么需要上下文管理。循环次数需要上限保护,防止模型陷入反复调用同一工具的“死循环”。理解循环的边界条件、消息累积方式和退出判断,是区分“会调一次模型”和“真正做出 Agent”的分水岭。
框架选型:四个值得关注的Agent框架
奈月推荐了四个适合“学习目的”的框架,而非生产级SDK。选择哪个取决于你的语言偏好和学习目标:
- LangChain / LangGraph:老牌框架,抽象完整,支持Python和JS/TS。优点是生态成熟,缺点是抽象层次较高,可能用了也不理解底层原理。
- PiAgent:最推荐给想先读懂源码再动手的人。代码量约1万行,分三层——底层负责调用模型,中层实现Agent循环,上层处理Harness。唯一门槛是TS。
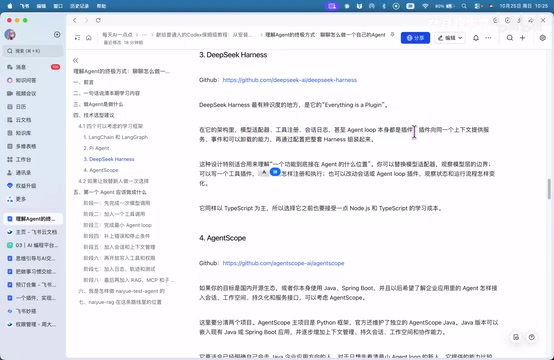
- DeepSeek Harness:插件化设计是最大亮点,模型适配器、工具、日志甚至循环本身都是插件,可以自由替换任何一层来观察变化。同样是TS为主。
- AgentScope:国内开源框架,主项目Python,官方维护独立Java版本,适合有Java基础、想了解企业级实现的开发者。
据B站UP主奈月和教程文档的共识,不建议同时学四个框架,选一个即可。AI时代框架的重要性在下降,核心是理解循环和Harness的职责划分。
第一个Agent的八个阶段
奈月建议第一个Agent做成“本地读文件小助手”,只开放三个只读工具:列出工作目录文件、读取文件、搜索内容。只读设计避免了误删误改的顾虑。
八个递进阶段:
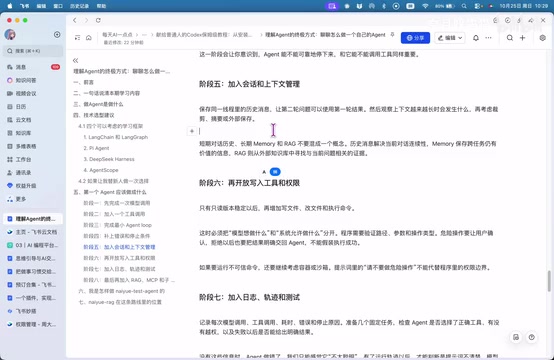
- 完成一次模型调用,做成可聊天的Agent
- 加入列出文件工具,学习模型如何提出工具调用参数
- 实现Agent循环,直到模型不再调用工具
- 加入错误处理和异常处理
- 加入会话与上下文管理(裁剪、摘要、Memory、RAG)
- 加入权限系统与人工审批
- 加入日志与轨迹可观测性
- 考虑MCP、RAG和子Agent
据奈月分享,他的个人项目NetworkTestAgent使用Python + LangChain + LangGraph,逐步增加了模型适配、文件工具、界面、权限人工审批、会话历史、Memory、MCP、子Agent后台任务等功能。但深入使用后发现LangChain存在版本破坏式更新、权限审批实现与主流不一致等问题,导致“用框架省代码”的初衷打折扣。他现在的建议是优先考虑PiAgent和DeepSeek Harness。
上下文工程(Context Engineering) 指在有限上下文窗口内,决定每一轮该把哪些信息送给模型。随着 Agent 循环推进,历史消息、工具结果会迅速膨胀,必须通过裁剪(丢弃旧消息)、摘要(压缩历史)、Memory(持久化关键信息)、RAG(按需检索外部知识)等手段控制输入规模与相关性。上下文工程直接决定 Agent 能否在长任务中保持稳定表现,也是 Harness 设计中最考验工程能力的一环,其重要性往往超过模型本身的选择。
RAG与Agent的关系
奈月特别澄清:RAG和Agent是两回事。RAG不影响最小Agent的构建,所以不建议一上来就学RAG。但做完Agent后,可以单独做一个RAG Agent来学习检索,因为知识库是Agent的典型应用场景。他设想的完整链路是:用户向主Agent提出任务,主Agent调用RAG Agent检索知识并总结,再返回主Agent,形成多Agent协作。
MCP(Model Context Protocol) 是一套用于标准化“模型如何接入外部工具与数据源”的开放协议。它把工具、资源、提示模板等能力抽象为统一的服务器接口,让 Agent 无需为每个数据源写定制集成代码,就能动态发现并调用外部能力。可以把 MCP 理解为工具层的“USB 接口”:Harness 作为客户端连接各个 MCP 服务器,模型则通过工具调用协议间接使用它们。这也是为什么文章把 MCP 放在较后阶段——它属于在最小循环跑通之后,用于扩展工具生态的工程手段。
编辑观点
这篇教程的价值在于把“Agent”从一个模糊的流行词拆解为可操作的工程结构。大模型负责语言推理,Harness负责真实世界的执行,两者通过消息和工具调用协议连接。对于想深入AI应用开发的开发者来说,亲手实现一遍这个循环,比读十篇概念文章更有效。框架选型不必纠结,先写一两百行的最小循环,再进入一个框架扩展功能,是更务实的路径。
相关推荐
让Agent当导演:本地AI全流程制片工作站构想
B站UP主构想用英伟达RTX Spark搭建本地AI导演工作站,让Agent统筹剧本、分镜、视频生成、配音、自动剪辑与审片,实现AI全流程制片。本文分析其技术链路、可行性瓶颈与行业信号。
百万电梯维保背后:TK Elevator如何用AI盘活数十年知识
百万电梯维保背后:TK Elevator如何用AI盘活数十年知识
TK Elevator在科隆分享如何利用技术让维保技师快速获取数十年共享知识,减少搜索时间、提升电梯与扶梯维保效率。本文分析其知识复用逻辑及对AI落地现场服务的启示。
NVIDIA GTC柏林焦点:Microduck双足机器人如何革新强化学习
NVIDIA GTC柏林站上,Pollen Robotics的Microduck双足机器人成为焦点。这款专为强化学习设计的开发工具,以微型双足平台降低研究门槛,配套软件栈兼容主流RL框架,展现从仿真到实体的闭环潜力。