多模态大模型部署与微调实战:岗位技能与学习路径

B站公开课指出多模态大模型实战中部署门槛低,微调才是学习重心,并给出工程师三项能力框架。
本文基于B站一场公开课,分享多模态大模型部署与微调的实战经验。讲师陈伯拥有十多年算法经验,他指出部署借助现有推理工具门槛较低,微调才是需要投入精力的环节。微调的核心逻辑是准备数据集、训练模型并调整参数以强化特定能力。他将大模型工程师技能归纳为应用开发、训练微调、底层原理三方面,认为三者兼备即可胜任岗位。多模态微调属于训练微调范畴,对数据组织和任务设计要求更高。文章最后给出学习建议:先厘清技能地图,避免过度停留部署工具,微调需数据集与训练实践支撑,三条线并行推进是清晰成长路径。
多模态大模型正从实验室走向工程落地,部署与微调成为AI工程师的必备技能。B站一场公开课上,拥有十多年算法经验的讲师陈伯围绕“部署与微调实战”展开分享,重点落在微调环节——如何通过数据集训练多模态大模型,强化其在特定任务上的能力。
部署与微调:难度差异与学习重心
讲师在开场即点明一个关键判断:部署环节借助现有推理工具,门槛相对较低;真正需要投入精力的是微调。这一观点与工程实践中的普遍感受一致——推理框架的成熟度已经较高,而微调涉及数据准备、参数调整和效果评估,链条更长、变量更多。
微调的核心逻辑并不复杂:准备对应数据集,喂给大模型,训练并调整内部参数,从而提升模型在某一方面的能力。但“能跑通”和“调得好”之间差距明显,这也是实战教程的价值所在。
推理工具(Inference Toolkit)是指用于将训练好的大模型高效运行在生产环境中的软件框架,常见的有vLLM、TensorRT-LLM、TGI(Text Generation Inference)等。这些工具通过算子融合、KV Cache优化、连续批处理(continuous batching)、量化(如FP16/INT8/INT4)等技术,显著降低推理延迟和显存占用,并支持动态批处理和分布式部署。由于这些框架已高度封装,工程师只需按文档配置模型路径和服务参数即可完成部署,因此入门门槛较低。但需注意,部署环节仍涉及服务监控、并发调优和硬件选型等工程细节,只是相对于微调而言,其标准化程度更高、试错成本更低。
AI大模型工程师需要掌握什么
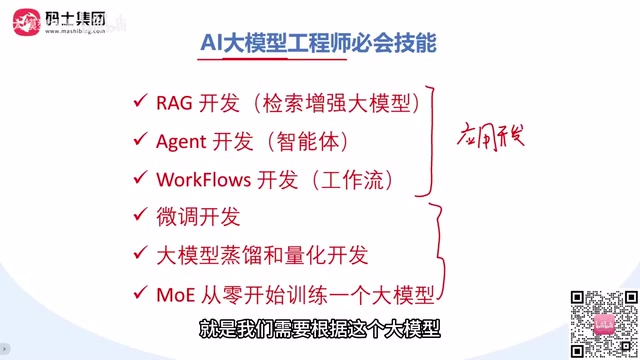
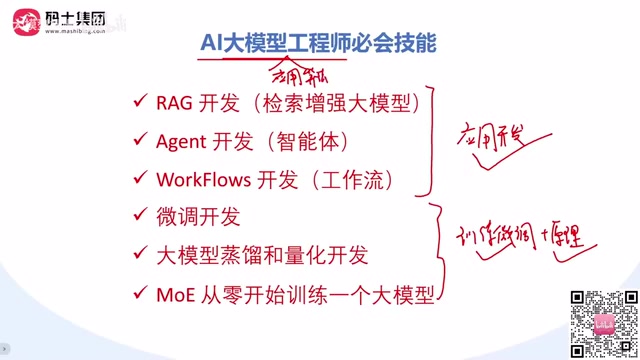
讲师陈伯拥有十多年算法从业经验,并为企业提供过内训服务,技术背景偏深度学习、机器学习与大模型算法。他将大模型相关岗位的技能要求归纳为三个方面:
- 应用开发:基于大模型构建应用,对应岗位如AI大模型应用工程师、大模型应用后端工程师。
- 训练微调:基于base model进行训练和微调,对应大模型应用算法工程师等方向。
- 底层原理:理解大模型的工作机制与核心知识。
他的判断是,同时具备应用开发、微调训练和原理认知三项能力,在当前环境下足以胜任大模型相关工程师岗位,也能满足企业实际干活的需求。这一归纳剔除了过度细分的技能焦虑,给出了相对务实的能力框架。
多模态微调在技能版图中的位置
本次课程主题“多模态大模型的微调”明确属于上述第二类——训练微调。与纯文本模型相比,多模态模型要处理图像、文本等多种输入,微调时对数据组织和任务设计的要求更高。讲师并未在公开课片段中展开具体技术细节,但从其对岗位能力的划分可以看出,多模态微调是应用算法工程师的核心竞争力之一。
多模态大模型(Multimodal Large Language Model, MLLM)指能够同时处理和理解多种模态数据(如文本、图像、音频、视频)的大规模预训练模型。其典型架构通常包含三个核心组件:模态编码器(如视觉Transformer,用于将图像转换为特征向量)、模态对齐模块(通过投影层或交叉注意力机制将不同模态特征映射到统一语义空间)以及大语言模型主干(负责最终的语义理解与生成)。与纯文本模型相比,多模态模型在微调时不仅需要调整语言模型参数,往往还需冻结或微调模态编码器,并精心设计模态对齐策略。常见微调方式包括全参数微调、LoRA(低秩适配)等参数高效方法,后者能在有限算力下实现较好的任务适配效果。
学习路径的启示
这场公开课传递出的信息对学习者有两点参考价值。其一,先厘清岗位技能地图,再选择学习重点,避免在部署工具上过度停留而忽视微调能力建设。其二,微调能力需要数据集准备与训练实践支撑,单纯看理论难以形成工程手感。对于希望进入大模型领域的开发者,应用开发、微调训练、原理认知三条线并行推进,是较为清晰的成长路径。
课程以“保姆级实战”为定位,强调部署与微调的结合,适合已有一定深度学习基础、希望系统补齐大模型工程能力的开发者关注。
相关推荐

腾讯WorkBuddy实测:AI Agent如何碾压传统聊天助手
腾讯WorkBuddy实测对比豆包:AI Agent如何直接操作电脑完成PPT转PDF、文件归档等任务。从安装门槛、国内生态、价格、插件市场四方面分析WorkBuddy优势,并给出AI Agent选择建议。

奥特曼称个人PC囤RAM“相当糟糕”,数据中心利用率更高
OpenAI CEO萨姆·奥特曼在Reddit引发热议的表态中称,个人PC配备大量RAM是“相当糟糕”的资源利用方式,数据中心凭借集中调度能实现更高内存利用率。本文解析这一观点背后的技术逻辑与行业信号。

付费5美元教AI说话:一场关于AI训练本质的社会实验
一位开发者搭建了运行真实语言模型的「假AI实验室」,用户支付5美元即可教模型一句话。这个社会实验揭示了AI训练中数据成本、用户参与和话语权的深层关系。