EduRAG智慧问答系统:黑马AI智能体项目实战解析
黑马程序员EduRAG项目拆解:RAG+FAQ双模块架构的企业级问答系统实战课程。
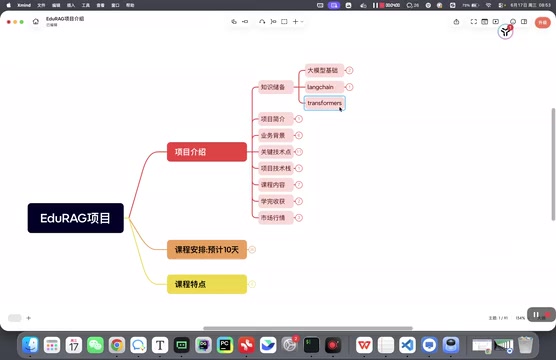
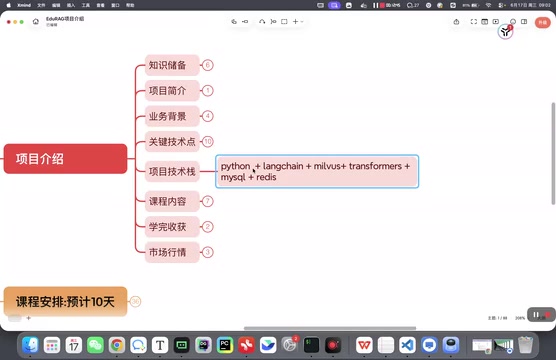
本文介绍了黑马程序员推出的EduRAG智慧问答系统课程,该项目面向IT领域,采用RAG+FAQ双模块架构解决事实性幻觉问题。核心技术栈包括LangChain框架、Milvus向量数据库、混合检索与重排序模型,并包含二分类模型微调用于过滤无关问题以优化Token消耗。课程原计划10天压缩为8天,覆盖背景工具、Milvus与LangChain、FAQ模块、RAG核心及Docker部署。讲师邢步指出,RAG已从去年的加分项变为今年的求职必会项,掌握Milvus、LangChain、混合检索与重排序是当前企业级RAG开发的核心能力。
在AI大模型落地应用中,RAG(检索增强生成)正从“加分项”变成“必选项”。黑马程序员推出的EduRAG智慧问答系统项目,正是面向这一趋势的智能体开发实战课程。根据B站官方课程视频,讲师邢步(现任AI大模型开发团队核心成员,曾任职滴滴、字节、好未来)详细拆解了该项目的架构、技术栈与学习路径。
项目定位:IT领域垂直问答,解决事实性幻觉
EduRAG是一个面向IT领域的智能问答系统,用户输入专业问题,系统基于内部知识库给出回答。据邢步介绍,该项目与网页版ChatGPT的核心区别在于:ChatGPT依赖网络搜索生成答案,而EduRAG的知识来源是预置的专业知识库,更适合企业级咨询场景。
在解决大模型幻觉的四种手段(提示词、RAG、微调、Agent)中,RAG主要针对事实性幻觉,而忠实性幻觉仍需依赖模型微调。这一分类为后续技术选型提供了理论依据。
事实性幻觉与忠实性幻觉的区别:事实性幻觉指模型生成了与客观事实不符的内容,例如将某个API的参数写错、编造不存在的库函数,这类问题可通过RAG引入外部权威知识库来纠正。忠实性幻觉则指模型的回答虽然看起来合理,但偏离了用户指令或输入上下文,例如用户要求“用三句话总结”,模型却输出了长篇大论,这类问题根源在于模型的指令遵循能力,需通过微调或RLHF来改善。理解这两类幻觉的成因差异,是选择RAG还是微调的关键判断依据。
RAG(Retrieval-Augmented Generation):检索增强生成,由Facebook AI Research于2020年提出。其核心思想是在大模型生成答案之前,先从外部知识库中检索相关文档片段,将其作为上下文一并送入模型,从而让模型的回答有据可依。RAG的优势在于知识可实时更新、无需重新训练模型、且能提供引用来源,因此成为企业级AI应用的主流方案。
双模块架构:RAG核心 + FAQ加速
项目分为两个模块。RAG模块是核心,包含检索、增强、生成三个标准过程。据B站视频和YouTube技术频道分析,这一架构是当前企业级RAG系统的主流实践。
FAQ模块则用于高频问题加速。邢步解释,在咨询场景中,类似“大模型学科费用”的问题会频繁出现,若每次都走完整RAG链路,成本过高。FAQ模块通过缓存高频问答对,显著降低响应延迟和Token消耗。这一设计在多源分析中被一致认为是工业级RAG的常见优化手段。
关键技术栈:LangChain、Milvus与重排序
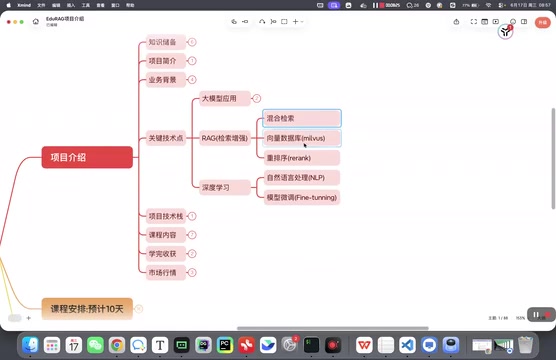
课程涵盖的核心技术点包括:
- LangChain:项目最核心的框架,贯穿RAG全流程。
- 混合检索:全文检索 + 语义检索结合,在Define阶段已有基础,此处改为代码实现。
- 向量数据库Milvus:国内使用最广泛的向量库,课程选择它作为教学重点。邢步提到,掌握Milvus后,Pinecone、Weaviate等同类数据库可快速迁移。
- 重排序:对混合检索结果进行二次精排。混合检索视为“粗排”,重排序模型则为“精排”,提升最终上下文相关性。
说个细节,模型Embedding不再依赖平台一键转换,而是通过Transformers框架加载原始模型文件,在本地算力上运行。
混合检索(Hybrid Search):单一检索方式各有局限——全文检索(如BM25)擅长精确关键词匹配,但对同义表达无能为力;语义检索(向量相似度)擅长理解语义,但可能遗漏包含关键术语的文档。混合检索将两者结果融合,通常配合RRF(Reciprocal Rank Fusion)等算法进行分数合并,能显著提升召回率。在企业知识库场景中,用户提问往往既有专业术语又有口语化表达,混合检索是兼顾两者的务实选择。
重排序(Reranking):混合检索返回的候选文档通常有几十条,其中真正相关的可能只有几条。重排序模型(如BGE-Reranker、Cohere Rerank)使用交叉编码器对“查询-文档”对逐一打分,精度远高于向量相似度,但计算成本也更高,因此只对粗排后的少量候选做精排。这种“粗排+精排”的两阶段架构是当前RAG系统的标准范式。
Milvus:一款开源的分布式向量数据库,支持十亿级向量检索,提供多种索引类型(如IVF、HNSW)以平衡速度与精度。它支持标量过滤与向量检索的混合查询,适合企业级知识库的复杂检索需求。
深度学习与模型微调:二分类过滤无关问题
虽然项目以RAG为主,但涉及一个关键的模型微调环节:对用户输入进行二分类,判断是专业问题还是无关问题(如“番茄炒蛋怎么做”)。只有专业问题才进入RAG系统,避免浪费Token。这一设计体现了工程化思维——不是所有查询都值得走昂贵链路。
据邢步说明,课程还包含RAG系统评估,使用类似F1-score的指标,但需要大模型参与判断,这与传统模型评估有所不同。
二分类过滤的工程意义:在大模型应用中,每次调用API都消耗Token并产生延迟。如果用户问的是“今天天气怎么样”这类与知识库无关的问题,走完整RAG链路不仅浪费资源,还可能因检索不到相关内容而生成低质量回答。通过微调一个小型分类模型(如BERT-base),在入口处快速判断问题是否属于专业领域,可以将无关查询拦截在RAG系统之外。这种做法在工业界被称为“查询路由”或“意图分类”,是控制成本和提升体验的常见手段。
RAG评估中的LLM-as-Judge:传统NLP评估依赖标准答案计算F1-score,但RAG的回答是自然语言,难以用精确匹配衡量。当前主流做法是让大模型充当评委,从忠实度(回答是否基于检索内容)、相关性(是否切题)、完整性等维度打分。这种方式虽然引入了评委模型本身的偏差,但在缺乏人工标注的情况下是性价比最高的评估方案。
课程结构与就业行情
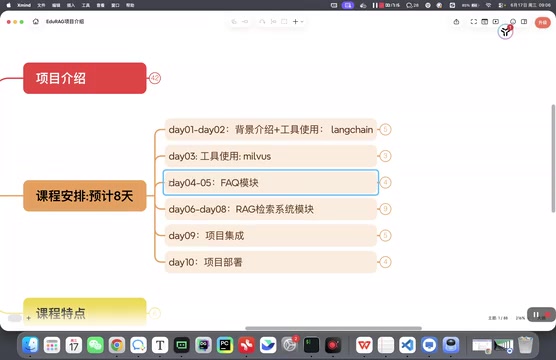
原计划10天的课程压缩为8天。第1-2天背景与工具,第3天Milvus与LangChain,第4-5天FAQ模块(压缩处理),第6-8天RAG核心,最后项目集成与Docker部署。后续还将衔接EDU Agent项目作为升级。
关于行情,邢步在视频中明确表示:去年RAG是加分项,今年已变成“必会项”,Agent同理。这两个项目被视为求职AI岗位最核心的实战经历。
学习建议与AI编程辅助
项目代码量大,课程以“运行+解释”为主,不逐行敲写。邢步建议学员重点理解流程与逻辑,并推荐使用Claude Code等AI编程工具辅助理解代码。他强调,有了AI工具后,进公司“干不了活”的顾虑基本可以打消,但需要时间适应同事的技术语言。
对于想深入RAG开发的工程师,掌握Milvus、LangChain、混合检索与重排序是当前企业级项目的核心能力。EduRAG提供了一个从理论到部署的完整实战路径。
相关推荐

恒星究竟能有多大?最大恒星的物理极限
红超巨星是宇宙中体积最大的恒星,半径可达太阳的2000倍,吞没内太阳系。但恒星尺寸没有精确上限,模型预测可达15000倍太阳半径。质量最大的蓝色恒星体积远小于红超巨星——最大和最重是两回事。

苹果HomeView智能屏全功能解析:墙挂桌面两用,299美元
苹果发布299美元智能显示屏HomeView,支持壁挂和桌面两种安装方式,配备1200万像素摄像头实现面部识别,可控制智能家居、播放音乐、发送食谱到屏幕逐步跟做。本文全面解析HomeView的表盘、应用扩展、隐私保护和烹饪集成等核心功能。

承诺的新工作室去哪了?Craft Computing用五年时间给出答案
Craft Computing主理人回应观众质疑:承诺五年的新工作室因建设成本从3万暴涨至7.5万美元而搁浅,最终改为168平方英尺车库改造空间。频道收入因算法变化下滑,内容方向也将转向更务实的项目制作。