Fable 5.2是最强模型吗?创作者实测对比与选型建议

创作者实测认为Fable 5.2最强但非主力,应按任务复杂度分层调度模型。
一位科技内容创作者在实测多款大模型后判断,Fable 5.2是他用过最强的模型,但并未找到充分证据证明Opus 55更弱,比较基于有限使用体验。他仍以Opus 55为日常主力,Sonnet处理前端等简单任务,Haiku用于极低成本场景,Fable 5.2专用于代码审查、架构判断和合同条款分析等高复杂度任务。他指出Fable 5.2单token价格更高,但因完成任务消耗token更少,基准测试显示整体成本效率反而更好。核心启示是:能力上限与使用频率是两件事,应按任务复杂度而非习惯切换模型,基准数据仅供参考,团队最好在真实任务上做对照测试。
Fable 5.2是最强模型吗?创作者实测对比与选型建议
一位科技内容创作者在实测多款大模型后给出了自己的判断:Fable 5.2是他目前用过最强的模型,但"最强"不等于"全都用它"。他仍然把 Opus 55 当作日常主力,只在特定场景切换到 Fable 5.2。这种看似矛盾的用法,恰恰揭示了当下模型选型的真实逻辑——不是找唯一最优解,而是按任务复杂度分层调度。
结论先行:最强模型,但不一定是主力
据该 YouTube 频道的分析,他明确表示"在我看来它就是目前最好的模型",也没有找到任何证据表明 Opus 55 更强。他承认自己对 Opus 55 的使用量不算多,不足以断言它总能更好地解决问题,但从整体感受看,Fable 5.2 显得更有能力(more competent)。
不过他同时强调,这并不构成"永远只用它"的理由。最强模型往往也是最贵的,真正理性的做法是把它放在最需要它的位置上。
成本效率的反直觉之处:贵,但更省
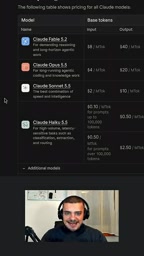
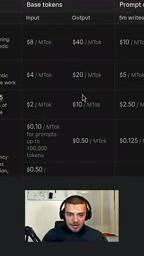
Fable 5.2 的单 token 价格更高,这一点创作者没有回避。但他指出,从基准测试(benchmarks)来看,它解决同一个任务消耗的 token 更少,因此总体上反而更具成本效率。
这带来一个值得注意的选型误区:按单价挑模型,往往会低估强模型的性价比。如果完成一项任务所需的交互轮次和 token 总量明显下降,单价高并不等于总成本高。当然,创作者也承认这一判断主要基于基准数据,实际业务中的差异还需要自行验证。
基准测试(benchmarks) 是模型能力评估的常用手段,通常由第三方机构或模型厂商设计标准化任务集(如代码生成、数学推理、阅读理解等),用统一指标(准确率、通过率、token消耗等)横向比较不同模型。常见基准包括 MMLU、HumanEval、SWE-bench 等。其局限在于:任务分布与真实业务场景往往存在偏差,模型可能对特定题型过拟合,且评测时的提示词、温度参数等设置会显著影响结果。因此创作者强调基准数据“仅供参考”,团队应在自己的任务上做对照测试,这一提醒是合理的。
他的实际分层用法:四款模型各司其职
创作者分享了自己日常的模型调度策略,这是整段分享中最具操作价值的部分:
- Opus 55:依然是主要驱动模型,承担日常大部分工作
- Sonnet:处理相对简单的任务,比如前端相关的工作
- Haiku:需要极低成本、追求性价比时使用
- Fable 5.2:用于代码审查、架构判断、合同条款分析等需要大局观和高复杂度的场景
这种分层思路的核心是把"贵模型"留给"想不清楚就会出大问题"的任务,而把常规执行交给更经济的模型。
模型分层调度(model routing / cascade) 是一种成本优化策略:将请求按难度分级,简单任务交给轻量廉价模型,复杂或高风险任务升级到旗舰模型。实现方式可以是人工规则(如按任务类型预设),也可以由路由器模型自动判断。其理论依据是任务难度分布通常呈长尾——大部分请求并不需要最强模型。分层调度能在质量损失可控的前提下显著降低平均成本,但也带来路由误判风险:简单任务被误升级会浪费成本,复杂任务被误降级则可能引发质量问题。创作者的四模型分工正是一种人工版分层调度。
最适合 Fable 5.2 的三类任务
创作者具体列了几类他会主动咨询 Fable 5.2 的场景:
代码审查与安全检查。 当你需要有人告诉你"这段代码安不安全、有没有明显问题"时,Fable 5.2 是合适的对象。他也坦率提到,让模型做漏洞挖掘可能效果不佳,但做整体审查是可以的。
架构合理性判断。 他会直接问:从架构上看这合理吗?有没有明显的设计缺陷?这类问题需要的不是局部修补能力,而是对整体结构的把握。
合同与条款阅读。 在阅读合同、判断某些条款该如何取舍时,他也会交给 Fable 5.2。这属于典型的"高复杂度、需要通盘理解"的任务。
用他的话说,Fable 5.2 更像是一位"你在大局层面或极高复杂度问题上可以去咨询的架构师"。
代码审查(code review) 与漏洞挖掘(vulnerability discovery) 对模型能力的要求存在本质差异。代码审查侧重整体可读性、逻辑一致性、潜在缺陷和安全隐患的模式识别,模型只需理解上下文并给出判断,属于“理解+评估”任务。漏洞挖掘则要求模型主动构造攻击路径、发现深层次边界条件,往往需要精确的代码执行推理和对抗性思维,当前模型在这方面的可靠性仍有限。创作者指出 Fable 5.2 适合前者而不擅长后者,与业界普遍观察一致:大模型在静态审查中表现较好,在系统性漏洞发现上仍有明显短板。
对开发者的启示
这段分享的价值不在于给出一个"谁最强"的排名,而在于示范了一种可迁移的选型方法:
其一,能力上限与使用频率是两件事。最强模型通常最贵,把它设为默认主力未必经济,但在关键决策点上它的价值会被放大。
其二,按任务复杂度而非按习惯切换模型。前端、简单脚本交给轻量模型,架构评审和合同分析再调用旗舰模型,这种调度能同时控制质量与成本。
其三,基准数据只能作为参考。创作者本人也承认,他对 Opus 55 的使用还不够充分,无法做出绝对化的比较结论。对团队而言,最可靠的做法仍然是在自己的真实任务上跑一轮对照测试。
需要说明的是,以上判断全部来自单一创作者的主观体验与公开基准,并非严谨的横向评测。Fable 5.2 是否真的"最强",在不同任务类型上可能有不同答案。
相关推荐
《谢谢你的爱》英文版走红B站:经典情歌的跨文化演绎
B站热传的《谢谢你的爱》英文版《I'll give you all my love》,通过重新填词诠释“给予全部的爱”的主题。本文分析其歌词情感表达、跨文化改编策略以及与中文原版的情感逻辑差异,探讨经典华语歌曲英文改编的传播价值。
Claude Code vs Cursor vs GitHub Copilot:三大AI编程工具怎么选
用「放权程度」一个维度讲清 Claude Code、Cursor 与 GitHub Copilot 的区别:Copilot 嵌入现有编辑器做补全,Cursor 是以AI为核心的完整编辑器并支持多文件批量修改,Claude Code 在终端里端到端执行任务。附选择建议。
动态漫解说爆款背后:家庭财务与情感冲突的叙事拆解
从B站动态漫《CC-动态漫》的一集家庭财务冲突剧情出发,拆解动态漫如何用高密度对话和情绪钩子抓住观众,并分析AI辅助脚本生成在叙事连贯性上的短板与人工把关的价值。