复刻Shopify AI编程工作流:300屏App全自动重建的门控机制

Shopify用AI Agent重建300屏App的结构化工作流解析:检查点拆任务,四道门控保质量。
Shopify用内部工具Helix指挥AI编程Agent完成了旗下主力App全部300块屏幕的重建,核心设计是两个支柱:检查点(把大功能切成复杂度递增的小任务)和门控(每个检查点必须通过才能推进)。海外团队AI Labs根据公开描述逆向复刻了这套工作流,并在演示项目上验证跑通。工作流由一个orchestrator技能统一调度,全程只需两次人工介入;子Agent为每项任务保留独立上下文窗口,避免长任务中信息丢失。四道门控依次为:行为门控(代码测试功能逻辑)、UI门控(双Agent并行比对视觉与交互)、对抗性审查门控(批评Agent与修复Agent循环博弈直至代码过关)、人工审查(真实用户视角的最终验收)。这套方法的价值不限于App迁移,而是一套在保证质量前提下让AI承担大规模工程任务的通用框架。
Shopify最近重写了他们的主力移动App,这可不是小工程——整整300块屏幕,而且全部交给AI编程Agent来完成。但他们并没有把整个任务一股脑扔给一个Agent,而是设计了一套贯穿始终的结构化工作流,确保重建后的App依然达到内部标准。
问题在于,Shopify只公开谈论了方法论,却从未展示具体实现。海外软件团队AI Labs顺着官方描述的思路逆向推演,搭建出了同样的一套工作流,并在自己的项目上跑通验证。本文梳理这套流程的核心机制,也解释为什么它的价值远超"迁移App"这一个场景。
为什么这套工作流值得关注
Shopify把驱动这套循环的内部工具叫做Helix。它诞生的背景是:团队要用一种与原始架构完全不同的方式重写App。做法是取出旧App的一块屏幕,让Agent把它转换成新版本。Helix读取这块屏幕后,会把工作拆分成更小的任务单元,称为"检查点"(checkpoints)。
关键在于两个设计支柱:检查点和门控(gates)。检查点是被切碎的小块工作,门控则是每块工作必须通过的强制检查。任何没通过检查的工作,都会被卡住,无法进入下一个任务。这套机制让Agent"无法靠嘴皮子蒙混过关"——Shopify自己的说法是:"一次尝试可以是错的,但在它变对之前,不允许上线。"
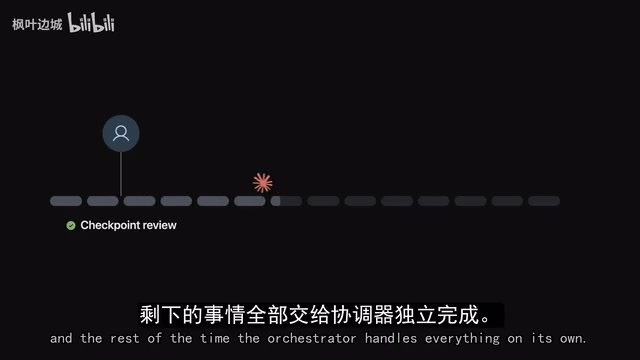
AI Labs团队指出,虽然Shopify用它做的是App形态迁移,但这套流程的适用范围要广得多。它本质上是一套"在保证质量和视觉标准前提下构建大型功能"的通用方法。由于Helix仍是内部工具、外界无法访问,他们基于公开设定复刻了自己的版本,并在一个演示用的HR系统项目上做了测试。
子Agent与新鲜上下文窗口
Helix的执行全部交由子Agent(sub-agents)完成,核心原因是上下文窗口的隔离。当一个Agent处理超长任务、把所有信息都塞进同一个上下文窗口时,问题就来了:信息量太大,Agent会在中途遗忘重要内容,工作质量随之下滑。
子Agent为每个任务保留独立的上下文窗口,从根本上规避了这个问题。这也是整套复刻方案里反复出现的设计原则——每个环节尽量用一个新鲜、干净的会话来执行。
AI Labs团队为了减少人工介入,创建了一个叫做"orchestrator"(编排器)的技能。它是唯一需要你主动提示的技能,其余部分全由它自己调度。整个流程中,你的输入只需要两次,其他时候编排器全程自动运行。
上下文窗口(context window)是大语言模型在单次会话中能"看到"的全部文本量,通常以token数衡量。当任务越来越长,早期输入的信息会在模型的注意力中被稀释,出现所谓的"中间丢失"(lost-in-the-middle)现象——即模型对靠近上下文首尾的内容记忆较好,对中间内容的处理质量明显下降。这在处理数百个屏幕、数万行代码的工程级任务时尤为致命。将工作分配给多个子Agent,每个子Agent各自持有一个干净、聚焦的上下文,相当于给每项子任务配备了一个"刚上班、头脑清醒"的工人,而非让同一个工人疲惫地处理所有事情。这也解释了为什么即使Claude或Gemini等模型的上下文窗口已扩展到数十万token,业界在复杂工程任务中仍倾向于多Agent架构而非单Agent超长会话。
检查点:从简单到复杂逐级构建
检查点是大功能的小切片。Shopify的规则是:前一个检查点没有正确完成,下一个就不能开始。而且他们按复杂度递增的顺序排列检查点——最小的任务先建,再逐步推进到更复杂的部分。
这么做的逻辑很清晰:每个检查点都建立在前一个之上,如果早期的某个决策出错,你能在它还小、修复成本还低的时候就抓住它。
AI Labs为此创建了"Checkpoint Planner"Agent,把交给编排器的大功能拆分成检查点,并写入JSON文件——结构化格式便于Agent理解和检索。但JSON对人类并不友好,一整块结构化文本很难直接读懂,于是他们额外做了一个网页查看器,把每个步骤、进度状态和完成标准都直观展示出来。
在这个阶段,编排器还会派另一个子Agent负责规划测试,提前把每个检查点的测试方式详细记录下来。这一步的人工审查必须做扎实,确保计划没有遗漏功能,否则后续Agent的实现时间就白费了。审查通过后,编排器从检查点1开始正式构建。
四道门控:让Agent无路可逃
让检查点"算作完成"的,是Shopify所说的门控。这里有个重要区别:门控不是规则。规则只是建议,Agent工作时会忘记,你得反复提醒;而门控不同,不通过就绝不放行到下一个任务。
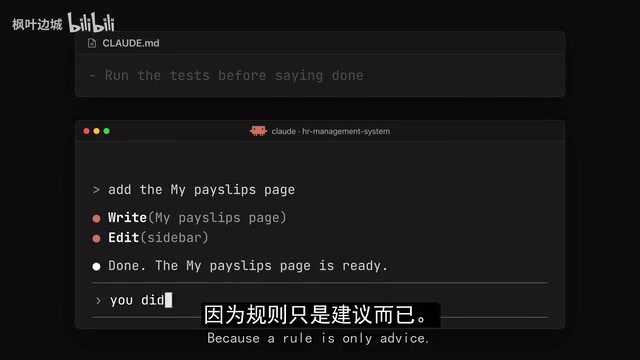
AI Labs为此创建了一个hook(钩子),每当Agent试图停止时触发,抛出退出码2。这个退出码并非表示出错,而是提示Agent继续工作,直到所有门控通过。团队坦言这个概念借鉴自"Ralph loop"。Shopify的工作流一共有四道门控:
行为门控:不开浏览器也能验证
第一道是行为门控,检查功能是否真的能用。它涵盖所有无需浏览器就能完成的测试——Agent不去点击App,而是写小段代码,像真实用户那样使用功能。这些代码就是测试,且要覆盖尽可能多的输入场景。
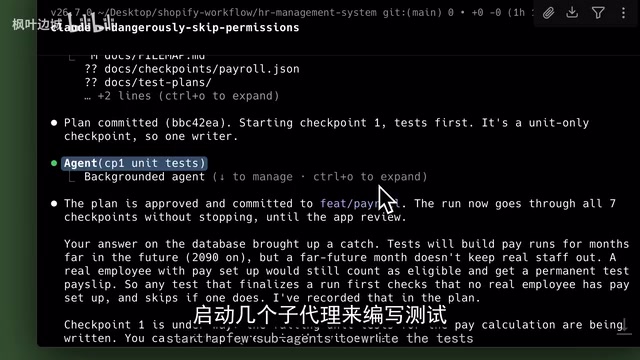
比如"经理是否有权批准某人的休假",这类逻辑用代码直接验证即可,根本不需要按按钮。AI Labs改造了此前的TDD Planner技能来适配这套流程:编排器先启动子Agent写测试(此时因功能还没写,测试全部失败),再启动子Agent写代码,最后再用一个子Agent跑测试。全部通过,门控1才对该检查点标记为通过。
UI门控:视觉与交互的双重比对
第二道UI门控直接关系用户体验。Shopify因为是把一个App转成另一种形态,保持设计完全一致极其重要。他们选用Gemini模型作为"完美主义设计审查员"——测试发现这类模型的空间感知能力很强,能察觉两块屏幕间细微的间距和尺寸差异。
但当你做自己的项目或给客户交付时,往往没有可对照的现成设计。AI Labs的做法是先用"prototype"技能创建HTML原型,把整个原型做成一个可点击的单文件,遵循项目自己的design.md设计规范。之后再用一个专门技能,把构建好的App与原型逐一比对——不仅比视觉,还比交互行为,并且会先确保原型和App处于相同状态(比如表单"未提交"与"已提交"是两种状态)。
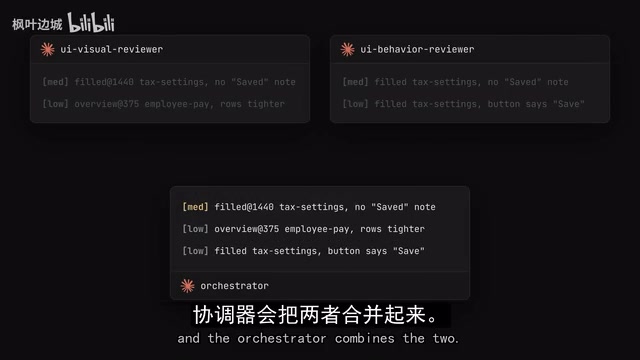
有意思的是,这里他们没沿用Gemini,而是把比对交给一个全新会话中的Claude。当编排器遇到需要UI门控的检查点时,会并行启动两个Claude子Agent:一个审视外观,一个审视行为,两者都看不到项目指令,只依据原型和design.md来评判。最后编排器合并两份评审,决定门控是否通过。
对抗性审查门控:让代码互相挑刺
第三道是对抗性审查门控。功能能用、外观也对,但底层代码仍可能一团糟。Shopify用了两个对抗性Agent对照团队写下的标准审查代码,每个问题都必须修复,两个Agent都通过才算过关。
AI Labs做了一点改进:不是让两个Agent都批评代码,而是设置成一个"对抗循环"——一个Agent负责批评(假设代码是错的、拼命找问题),另一个Agent负责修复。由"adversarial loop"技能协调两者通信。对抗Agent找出问题,修复Agent修改,然后再审查,如此往复,直到对抗Agent认可代码,门控才算通过。
对抗性评审(adversarial review)的思路借鉴自软件工程中的"红队测试"(red teaming)和学术界的同行评审制度。红队测试原指安全领域由专门团队模拟攻击者视角寻找系统漏洞,后来被AI安全研究广泛采用,用于发现模型的潜在缺陷或有害输出。将其引入代码审查,意味着审查Agent的任务设定与开发Agent完全对立——它的"目标"就是找问题,而非找理由认可代码。这种角色分离能有效对抗AI的一个常见倾向:当同一个模型既写代码又审查代码时,它往往会对自己的输出过度宽容。让批评者和修复者分别由独立会话中的不同Agent扮演,并强制循环直到批评者"无话可说",是在流程层面解决这一偏差的工程手段。
人在回路:机器替代不了的最后一关
第四道也是最后一道,是人的审查。即便Agent有标准、有对照,它们终究无法从真实用户视角评判。所有检查点完成后,你需要亲自测试功能,判断哪里能做得更好,再提出小修改。
当你提出反馈时,编排器会把它们转化成新的检查点,同样走完整套流程。第一步是把反馈写进一个"learnings"文件,每个Agent开工前都会先读它。
门控机制在软件工程中有对应的成熟概念——"质量门"(quality gate),常见于CI/CD(持续集成/持续交付)流水线中。传统CI/CD里,代码提交后会自动触发编译、单元测试、静态分析等一系列检查,任意一关不过,代码就无法合并进主分支。Shopify的门控体系本质上是把这套思路移植到AI Agent工作流:把原本由人工或自动化脚本执行的质量检查,转化为Agent执行前必须通过的强制卡点。退出码2(exit code 2)的设计也源于Unix/Linux系统惯例——进程退出时返回的数字向调用方传递状态信息,0通常代表成功,非0代表异常,Helix复刻版借用这套信号机制让编排器"知道"某个子Agent还没有完成任务,需要继续执行。
一次提示,两次停顿
整套流程由前面提到的orchestrator技能统一驱动。你只需提示它一次,它就会从拆分检查点一路跑到把最终功能交给你审查。编排器全程只为你停两次:一次是检查点规划完成后等你批准,另一次是全部完工后等你验收。
Agent在过程中难免出错,但门控永远不会放行未完成的工作。这正是Shopify那句话的落地方式——尝试可以错,但不修对就不许上线。
对于开发者来说,这套逆向复刻最大的启示或许不在于具体工具,而在于"结构化约束"这个思路:与其寄望单个强大Agent一次到位,不如用检查点切碎任务、用门控设立不可绕过的质量关卡,再用子Agent保持上下文清爽。这三者组合,才让AI真正能扛下300屏这种量级的工程。
相关推荐

腾讯WorkBuddy实测:AI Agent如何碾压传统聊天助手
腾讯WorkBuddy实测对比豆包:AI Agent如何直接操作电脑完成PPT转PDF、文件归档等任务。从安装门槛、国内生态、价格、插件市场四方面分析WorkBuddy优势,并给出AI Agent选择建议。

奥特曼称个人PC囤RAM“相当糟糕”,数据中心利用率更高
OpenAI CEO萨姆·奥特曼在Reddit引发热议的表态中称,个人PC配备大量RAM是“相当糟糕”的资源利用方式,数据中心凭借集中调度能实现更高内存利用率。本文解析这一观点背后的技术逻辑与行业信号。

付费5美元教AI说话:一场关于AI训练本质的社会实验
一位开发者搭建了运行真实语言模型的「假AI实验室」,用户支付5美元即可教模型一句话。这个社会实验揭示了AI训练中数据成本、用户参与和话语权的深层关系。