Funke 发布:在 Databricks 上原生解析 HL7v2 医疗数据

Funke为Databricks带来HL7v2原生解析能力,填平医疗消息标准与湖仓架构之间的集成鸿沟。
HL7v2是医疗信息系统间数据交换的核心标准,但其分隔符驱动的半结构化格式与现代湖仓架构天然不兼容,历来需要借助集成引擎或自建解析器完成格式转换,过程繁琐且容易丢失语义。Funke针对这一痛点,在Databricks平台上提供HL7v2的原生解析能力,让医疗消息可以直接在湖仓环境中被结构化处理,免去外部ETL中间层。这一方案降低了医疗数据团队的集成门槛与管道维护成本,也为临床数据与计费、运营等数据的联合分析奠定基础。目前关于其具体覆盖度与性能的细节仍待官方进一步披露。
医疗数据的隐形难题:HL7v2 与湖仓架构的鸿沟
HL7v2 是支撑现代医疗信息系统运转的消息标准,它安静地流淌在医院、实验室、保险机构的系统之间,承载着患者入院、化验结果、医嘱等关键数据。然而,这套诞生于早期医疗 IT 时代的格式,与今天流行的数据湖仓(Lakehouse)架构之间存在着明显的鸿沟。
HL7v2 使用分隔符分段的文本结构,字段嵌套、重复、可选项繁多,解析规则复杂且各机构实现差异大。当医疗机构希望把这些消息导入 Databricks 等现代分析平台时,往往需要先经过一层繁琐的 ETL 转换,才能把半结构化的消息转为可查询的表格数据。这一环节不仅拖慢数据流转,也容易在转换中丢失语义信息。
HL7v2(Health Level Seven Version 2)自1987年发布以来已迭代至2.x系列,是目前全球医疗机构间数据交换最广泛使用的标准,覆盖ADT(入院/转院/出院)、ORM(医嘱)、ORU(检验结果回报)等数十种消息类型。其核心结构由"段(Segment)"构成,每段以三字母代码开头(如MSH、PID、OBX),字段间用竖线|分隔,子字段用^分隔,重复字段用~分隔。这种设计在低带宽年代非常高效,但也带来了解析上的典型挑战:字段是否出现、出现几次、含义是否与标准定义一致,往往因发送方系统不同而差异显著。例如同样是OBX检验结果段,不同医院系统对数值单位、参考范围的填写方式可能完全不同,导致"同名字段、异义内容"的情况在跨机构数据汇聚时极为常见,这也是通用解析器难以做到开箱即用的根本原因。
Funke 的解法:原生解析,减少中间环节
据原文介绍,Funke 的目标是在 Databricks 平台上提供对 HL7v2 的原生解析能力。换句话说,它让 HL7v2 消息可以直接在湖仓环境中被识别、拆解并结构化,而不必依赖外部的预处理工具链。
这种原生化的意义在于把解析逻辑下沉到数据平台本身。对于每天要处理海量医疗消息的机构来说,减少数据搬运与格式转换的中间层,意味着更低的延迟、更少的管道维护成本,以及更接近原始语义的分析结果。数据工程师不再需要为 HL7v2 单独维护一套解析服务,而是可以在熟悉的 Databricks 工作流中直接消费这些数据。
为什么这件事值得医疗数据团队关注
医疗行业的数据分析长期受制于格式碎片化。HL7v2 虽然普及,但它并非为大规模分析而设计。把它顺畅地接入湖仓,就能让临床数据与其他数据源(如计费、运营、设备遥测)在统一平台上做联合分析,为临床决策支持、运营优化和合规审计提供基础。
原生解析方案降低了技术门槛。过去需要专门的集成引擎(interface engine)或自建解析器才能完成的工作,如今有望通过平台原生能力实现,这对资源有限的医疗 IT 团队尤其有价值。
传统上,医疗机构处理HL7v2与下游分析系统之间的衔接,通常依赖专门的集成引擎(Interface Engine),如Mirth Connect、Rhapsody、InterSystems HealthShare等。这类工具充当消息路由与转换的中间件,能够接收HL7消息流、按规则重映射字段、再输出为目标格式。然而维护集成引擎本身需要专属的技术栈知识,且数据在到达分析平台之前已经历至少一次有损转换——部分嵌套结构或扩展字段在映射过程中被丢弃。将解析能力原生化到Databricks,意味着分析工程师可以直接访问消息的完整层级结构,用SQL或PySpark表达过去只能在集成引擎中用私有脚本完成的逻辑,同时减少一个需要单独运维和监控的系统节点。
小结与观察
从公开信息看,Funke 代表了一种趋势:数据平台正在把越来越多的行业专用格式解析能力内化为原生功能,而不是让用户在边缘用脚本缝合。对于医疗数据工程而言,HL7v2 的原生支持若能稳定落地,将显著简化数据接入链路。
需要说明的是,当前可获取的素材较为有限,关于 Funke 的具体解析覆盖度、性能表现、对 HL7v2 各版本的兼容性等关键细节仍有待官方进一步披露。建议有相关需求的团队持续关注其技术文档与实际基准测试结果,再评估是否纳入生产环境。
相关推荐
Agent Skills全解析:渐进式披露架构与MCP对比
深入解析Agent Skills架构:什么是渐进式披露、Skills如何让Agent获得模块化扩展能力、与MCP和Function Calling及Multi-Agent的区别,以及自定义Skills开发的学习路径。

AI短剧剪辑提速10倍:豆包+剪映自动剪辑实战
B站UP主张Mark分享AI短剧后期剪辑实战:用豆包工作安装剪映editor技能,将爆款剪辑逻辑写成指令交给AI自动完成素材拼接、节奏裁切、配乐字幕,一分钟成片从半天缩短到十几分钟,附手动精修要点。
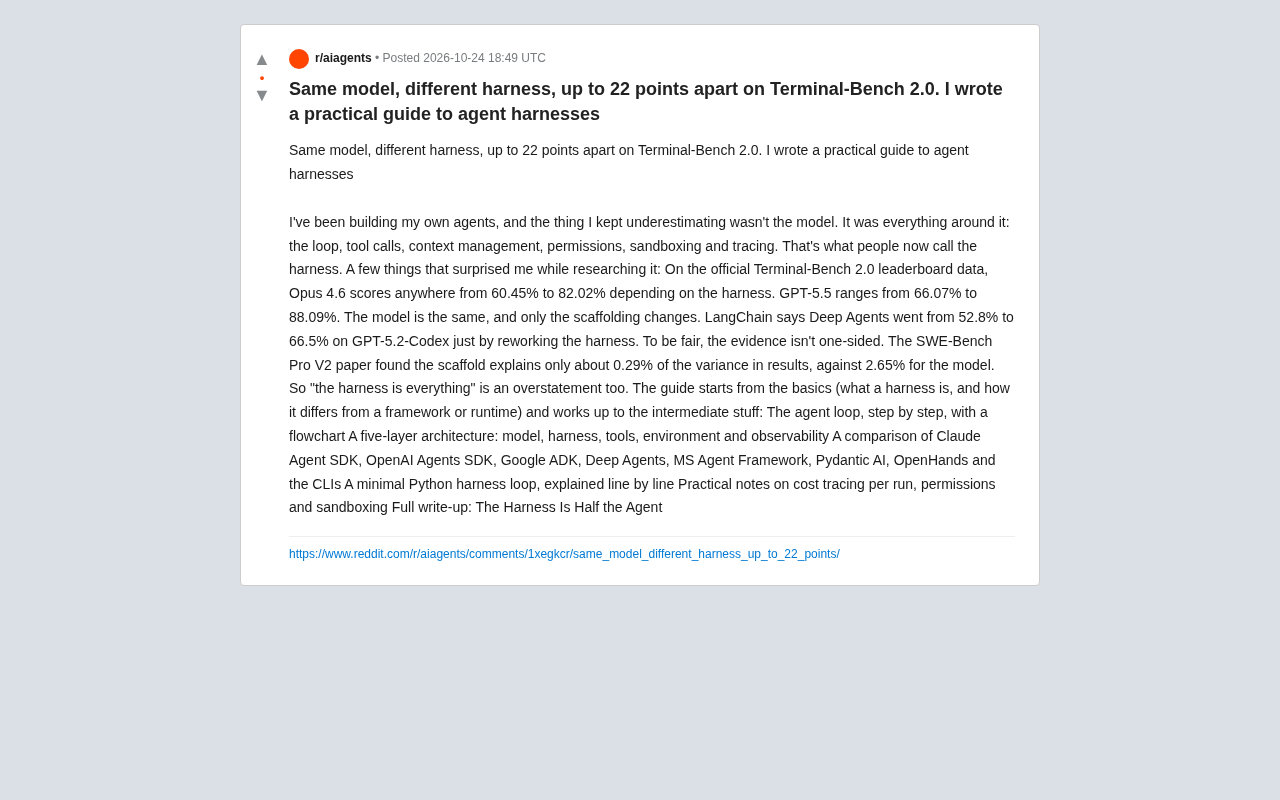
同一模型跑分差22分:Agent Harness才是关键变量
同一模型在不同 harness 下 Terminal-Bench 2.0 得分相差 22 分:Opus 4.6 从 60.45% 到 82.02%,GPT-5.5 从 66.07% 到 88.09%。本文解读 agent harness 的五层架构、主流 SDK 对比、最小 Python 循环实现,以及成本追踪、权限与沙箱等工程要点。