告别回放缓存:TA-KAN如何破解持续学习中的OOD检测难题
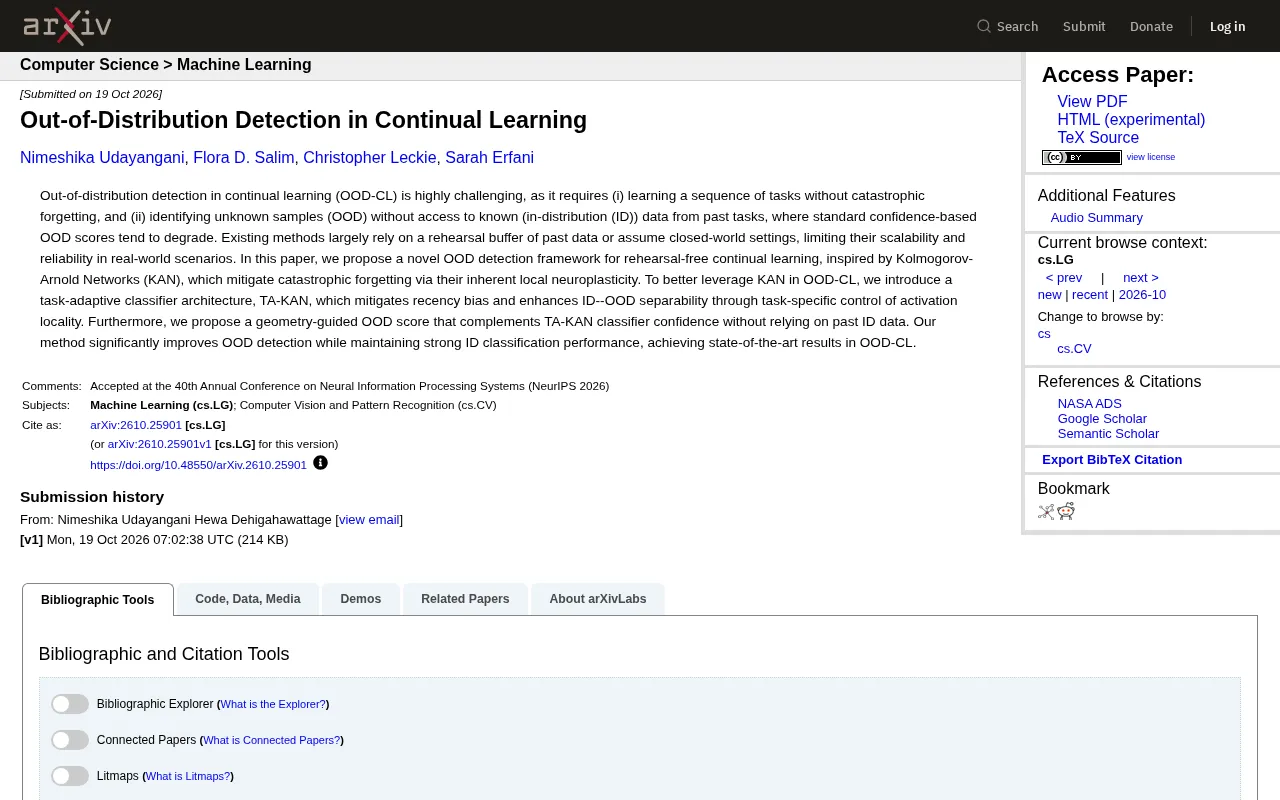
TA-KAN 用 KAN 骨干与任务自适应分类器,在无回放持续学习中兼顾抗遗忘与 OOD 检测。
文章介绍了一篇针对持续学习中分布外检测(OOD)短板的论文,提出 TA-KAN 框架。文章先指出 OOD 检测在持续学习场景下格外困难:模型按任务序列训练且旧数据不再保留,标准置信度会因新近偏好而系统性偏移,论文将其归纳为避免灾难性遗忘与无历史 ID 数据两条约束。随后介绍 TA-KAN 的两个关键设计:利用 KAN 的局部神经可塑性减轻遗忘,以及通过任务自适应分类器控制激活局部性来抑制新近偏好;并辅以不依赖历史 ID 数据的几何引导 OOD 分数。结果显示其在 OOD-CL 基准上达到 state-of-the-art,同时保持 ID 分类性能,但摘要层面未披露具体数据集与对比细节。
持续学习(Continual Learning)让模型像人一样按顺序学习新任务而不遗忘旧知识,但一个被长期忽视的短板是:当模型面对从未见过的输入时,它还能可靠地说出"我不认识"吗?这正是分布外检测(Out-of-Distribution Detection, OOD)要解决的问题。近期一篇论文提出了名为 TA-KAN 的框架,试图在无回放缓存的持续学习场景下同时做好两件事——不遗忘旧任务,且准确识别未知样本。
为什么 OOD 检测在持续学习中格外困难
在静态训练场景里,OOD 检测已有相对成熟的方案:模型对输入给出置信度,置信度低就判为未知。但持续学习把这个前提打破了。模型按任务序列依次训练,过去任务的训练数据通常不再保留,标准置信度分数会随任务推进而系统性偏移——模型对近期任务的输入过度自信,对旧任务和真正未知的输入反而给出混乱的置信度。
论文将这一问题的核心归纳为两个约束:(i) 在不发生灾难性遗忘的前提下学习任务序列;(ii) 在没有过去任务 ID 数据可访问的情况下识别 OOD 样本。现有方法大多依赖回放缓存(rehearsal buffer)保存旧数据,或者假设封闭世界设定,这在实际部署中既受存储与隐私限制,也难以随任务数量扩展。
灾难性遗忘(Catastrophic Forgetting)指神经网络在学习新任务时,参数更新会大幅覆盖旧任务所依赖的权重,导致旧任务性能急剧下降。这在按任务序列训练的持续学习设定中尤为突出:模型没有机会同时看到全部数据,梯度方向只服务当前任务。学界应对思路大致分三类——正则化方法(如 EWC 约束重要参数漂移)、回放方法(保存或生成旧样本混入训练)、以及架构方法(为任务分配独立子网络或隔离参数)。TA-KAN 所走的 KAN 骨干属于第三类的变体,通过结构上的局部性减少新旧任务间的参数干扰。
新近偏好(Recency Bias)是持续学习中的另一典型现象:由于模型在训练末期反复接触最新任务的数据,其决策边界和输出置信度会向近期任务倾斜。表现在 OOD 检测上,就是模型对当前任务分布的输入给出异常高的置信度,而对旧任务样本或真正未知样本的置信度分布发生重叠,使基于阈值的判别失效。这种偏移是系统性的、随任务序列累积的,无法靠简单的温度缩放或后处理校正,因此需要在分类器结构层面加以控制。
TA-KAN 的两个关键设计
用 KAN 的局部可塑性对抗遗忘
论文的灵感来自 Kolmogorov-Arnold Networks(KAN)。与传统 MLP 在节点上放固定激活函数不同,KAN 把可学习的函数放在边上,这种结构天然具有局部神经可塑性(local neuroplasticity)——学习新任务时对已有参数的扰动更局部化,从而缓解灾难性遗忘。作者认为这使 KAN 成为无回放持续学习的合适骨干。
Kolmogorov-Arnold Networks(KAN) 是 2024 年提出的一种神经网络架构,其理论基础是柯尔莫哥洛夫-阿诺德表示定理:多元连续函数可表示为有限个一元连续函数与加法的复合。与 MLP 把固定非线性激活函数放在节点、权重放在边上不同,KAN 把可学习的样条函数(通常是 B 样条)放在边上,节点只做求和。这一设计带来两个特性:一是参数效率较高,表达同样函数所需参数往往更少;二是函数的可解释性和局部性更强,因为每条边上的样条只在其定义域局部生效。正是这种局部性,使 KAN 在学习新任务时对既有函数的改动更集中,不易波及与旧任务相关的参数区域,从而为无回放持续学习提供了结构基础。
任务自适应分类器:把"新近偏好"压下去
仅有 KAN 还不够。论文指出持续学习模型普遍存在 recency bias(新近偏好),即对最后学到的任务过度自信,这会直接污染 OOD 分数。为此作者设计了任务自适应分类器 TA-KAN,通过按任务控制激活局部性(activation locality),增强 ID 与 OOD 样本的可分性。
几何引导的 OOD 分数
在分类器置信度之外,论文还提出一个几何引导(geometry-guided)的 OOD 评分,作为对 TA-KAN 置信度的补充。关键在于,这个分数不依赖任何过去的 ID 数据,因此与无回放设定兼容。
结果与意义
论文报告该方法在显著提升 OOD 检测性能的同时,保持了较强的 ID 分类表现,并在 OOD-CL 基准上取得 state-of-the-art 结果。相比依赖回放缓存的路线,这条思路的价值在于把"可扩展性"写进了方法本身:任务越多,回放缓存方案的存储与隐私负担越重,而无回放框架不受此约束。
需要客观看待的是,摘要层面并未披露具体的基准数据集、任务序列长度和对比方法清单,KAN 类骨干在更大规模任务序列上的稳定性也仍需更多实验验证。对关注持续学习落地的团队而言,这项工作的启发性在于:OOD 检测不应是训练完成后的附加模块,而应与持续学习的架构选择一起设计。
常见问题
TA-KAN 需要保存旧任务数据吗? 不需要。方法明确面向无回放(rehearsal-free)设定,OOD 分数也不依赖过去的 ID 数据。
为什么不用普通置信度做 OOD 检测? 在持续学习中,置信度会受新近偏好影响而系统性偏移,对旧任务和未知样本的判断都不可靠。
KAN 在这里起什么作用? 其局部神经可塑性使新任务学习对旧参数的干扰更局部,从而减轻灾难性遗忘。
相关推荐

Agentic Paper Bomb:用多智能体自动生成企业合规文档
Reddit 开发者分享 Agentic Paper Bomb 实验:让五个 AI 智能体扮演高管角色,自动生成企业合规、安全、DevOps 等文档。探讨多智能体协作生成文档的潜力与隐忧。

《Rob Roy》经典台词解析:领导者的代价与生存抉择
解析《Rob Roy》中Rob Roy与Sibbald的经典对峙台词,探讨领导力的代价、生存与尊严的权衡,以及权力博弈背后的人性洞察。

黄仁勋被曝聘请擅长处理丑闻的公关公司
据 Wired 报道,黄仁勋在《纽约时报》报道其妻子商业往来后,聘请了一家曾处理高知名度性丑闻的公关公司。本文分析这一举动背后的危机管理信号及其对英伟达声誉的影响。