告别算力军备竞赛:一份技术白皮书的思考

白皮书讨论质疑算力堆叠的线性路径,主张转向算法效率与架构创新。
文章围绕一篇来自Reddit的技术白皮书讨论展开,核心命题是AI行业是否陷入了低效的算力军备竞赛。白皮书指出,当前主流路径依赖大规模算力堆叠来提升模型能力,但这一线性思维忽略了算法效率、架构创新与数据质量等变量,导致边际收益递减而成本、能耗与工程复杂度持续攀升。文章梳理了从规模驱动转向效率驱动的可能方向,包括更高效的训练算法、更合理的架构选择以及推理成本控制,并指出这一视角对资源有限的中小团队和开源社区更具现实意义。由于原始素材仅提供标题与讨论性质,文章定位为框架性梳理,提醒行业警惕路径依赖,保持对替代技术路线的开放态度。
告别算力军备竞赛:一份技术白皮书的思考
在AI行业,"更大的模型、更多的GPU、更高的算力"几乎成了默认的成功公式。但这篇来自Reddit的技术白皮书讨论提出了一个反向命题:我们是否正在陷入一场低效的算力军备竞赛?
算力竞赛的隐忧
当前主流路径依赖大规模算力堆叠来提升模型能力。白皮书的核心观点是,这种线性思维忽略了算法效率、架构创新与数据质量等变量。单纯比拼算力规模,带来的边际收益正在递减,而成本、能耗与工程复杂度却持续攀升。作者呼吁业界把注意力从"谁的集群更大"转向"谁的方案更聪明"。
需要说明的是,原始素材只提供了标题与讨论性质,未披露白皮书的具体技术细节、实验数据或作者背景。因此本文更多是对该议题的框架性梳理,而非对白皮书结论的逐条解读。
边际收益递减是经济学中的基础概念,指在其他投入不变时,持续增加某一要素的投入,其带来的额外产出会逐渐减少。在AI训练中,这一规律体现为:当模型参数和训练数据达到一定规模后,继续增加GPU数量或训练时长所能带来的性能提升越来越小。以OpenAI的Scaling Law研究为例,早期模型规模翻倍可带来显著的能力跃升,但近年来的实践表明,同等算力增量对应的基准测试提升幅度已明显收窄。这正是白皮书讨论中“线性思维失效”的技术依据——算力投入与模型能力之间并非简单的正比关系,而是存在收益拐点。理解这一概念,有助于把握为何单纯堆叠硬件不再是高效路径。
从规模驱动到效率驱动
白皮书讨论隐含的方向,是将优化重心从硬件规模转向系统效率。这包括更高效的训练算法、更合理的模型架构选择,以及对推理阶段的成本控制。对从业者而言,这意味着评估一个AI方案的维度不应只有"用了多少卡",还应包括单位算力产出的有效能力。这一视角对资源有限的中小团队尤其有意义。
单位算力产出的有效能力是衡量AI系统效率的关键指标,通常可理解为“每FLOP(浮点运算次数)所换取的模型性能提升”。这一概念将关注点从绝对算力规模转向算力利用效率。具体而言,它涉及训练阶段的样本效率(用更少数据达到同等精度)、架构效率(如混合专家模型MoE通过稀疏激活降低单次推理计算量)以及推理阶段的成本控制(如量化、蒸馏等技术)。对中小团队而言,这一指标比“拥有多少张A100/H100”更具指导意义,因为它直接反映了有限预算下能否获得可用的模型能力。业界近年兴起的“每美元性能”评估方式,正是这一思路的量化体现。
对行业实践的启示
如果算力竞赛的边际收益递减成立,那么开源社区与中小玩家反而可能获得更多空间——它们被迫在效率上创新,而非在预算上比拼。同时,企业采购与研发决策也应更审慎地权衡算力投入与算法回报。这类讨论的价值,在于提醒行业警惕路径依赖,保持对替代技术路线的开放态度。
结语
这篇来自Reddit的技术白皮书讨论,本质上是给"算力至上"的主流叙事提了个醒。在没有看到完整白皮书之前,我们不宜对其技术主张下定论,但它提出的问题值得每一个AI从业者认真对待:我们究竟是在解决问题,还是只是在堆硬件?
相关推荐
AI Agent落地实战:用WorkBuddy打造智能办公助理
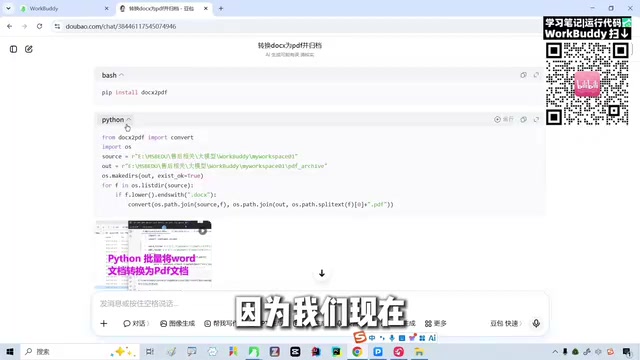
本文通过实战案例演示如何用腾讯WorkBuddy完成文件批量转换与归档,对比聊天大模型与AI Agent的能力差异,分析WorkBuddy的积分体系、适用场景与产品定位,为办公自动化选型提供参考。
从单卡瓶颈到千亿参数:大模型分布式并行6大关键问题
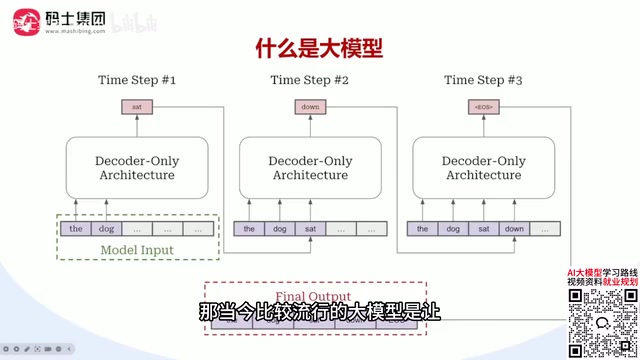
基于B站教程梳理大模型分布式并行核心知识:从decoder-only架构的逐token生成与X乘W计算本质出发,解析单卡瓶颈下数据并行、张量并行、流水线并行等6个关键问题,适合私有化部署与模型训练场景的学习者建立系统认知。
AI新物种FDE落地实战:三大职责与就业指南
从B站直播实战演示出发,解析AI新物种FDE(前沿部署工程师)的三大核心职责、团队角色分工与就业学习路径,帮助开发者理解这一介于算法与业务之间的新岗位。