Gemini 3.7 Flash定价分析:性价比究竟如何?
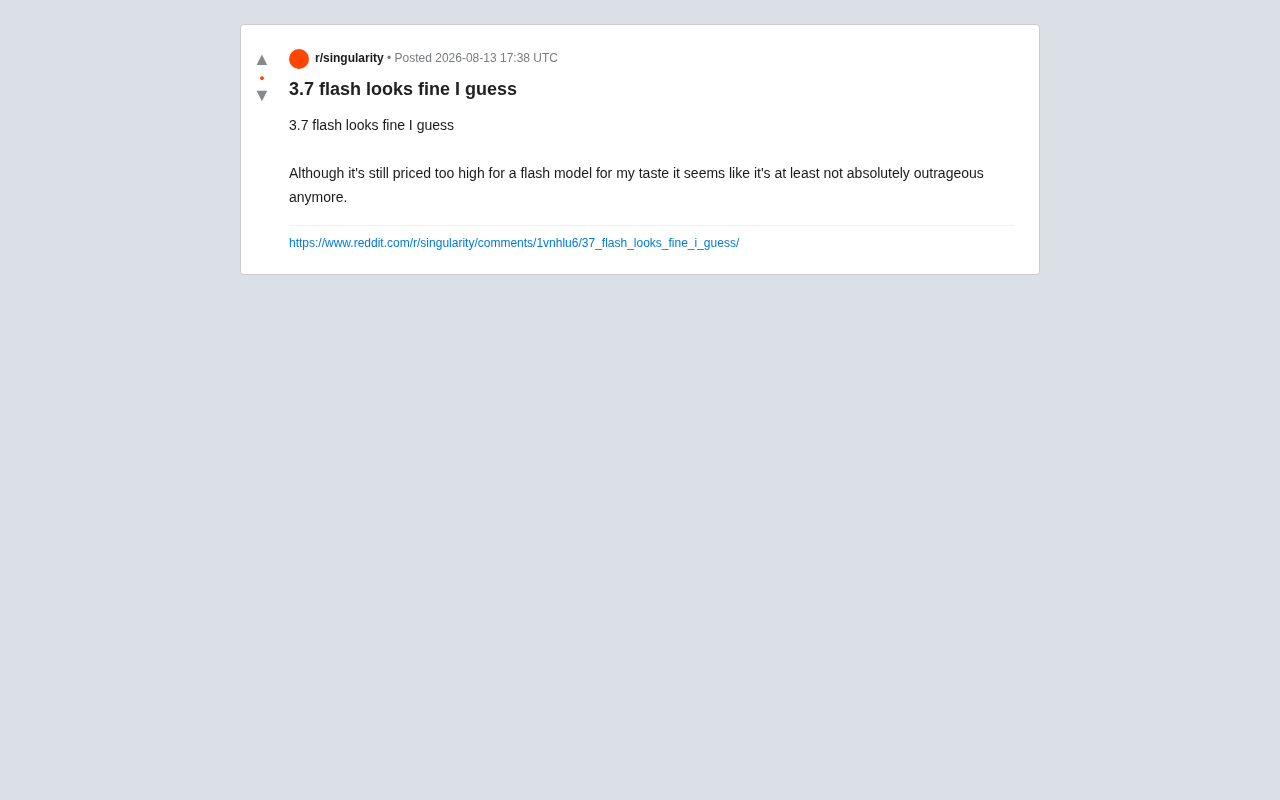
一款Flash模型引发的定价讨论
在AI模型迭代节奏日益加快的当下,Google的Gemini Flash系列一直是开发者社区关注的焦点。近日,Reddit社区中一则关于Gemini 3.7 Flash的帖子引发了不少讨论。发帖者的态度颇为微妙——既认可模型本身的表现,又对其定价策略表达了保留意见。
"3.7 flash looks fine I guess. Although it's still priced too high for a flash model for my taste it seems like it's at least not absolutely outrageous anymore."
这段简短的评价,实际上折射出当前AI模型市场中一个核心矛盾:性能提升与成本控制之间的平衡。
Flash模型的定位与定价逻辑
什么是Gemini Flash模型?
Flash类模型在Google整个大模型产品矩阵中扮演着独特的角色。相较于旗舰级的Pro或Ultra版本,Gemini Flash模型主打低延迟、高吞吐、低成本的特性,专为需要大规模、高频率调用的场景设计,例如内容分类、实时对话、批量数据处理等。
Flash模型之所以能实现这些特性,核心在于模型蒸馏(Model Distillation)和架构优化技术。Google通常会将旗舰模型(如Gemini Pro/Ultra)的知识通过知识蒸馏的方式压缩到更小的模型中,在保留大部分推理能力的同时大幅减少参数量和推理所需的计算资源。知识蒸馏的基本原理是让一个"学生模型"(小模型)学习"教师模型"(大模型)的输出概率分布,而非仅学习训练数据的硬标签。通过这种方式,学生模型能够捕获教师模型对各类输入的细腻理解——包括"这个答案有70%的把握是A、25%是B"这样的软信息——从而以远少于教师模型的参数量实现接近的推理效果。Google在Gemini系列中广泛运用了这一技术,使得Flash模型能够在数十亿参数级别上接近百亿甚至千亿参数旗舰模型的表现。
此外,Flash模型还会采用混合专家(Mixture of Experts, MoE)架构、量化压缩、推测解码(Speculative Decoding)等技术手段来加速推理速度。MoE架构的核心思想是将模型拆分为多个"专家"子网络,每次推理时通过一个路由机制(Router/Gating Network)只激活其中一小部分专家来处理当前输入。例如,一个拥有总计2000亿参数的MoE模型,每次推理可能只激活200亿参数的专家组合,这意味着实际的计算开销只相当于一个200亿参数的稠密模型,但由于拥有更大的参数容量,模型可以覆盖更广泛的知识和能力。Google的Switch Transformer以及后续的Gemini系列都大量运用了这一架构。推测解码(Speculative Decoding)则是另一项关键的推理加速技术:它使用一个轻量级的"草稿模型"(Draft Model)快速自回归地生成一段候选token序列,然后由目标大模型对这些候选token进行一次性并行验证。由于Transformer架构在并行验证多个位置时的效率远高于逐个生成,这种策略可以在不损失任何输出质量的前提下,将推理速度提升2-3倍甚至更多。量化压缩则是将模型权重从标准的FP32(32位浮点数)或FP16精度降低到INT8甚至INT4精度,在每个权重仅占用4-8位存储的情况下,显存占用和计算量都大幅下降,推理速度相应提升。近年来GPTQ、AWQ、GGUF等量化方案日趋成熟,使得量化后的质量损失可以控制在极小范围内。这些技术的叠加使得Flash模型在每次API调用中消耗的GPU算力显著低于旗舰模型,从而为低价策略提供了技术基础。
正因如此,Flash模型的定价一直被视为其核心竞争力之一。开发者选择Flash,往往正是冲着"够用且便宜"这一点。当一款Flash模型的价格上探到接近中端模型的区间时,其存在的意义就会被打上问号。
用户为何对Gemini Flash定价如此敏感?
从这位Reddit用户的表述中可以读出两层信息:
第一,模型的实际能力是过关的("looks fine")。这说明在性能维度上,Gemini 3.7 Flash并没有明显短板,甚至可能在推理能力、上下文处理等方面有所提升。
第二,价格"仍然偏高"("priced too high for a flash model"),但相比之前已经"不再离谱"("not absolutely outrageous anymore")。这个措辞非常关键——它暗示了此前某个版本的定价曾经引发过强烈不满,而这次的调整是一种朝着合理方向的修正,尽管尚未完全达到用户心理预期。
要理解这种敏感度,需要了解当前AI API的定价体系。行业通常以每百万输入/输出token为单位计算费用。这里的"token"并非简单等同于一个单词或一个字符,而是由分词算法(Tokenizer)将文本切分后得到的最小处理单元。主流大模型普遍采用BPE(Byte Pair Encoding,字节对编码)或类似的子词分词算法——这类算法通过统计语料库中的高频字符组合,将常见词保留为单个token,而将罕见词拆分为多个子词token。例如,英文单词"understanding"可能被分为"under"+"standing"两个token,而常见词"the"则作为一个完整token处理。值得注意的是,中文等非拉丁语系在token化时通常效率较低:一个中文汉字可能消耗1.5-2个token,而一个英文单词平均约消耗1-1.3个token。这意味着处理同样语义量的中文文本,实际token消耗可能比英文高出50%-80%,这在跨语言应用的成本核算中是一个不可忽视的因素。不同模型厂商使用的分词器也各不相同,导致同一段文本在不同模型上的token数量可能有10%-30%的差异,这进一步增加了跨平台成本比较的复杂性。
以2024-2025年的市场行情为参照,OpenAI的GPT-4o Mini输入价格约为每百万token 0.15美元,Anthropic的Claude 3.5 Haiku约为0.80美元,而Google Gemini 2.0 Flash曾定价在每百万token 0.10美元左右。Flash类模型的定价通常需要控制在旗舰模型的十分之一到五分之一区间,才能在市场中维持"经济型"定位的可信度。一旦价格突破这一隐形阈值,开发者就会质疑其作为Flash产品的合理性。
更值得注意的是,对于大规模调用场景,API定价的微小差异会在业务层面被急剧放大。例如,一个日均处理1000万次请求的内容审核系统,如果每次请求消耗约500个token,那么每百万token价格每增加0.01美元,月度成本就会增加约1500美元。这解释了为何Flash模型的用户群体对定价如此敏感——在他们的业务模型中,API成本往往是仅次于人力的第二大支出项,价格的细微波动直接影响产品的毛利率甚至商业可行性。许多AI初创公司在融资pitch中会明确列出"LLM API成本占收入比"这一关键指标,投资人也越来越关注该指标是否具有随规模扩大而下降的趋势。当Flash模型定价高于预期时,这些公司的单位经济模型(Unit Economics)就会面临压力,迫使它们要么提高终端用户售价(可能损失竞争力),要么压缩其他环节的成本,或者干脆更换模型供应商。
定价策略背后的商业博弈
成本与竞争的双重压力
对于Google而言,Gemini Flash系列的定价并非单纯的成本加成,而是一场复杂的市场博弈。一方面,随着模型能力的提升,底层的算力与训练成本客观上在增加;另一方面,来自OpenAI、Anthropic以及国产开源模型的激烈竞争,又迫使各家在价格上不能过于激进。
在国产开源模型方面,以DeepSeek、Qwen(通义千问)、GLM等为代表的中国AI公司推出的开源大模型正在形成强有力的竞争冲击。这些模型不仅性能快速逼近国际一线水平,更关键的是其API调用价格往往远低于海外厂商,部分模型甚至可以本地部署实现零边际成本运行。DeepSeek-V3等模型在多项基准测试中表现出色,其API定价仅为同级别海外模型的几分之一。
事实上,开源模型对商业API定价的影响远不止于中国厂商。Meta的Llama系列(从Llama 2到Llama 3.1)、Mistral AI的Mistral和Mixtral系列、以及Stability AI等公司发布的开源模型,正在从根本上重塑AI模型的定价逻辑。当一个性能接近GPT-4o Mini的开源模型可以免费下载并在自有服务器上运行时,商业API的定价天花板就被隐形地锁死了——它必须低于"用户自行部署开源模型的综合成本",否则有技术能力的用户就会选择自建推理服务。对于中小规模调用量的用户来说,云端API仍然具有免去运维负担、弹性伸缩等优势;但对于日均调用量达到数百万次的大客户而言,购买或租赁GPU集群部署开源模型的单次推理边际成本可能远低于商业API价格。这种"自建 vs 外购"的博弈持续施压,推动着Flash级别商业API的价格不断走低。
这种价格冲击迫使Google、OpenAI等厂商在Flash/Mini级别产品线上不断压缩利润空间,以防止价格敏感型用户大规模迁移。
Flash模型的目标客户群体,恰恰是那些对成本极度敏感的中小开发者和初创团队。这部分用户的迁移成本相对较低——由于大多数大模型API遵循相似的RESTful接口规范,且社区已经开发出LiteLLM、OpenRouter等API聚合与适配工具,开发者在不同模型之间切换的技术门槛已经大幅降低。
LiteLLM是一个开源的Python库,它将超过100个不同LLM提供商的API统一封装为OpenAI兼容的接口格式。开发者只需更改一个模型名称参数(例如从gpt-4o-mini改为gemini/gemini-2.0-flash),即可无缝切换底层模型,而无需修改任何上层业务逻辑代码。OpenRouter则更进一步,它作为一个API网关服务,不仅提供统一接口,还支持自动路由——开发者可以设定成本、速度、质量等优先级,由OpenRouter根据实时价格和可用性自动选择最优模型。这些工具本质上将模型API"商品化"了,使得各家模型在开发者眼中的差异主要体现在性能和价格两个维度,而非接口兼容性。
许多应用框架(如LangChain、LlamaIndex)也提供了模型无关的抽象层,只需修改几行配置即可更换底层模型。LangChain通过其ChatModel抽象类为所有支持的LLM提供统一的调用接口,开发者基于这一抽象层构建的RAG(检索增强生成)流水线、Agent系统和对话链,可以在不同模型之间无感切换。LlamaIndex则在向量检索和知识库构建层面提供了类似的模型无关性。这种架构设计理念正在成为AI应用开发的行业标准——开发者在构建应用时越来越倾向于将模型视为可替换的"插件",而非紧耦合的核心组件。这意味着模型厂商很难通过技术锁定来留住用户,价格和性能的综合性价比成为竞争的核心战场。一旦价格失去优势,他们随时可能转向更便宜的替代方案。因此,"不再离谱"这个评价,本身就是市场压力下厂商做出让步的信号。
性价比才是Flash模型的生命线
说个细节,用户对"fine"的模型仍持保留态度,核心症结正在于价值感知的错位。当一款产品定位为"经济型"却又标出偏高的价格时,用户会自然而然地拿它与更高端的产品做对比,反而放大了对价格的敏感度。
这种心理现象在经济学中被称为"价格锚定效应"(Price Anchoring)——用户对Flash模型的价格预期已经被此前的低价定位锚定在了一个较低的区间,当新版本价格上移时,即使性能有所提升,用户感知到的"涨价幅度"也会被放大。与此同时,"比较参照系"也在发挥作用:如果Flash的价格接近了某款中端模型,用户会自然地思考"多花30%的钱能否直接用中端模型获得显著更好的效果",这种跨层级的比价进一步削弱了Flash模型在当前价位上的吸引力。
这提醒了所有AI产品的定价者:Flash类模型的核心承诺是"极致性价比",任何偏离这一核心定位的定价,都需要用足够显著的性能提升来弥补,否则就会陷入"高不成低不就"的尴尬境地。
从用户反馈看AI市场的成熟
AI用户越来越理性
这条看似随意的Reddit评论,实际上反映了AI用户群体正在快速走向成熟。早期的AI热潮中,用户往往被"新功能""更强性能"所吸引,对价格的敏感度较低。而如今,随着可选方案越来越多,用户开始像评估任何一款成熟工具一样,冷静地权衡能力、成本与实际需求之间的关系。
这种转变也与AI行业进入"祛魅期"(Disillusionment Phase)有关——Gartner技术成熟度曲线(Hype Cycle)中,一项技术在经历了"期望膨胀的峰值"之后,会进入"泡沫破灭的低谷期",用户和市场开始回归理性,更加关注实际交付价值而非概念炒作。当前LLM市场的多个迹象——用户更关注性价比而非参数量、基准测试分数的边际提升不再引发狂热、"够用就好"的实用主义抬头——都表明大模型技术正在从炒作周期过渡到务实应用阶段。在这个阶段,能够存活的产品不是"最强的",而是"在目标场景中性价比最优的"。
"looks fine I guess"这种略带保留的语气,正是理性消费心态的典型体现——不盲目追捧,也不全盘否定,而是基于实际使用价值做出判断。
开发者选型建议与结语
对于正在选型的开发者来说,围绕Gemini 3.7 Flash的这则讨论提供了一个有价值的参考视角:
- 不要只看模型能力榜单,还要综合考虑单位调用成本与业务规模的匹配度。常用的评估方法是计算"每美元性能"(Performance per Dollar),即选取与自身业务最相关的几项基准测试指标,除以对应的API成本,得出一个标准化的性价比分数来横向比较不同模型;
- 关注厂商的定价趋势,价格的下调往往意味着竞争加剧,也意味着更好的议价空间。对于大批量调用的企业用户,主流厂商通常提供承诺用量折扣(Committed Use Discounts)或批量处理(Batch API)模式,后者可以通过接受更长的响应延迟来换取30%-50%的价格优惠;
- 建立自己的评测基准,用真实业务场景去验证一款Flash模型是否"物有所值"。可以设计包含典型输入样本的测试集,从准确率、延迟、token消耗量、错误率等多个维度进行系统性评估,而非依赖通用排行榜上的数字;
- 善用API适配工具,借助LiteLLM、OpenRouter等聚合平台保持模型切换的灵活性,避免被单一供应商锁定。一个良好的实践是在应用架构中预留模型切换的抽象层,并定期(例如每季度)对市场上的新模型进行性价比复评。
Gemini 3.7 Flash"看起来还行",价格"不再离谱"——这样一句朴素的评价,背后是AI模型市场从野蛮生长走向精耕细作的缩影。对厂商而言,如何在性能提升的同时守住Flash系列的性价比底线,将是持续的考验;对用户而言,保持理性、用数据说话,才是驾驭这场技术浪潮的最佳姿态。
随着更多竞品的入场,我们有理由相信,Flash类模型的定价还将继续朝着更合理的方向演进。而这,正是竞争带给市场的最好礼物。
相关推荐
DSH白嫖DeepSeek V4.1 Flash:积分批量领取与国际版WorkBuddy实测
DSH项目最新升级实测:WorkBuddy端可批量领取100积分,限流额度提升、重置时间缩短,国际版WorkBuddy现已支持免费调用混元4与DeepSeek V4.1 Flash,附使用建议与风险提示。
DSH-SUBAGENT-UI插件:DeepSeek Harness子代理管理神器
DSH-SUBAGENT-UI 是 DeepSeek Harness Web 客户端插件,提供子代理总览、搜索、本地分类与完成快照功能,数据存本地不侵入原会话,一条命令即可安装,助力多子代理工作流高效管理。
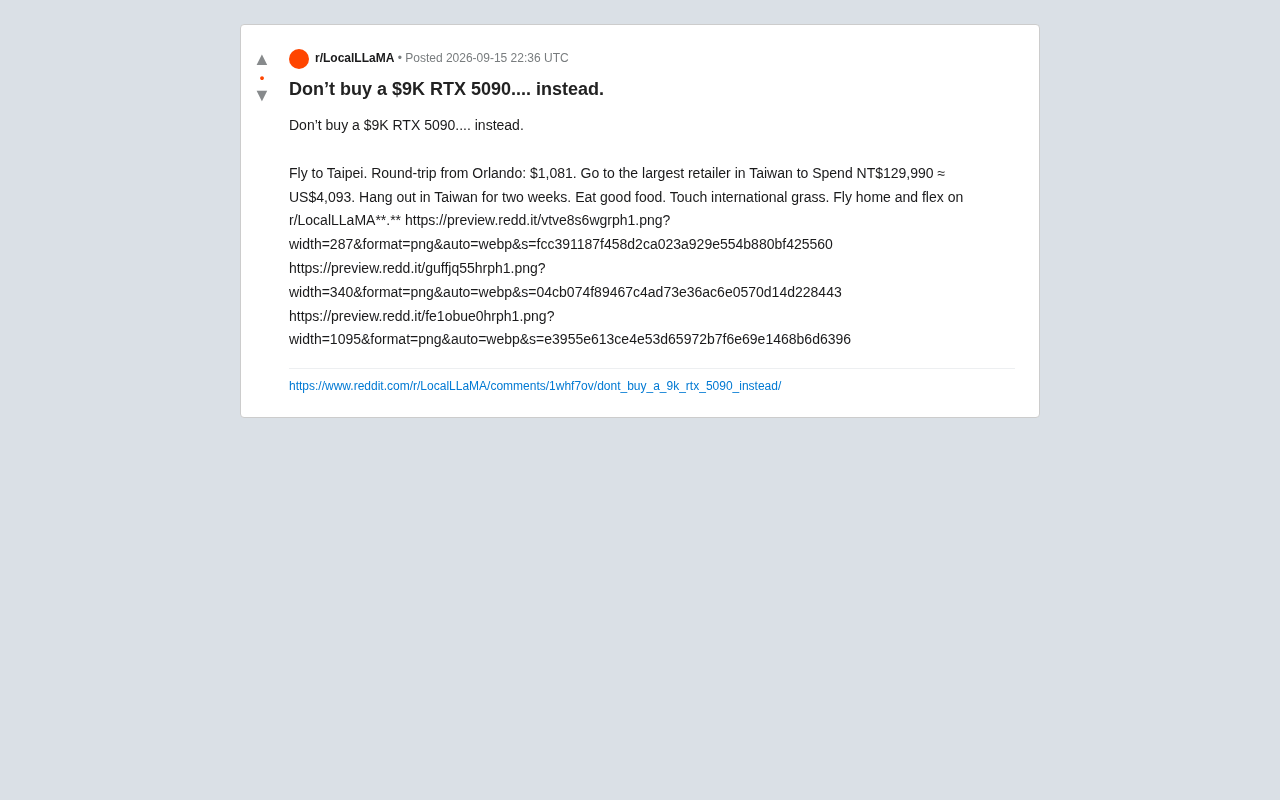
美国RTX 5090炒到9千美元?飞台北抢购反而更划算
美国RTX 5090被炒到9000美元,Reddit网友算了笔账:飞台北往返机票加显卡本体仅约5千美元。这个段子背后,是本地AI大模型热潮下高端显卡供需失衡的真实写照。