Gemini 3.8 Flash或本周发布:快模型为何正在取代旗舰Pro
一则社区传闻背后的行业趋势
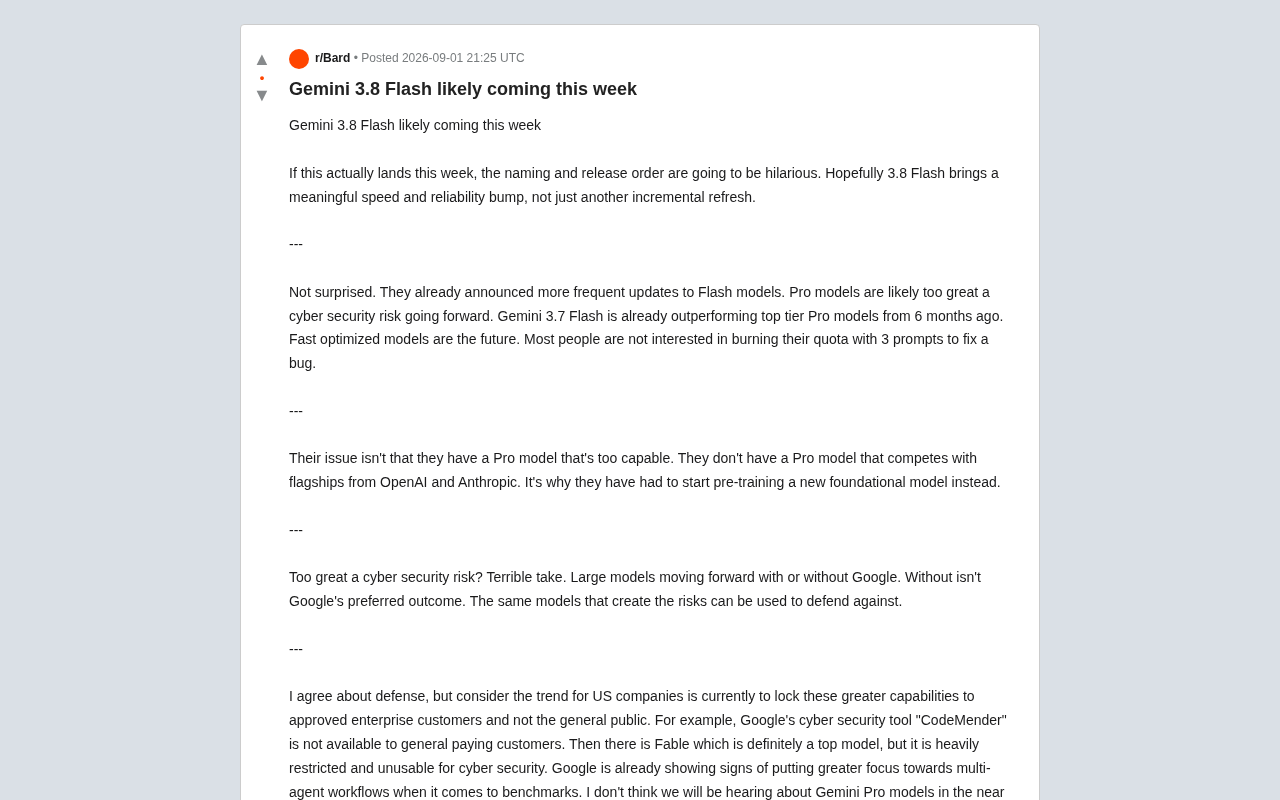
近日,Reddit AI社区流传着一则消息:谷歌可能在本周发布Gemini 3.8 Flash。虽然消息尚未得到官方证实,但围绕这一传闻展开的社区讨论,却意外揭示了当前大模型竞争格局中一个值得关注的趋势——轻量化、高速度的Flash型模型正在成为主流关注焦点,而昂贵的旗舰Pro模型反而陷入了某种沉默。
如果这次更新如期落地,其命名和发布节奏本身就颇具戏剧性。有社区成员打趣道,如此频繁的版本迭代(从3.7到3.8)让整个发布顺序显得有些混乱。但玩笑之外,大家更关心的是:Gemini 3.8 Flash能否带来实质性的速度和可靠性提升,而不仅仅是又一次增量式的常规刷新。
为什么Flash模型越来越重要
围绕这次传闻,社区中最有共识的一点是:优化后的快速模型正在成为未来。
要理解这一趋势,首先需要明确Flash和Pro这两条产品线的技术定位差异。在大模型产品线中,Flash型模型通常采用更少的参数量或更高效的架构设计来实现更低的延迟和更低的API调用成本。其中最关键的技术之一是混合专家模型(MoE,即Mixture of Experts)。MoE的核心思想可以追溯到1991年,但真正在大语言模型领域大放异彩是近两年的事。传统的密集模型(dense model)在每次推理时都会激活全部参数,而MoE模型则将参数分散到多个"专家"子网络中,通过一个门控网络(gating network)动态决定每次只激活其中少数几个专家来处理输入。例如,一个拥有1万亿参数的MoE模型,实际推理时可能只激活其中的1000-2000亿参数,这意味着它在保持大模型级别知识容量的同时,推理成本接近一个中等规模的密集模型。谷歌的Gemini系列被广泛认为采用了MoE架构,而OpenAI的GPT-4也被传闻使用了类似设计。这种架构天然适合Flash型产品线——它让"小而快"和"博而精"不再矛盾。
除了MoE之外,知识蒸馏也是构建Flash型模型的核心技术手段。知识蒸馏(Knowledge Distillation)由Geoffrey Hinton等人在2015年提出,其原理是让一个小型"学生模型"学习大型"教师模型"的输出概率分布,而非直接学习原始数据。教师模型对每个可能的输出都会给出一个概率值(即"软标签"),这些软标签包含了比硬标签(正确答案)更丰富的信息——例如,教师模型判断"猫"和"豹"之间的相似度远高于"猫"和"汽车",这种隐含的知识关系能帮助学生模型更高效地学习。在大语言模型领域,蒸馏已成为构建轻量级模型的标准手段之一,谷歌的Gemma系列开源模型就大量使用了从Gemini旗舰模型蒸馏而来的知识。此外,量化压缩(将模型权重从高精度浮点数压缩为低精度整数)等技术也被广泛应用。Pro型模型则保留更大的参数规模和更复杂的推理链路,追求在困难任务上的极限表现。谷歌将Flash定位为面向高并发、低成本场景的主力产品,而Pro则瞄准需要深度推理的高端场景。
有观点指出,谷歌此前已经宣布将对Flash系列模型进行更频繁的更新。这一策略选择的背后有着现实逻辑:Gemini 3.7 Flash据称已经能够超越六个月前顶级Pro模型的表现。换句话说,模型能力的进步速度,正在让轻量级模型追平甚至反超旧旗舰。
用户体验的现实考量
更关键的是用户侧的真实需求。正如一位社区成员所言:"大多数人并不想为了修复一个bug而烧掉自己的配额,连发三个提示词。"
这句话点破了产品逻辑的核心。对于绝大多数日常使用场景——写代码、改bug、生成文案——用户真正在意的是响应速度、成本可控、结果稳定,而非那零点几个百分点的基准测试提升。说到基准测试,值得一提的是,AI行业常用MMLU(大规模多任务语言理解)、HumanEval(代码生成)、MATH(数学推理)等标准化测试集来衡量模型能力,但这些分数与真实使用体验之间往往存在显著鸿沟。一个模型可能在MMLU上领先对手两个百分点,但在实际对话中却表现出更多的幻觉或指令遵循问题。
业界越来越多地采用Chatbot Arena这样的人类盲评来补充传统基准,也正是因为认识到了单一分数的局限性。Chatbot Arena由加州大学伯克利分校的LMSYS团队创建和维护,是目前AI领域最具公信力的模型评估平台之一。其核心机制是"双盲对比":用户提交一个提示词,系统随机分配两个匿名模型同时生成回答,用户在不知道模型身份的情况下选择更好的回答,最终通过借鉴国际象棋排名的Elo评分系统对所有参与模型进行排名。截至2025年,Chatbot Arena已累积超过200万次人类投票,其排名结果多次与传统基准测试产生显著差异——有些在MMLU上得分极高的模型在Arena中排名平平,反之亦然。这使得Arena排名成为衡量模型"真实用户体验"的重要参考。
一个能快速、可靠地一次性解决问题的Flash模型,往往比一个昂贵、缓慢、需要反复调用的Pro模型更有实际价值。这也解释了为什么谷歌选择在Flash产品线上加大迭代频率:它更贴近真实的规模化使用需求。
Gemini Pro模型的沉默:能力问题还是战略选择
讨论中最激烈的争论,集中在"为什么Gemini Pro模型近期声量不足"这一问题上。社区形成了几种截然不同的解读。
观点一:Pro模型竞争力不足
最直接的批评认为,谷歌的问题不在于"Pro模型太强大",而恰恰在于它没有一款能与OpenAI和Anthropic旗舰正面竞争的Pro模型。有成员指出,这也是谷歌不得不重新开始预训练新一代基础模型的原因。
持这一观点的人进一步推测,之所以迟迟不见新Pro模型发布,更可能是因为其基准测试指标"对股东来说过于难堪"——这是一种颇为犀利的商业解读。
观点二:网络安全风险导致有意限制
另一派观点认为,Pro级别的强大模型正日益成为网络安全层面的风险,因此谷歌可能有意限制其向公众开放。
这一担忧并非毫无根据。以谷歌的网络安全工具CodeMender为例——这款主要用于代码漏洞检测和修复建议的AI工具并未向普通付费用户开放。此类工具受限的背后,涉及AI安全领域的"双重用途"(dual-use)难题:同一个能发现漏洞的AI模型,也可以被恶意行为者用来寻找和利用漏洞。
零日漏洞(zero-day vulnerability,即尚未被软件厂商知晓和修复的安全漏洞)之所以危险,是因为从漏洞被发现到补丁发布之间存在一个"时间窗口",攻击者可以在这段时间内肆意利用漏洞进行攻击。2024年,卡内基梅隆大学和UIUC的研究团队分别发表论文证明,GPT-4等先进大模型在获得CVE(通用漏洞和暴露数据库)描述后,能够自主编写攻击代码并成功利用真实软件中的漏洞,成功率在某些测试中超过80%。这一发现直接促使美国政府在其AI安全行政令中加入了对具有网络攻击能力的AI模型的报告和管控要求。谷歌、OpenAI、Anthropic等公司也相应建立了内部的"红队测试"(Red Teaming)流程,在模型发布前专门评估其被滥用于网络攻击的风险。
社区中提到的另一款顶级模型Fable同样受到严格限制,无法用于网络安全场景。这些案例似乎印证了一个趋势——将更强的AI能力锁定给经过审批的企业客户,而非普通公众。
不过,这一说法立即遭到反驳。反对者认为这是个"糟糕的观点":无论谷歌是否参与,大模型都会继续向前发展;而且,制造风险的同样模型,也可以被用来构建防御。"让最好的工具去竞争",这才是更健康的生态逻辑。
分歧下的共同判断
有意思的是,即便在"权限化发布是否有效"这一点上双方存在分歧(有人认为白名单其实拦不住真正的坏人,permissioned rollout的实际效果存疑),但双方都倾向于认为:
没有什么能力会被"永久"锁定,公众迟早会用上,只是时间早晚的问题。
算力与规模化:谷歌的真正瓶颈在哪里
在技术层面,社区还提出了关于规模化困境的讨论。
一种看法认为,谷歌在scaling(规模扩展)上遇到了麻烦——单纯把模型做大,在其他条件不变的情况下,通常并不会让模型变得好很多。这实际上是整个AI行业都在面对的"规模收益递减"问题。这一问题的理论根源来自AI领域著名的Scaling Laws研究:OpenAI在2020年发表的论文表明,模型性能与参数量、数据量、计算量之间存在幂律关系,增加这三者中的任何一个都能带来可预测的性能提升。然而,随着模型规模逼近某些边界,继续增加参数所带来的边际收益开始急剧下降,而训练成本却线性甚至超线性增长。据估计,训练一个万亿参数级别的密集模型所需的电力和硬件成本可能超过10亿美元,而其性能提升相比于规模仅为其十分之一的模型可能不到20%。
这促使业界转向更高效的训练方法,如混合专家模型(MoE)、推理时计算扩展(test-time compute scaling,即在推理阶段投入更多计算资源来提升输出质量,而非一味增大训练规模)、以及合成数据训练等替代路径。推理时计算扩展的典型代表是OpenAI的o1/o3系列模型和谷歌的Gemini 3.7 Flash with thinking——它们在回答复杂问题时会进行多步内部"思考",消耗更多的推理算力来换取更高质量的输出,本质上是将训练阶段无法继续提升的能力,转移到推理阶段通过更多计算来弥补。谷歌的Gemini系列据信就采用了MoE架构来应对规模收益递减的挑战。
另一种看法则聚焦于算力供给:也许谷歌根本没有足够的算力容量来服务新的Pro模型,即便不发布,现有服务也已经出现压力。
但这一说法同样受到了反驳。有成员指出,在原始硬件算力储备方面,谷歌实际上远超Anthropic和OpenAI。这里的底气来自TPU(Tensor Processing Unit)——谷歌自主研发的AI专用芯片,目前已迭代至第六代(Trillium/TPU v6e)。TPU最初于2016年发布,其设计哲学与NVIDIA GPU有本质区别。GPU是通用并行计算芯片,而TPU从一开始就针对深度学习中的矩阵乘法运算进行了硬件级优化。第六代TPU相比前代在训练性能上提升约4.7倍,并且支持更大规模的Pod级互联——多达数万颗TPU通过谷歌自研的高速互联网络连接成一个超大规模计算集群。这种软硬件一体化的垂直整合能力是谷歌独有的优势:NVIDIA需要依赖第三方云厂商来部署其GPU,而谷歌的TPU从芯片设计、集群网络到上层的JAX/TensorFlow软件栈,全部由自己掌控。据估计,谷歌内部的TPU算力储备相当于数十万颗NVIDIA H100 GPU的等效算力。
如果谷歌真想部署Pro模型,完全有能力做到。真实情况可能是一种战略选择:
谷歌似乎更愿意让OpenAI和Anthropic租用自己的TPU,然后让它们在前沿领域相互厮杀。
这一观点颇具深意——作为TPU基础设施的提供方,谷歌在AI竞赛中既是选手,也是"军火商"。值得注意的是,Anthropic正是TPU的重要外部客户之一,其Claude系列模型的训练大量依赖谷歌云的TPU集群。谷歌在2023年向Anthropic投资了约20亿美元,并承诺提供价值数十亿美元的云计算资源。这构成了一种独特的竞合关系:谷歌既在模型层面与Anthropic直接竞争,又通过基础设施层面的TPU租赁和资本投资从对手的成长中持续获利。让竞争对手用自己的算力去打仗,本身就是一门稳赚不赔的生意。
多智能体工作流:谷歌的下一步押注
讨论中还提到了一个重要信号:谷歌在基准测试上正越来越倾向于多智能体(multi-agent)工作流。其近期推出的Antigravity相关项目,就体现了向多智能体协作方向的倾斜。
多智能体工作流是一种让多个AI模型实例各自承担不同角色或任务,通过协调与通信来完成复杂目标的系统架构。举个具体的例子:在一个软件开发场景中,可能有一个Agent负责需求分析,一个负责代码编写,一个负责代码审查,一个负责测试——它们之间通过结构化消息传递进行协作。这种范式的核心优势在于:每个Agent可以使用更轻量、更专精的模型,整体系统的可靠性和可控性反而优于依赖单个全能大模型的方案。
谷歌近期在这一方向的持续投入尤为引人注目。Project Mariner是谷歌推出的面向浏览器操作的AI代理,它能够理解网页内容、执行点击和输入操作、在不同网页间导航来完成用户指定的任务。而A2A协议(Agent-to-Agent)则是谷歌在2025年初推出的开放标准,旨在解决多智能体系统中的互操作性问题。在此之前,不同公司或框架构建的AI代理之间缺乏统一的通信标准——LangChain、AutoGen、CrewAI等框架各自定义了自己的代理间通信方式,导致跨框架协作几乎不可能。A2A协议定义了代理发现(Agent Discovery)、能力描述(Capability Declaration)、任务委派(Task Delegation)和状态同步(State Synchronization)等核心机制,使得不同来源的AI代理可以像微服务一样被灵活编排。这一协议的推出表明谷歌正试图在多智能体生态中扮演"标准制定者"的角色,类似于Android在移动操作系统领域的定位策略。这些举措都暗示其产品战略正从"单模型能力竞赛"转向"系统级智能编排"。
这或许意味着,谷歌未来的竞争重心不再是单纯堆砌单个Pro模型的绝对能力,而是转向多个优化模型协同工作的系统级方案。在这种范式下,快速、廉价、可靠的Flash型模型作为基础组件,其战略重要性会进一步凸显——它们就像流水线上的高效工人,虽然单个能力有限,但协同起来可以完成远超单一"全能专家"的复杂任务。这也解释了为什么谷歌对Flash系列的迭代如此积极:在多智能体架构中,每个Agent的推理成本和响应速度直接决定了整个系统的经济可行性。如果每个Agent都使用昂贵的Pro模型,一个由十个Agent组成的工作流的运行成本将高得令人望而却步。
快模型时代正在到来
综合来看,无论Gemini 3.8 Flash是否会在本周准时发布,这场社区讨论都折射出一个清晰的行业转向:
模型竞争的焦点,正在从"谁的旗舰更强",逐渐转向"谁能提供更快、更省、更可靠、更适合规模化部署的模型"。Flash型模型的频繁迭代、多智能体工作流的兴起、以及算力作为战略资产的博弈,共同勾勒出一个务实而复杂的AI竞争图景。
对于普通用户和开发者而言,这未尝不是好消息——毕竟,能一次把bug修好的快模型,远比反复烧配额的"超级大脑"更贴近日常。
核心要点
核心要点
相关推荐
GPT-6控制Blender生成白膜:AI视频可控化新方案
B站UP主深白色实测用GPT-6通过Codex控制Blender生成白膜预演视频,再结合Seedance 2.5渲染成片,实现AI视频镜头运镜的高度可控。本文梳理完整流程、GPT-6与5.6分工省Token技巧及成本对比。
GPT-6 Astra实测:5个案例横评AGI是骡是马
GPT-6 Astra正式发布后实测横评:通过宇宙网页、苹果风产品页、植物大战僵尸、Blender建模、厦门城市漫游5个案例,对比GPT-6、Kimi K3与GLM 5.3的真实表现,探讨AGI成色与AI时代的核心竞争力。
孙正义押注OpenAI豪赌AGI:从雅虎到GPT-6的独角兽猎手
GPT-6 Astra发布后软银市值4天暴涨700亿美元,幕后赢家是押注OpenAI的孙正义。本文梳理他从雅虎、阿里到ARM与OpenAI的投资传奇,解读其独角兽猎手的逻辑与AI豪赌。