Gemini 3.8 Live 上手:谷歌语音对语音模型实测
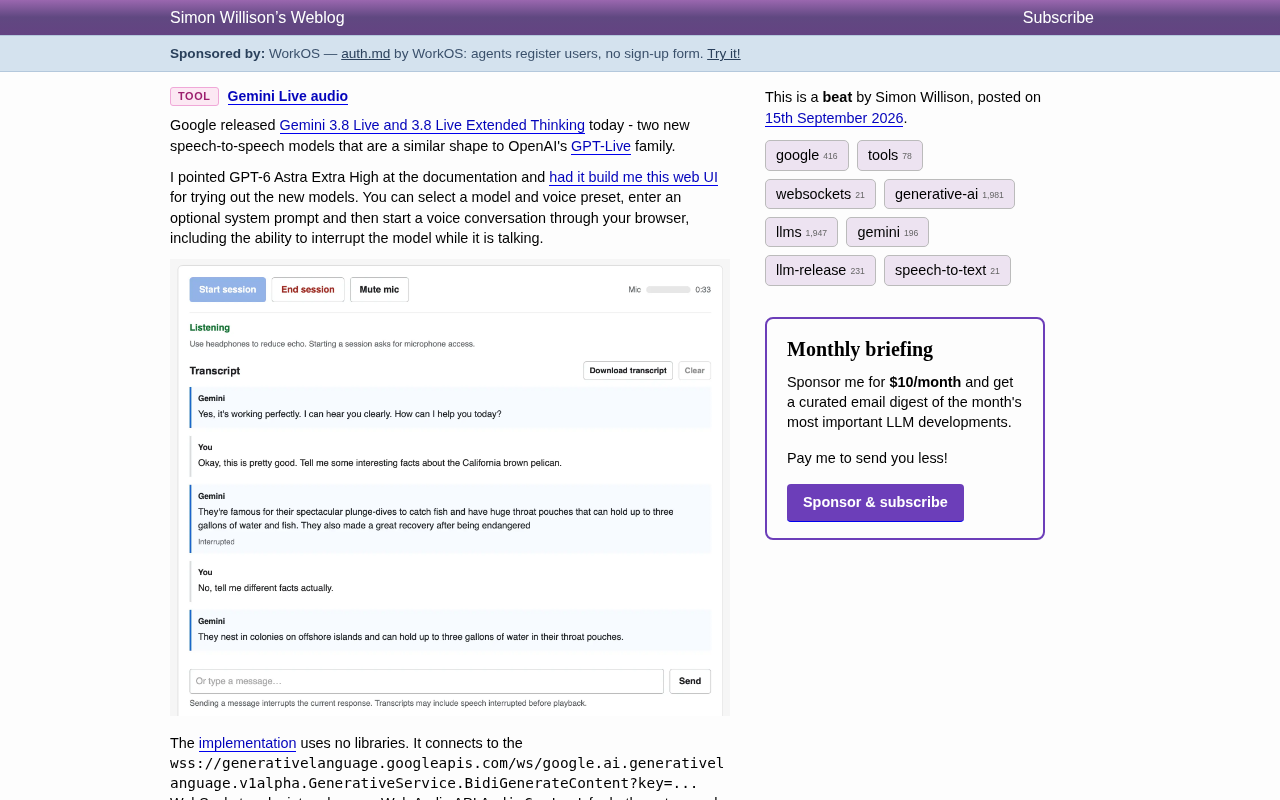
谷歌发布 Gemini 3.8 Live 语音对语音模型,开发者用零依赖浏览器界面验证其低延迟实时对话能力。
谷歌推出 Gemini 3.8 Live 与 3.8 Live Extended Thinking 两款端到端语音对语音模型,直接竞争 OpenAI GPT-Live 系列,标志着实时语音交互正成为主流大模型的标配能力。开发者 Simon Willison 借助 AI 编程快速生成了一个零第三方依赖的浏览器试用界面,该界面通过 WebSocket 直连 Gemini 的 BidiGenerateContent 双向流端点,配合浏览器原生 Web Audio API 实现音频采集与播放,支持模型切换、语音预设、系统提示词及对话实时打断等功能。实测表明接入门槛已大幅降低——一个纯 HTML 文件即可跑通完整的实时语音对话流程。Extended Thinking 版本适合深度推理场景,标准版则优先保证响应速度,两档分层与 OpenAI 的产品策略高度吻合。
谷歌今天发布了 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 两款全新的语音对语音(speech-to-speech)模型。从形态上看,它们与 OpenAI 的 GPT-Live 系列相当接近——都主打实时、低延迟的双向语音对话能力。这标志着实时语音交互赛道的竞争进一步升温。
开发者 Simon Willison 第一时间围绕这两款模型做了一次快速实测,并借助 AI 编程能力搭建了一个可以在浏览器里直接试用的网页界面。这篇文章基于他的实践,梳理 Gemini 3.8 Live 的能力表现与技术实现细节。
什么是 Gemini 3.8 Live
Gemini 3.8 Live 属于典型的语音对语音模型:你说话,模型直接以语音回应,中间无需经过“语音转文字—文本推理—文字转语音”的传统级联流程。这种端到端的设计能显著降低对话延迟,让交互体验更接近真人对话。
其中的 Extended Thinking 版本,顾名思义在语音回应前加入了更充分的“思考”过程,适合需要更复杂推理的场景,而标准版则更侧重响应速度。这与 OpenAI GPT-Live 家族的产品分层思路高度相似,反映出两大厂商在实时语音领域正走向类似的技术路线。
语音对语音(speech-to-speech)模型与传统语音助手的根本区别在于信号处理路径。传统方案通常是"ASR(自动语音识别)→ 文本 LLM → TTS(文本转语音)"三段式串联,每一段都会引入延迟并可能累积错误——例如 ASR 的误识别会直接影响后续推理质量。端到端语音模型则将音频特征直接输入统一的神经网络,输出也直接是音频流,省去了中间的文本转换环节。这不仅降低了往返延迟(通常可压缩到数百毫秒以内),还能让模型捕捉语调、停顿、语速等文本层面无法表达的副语言信息,从而做出更自然的回应。OpenAI 于 2024 年发布的 GPT-4o 语音模式是此类模型的早期标志性案例,Gemini 3.8 Live 的发布意味着这一技术路线正在快速普及。
一个零依赖的浏览器试用界面
Simon Willison 把模型文档丢给 GPT-6 Astra Extra High,让它帮忙生成了一个 Web UI。这个界面功能相当完整:可以选择模型、切换语音预设、填写可选的系统提示词(system prompt),然后直接通过浏览器开启语音对话,甚至支持在模型说话时打断它。
从截图可以看到实际的对话记录:用户询问“加州褐鹈鹕的有趣事实”,Gemini 回答它们以壮观的俯冲捕鱼著称、喉囊能容纳多达三加仑的水和鱼。当用户中途打断并要求“换一些不同的事实”时,模型能被标记为 Interrupted(已打断)并重新组织回答。界面还带有麦克风电平表、计时器、转录下载等实用功能,并贴心提示“建议使用耳机以减少回声”。
这种“打断即响应”的交互,正是语音对语音模型区别于传统语音助手的关键体验点——它更像自然对话,而非一问一答的机械交互。
技术实现:WebSocket + Web Audio API
值得关注的是这个界面的实现方式:完全不依赖任何第三方库。整个应用直接连接 Gemini 的 WebSocket 端点:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=...
音频的采集与播放则统一交给浏览器原生的 Web Audio API AudioContext 来处理。也就是说,一个纯 HTML 文件加上原生浏览器 API,就足以搭建起一个可用的实时语音对话客户端。
端点路径中的 BidiGenerateContent(双向生成内容)清楚地表明了这条链路的本质:客户端与模型之间建立一条持续的双向流,音频数据在两端实时来回传输。对于想要接入这套能力的开发者来说,谷歌官方也提供了 Gemini Live WebSocket 教程 作为起步参考。
WebSocket 是 HTTP 协议的升级变体,通过一次握手建立持久的全双工 TCP 连接,此后客户端与服务器可以在同一连接上随时互相推送数据,无需反复发起请求。这与传统 HTTP 的"请求-响应"模式形成鲜明对比,后者每次交互都需要新建连接,不适合持续流式传输音频帧。BidiGenerateContent(Bidirectional Generate Content)即"双向生成内容",端点命名直接揭示了其工作方式:麦克风音频帧持续上行,模型生成的语音帧同步下行,两条流并行运行。浏览器端的 Web Audio API AudioContext 则负责以底层 PCM 格式采集麦克风输入并实时播放接收到的音频缓冲区,整个过程无需 Flash 或任何原生插件,是现代浏览器的标准能力。两者结合,使得一个纯静态 HTML 文件就能完成过去需要桌面应用才能实现的实时双向语音通信。
对开发者意味着什么
这次实测传递出两个信号。其一,实时语音正在成为主流大模型的标配能力,谷歌与 OpenAI 的产品形态趋同,说明市场对低延迟语音交互的需求已经相当明确。其二,接入门槛正在降低——无需复杂的 SDK 或臃肿的依赖,靠 WebSocket 和浏览器原生音频 API 就能跑通完整流程。
对于希望在自己产品中集成语音对话的团队而言,Gemini 3.8 Live 提供了一个值得评估的新选项。而 Extended Thinking 与标准版的分层,也让开发者可以根据“响应速度”与“推理深度”之间的权衡来选择合适的模型。
相关推荐
DeepSeek本地部署实战:Ollama+API调用完整教程
手把手教你用Ollama在本地或云服务器部署DeepSeek大模型,涵盖硬件配置选型、模型下载命令,以及Ollama官方库、requests、OpenAI兼容接口三种API调用方式,小白也能轻松上手。
AI+逆向接单实战:40分钟破解点选验证码赚800元
一位B站UP主分享AI+逆向接单实战案例:40分钟破解点选验证码赚800元。文章拆解抓包分析、AES加密定位、OCR坐标识别到AI自动化调用的完整流程,揭示AI编程结合逆向工程的兼职新趋势。
Krea 2角色LoRA训练全流程:从数据集到epoch优选实战
一位开发者公开了Krea 2角色LoRA的完整训练工作流,涵盖数据集收集与筛选、Fizgig/RunPod参数配置、epoch优选、LoRA强度测试和标准化验证,模型库已从18个扩充到70个且全部免费。