Gemini 4 Argon深度解析:免费还是付费?开发者如何上手

Gemini 4 Argon 主打超长上下文与复杂工程,但不免费,综合第一非纯代码第一。
Gemini 4 Argon 是谷歌当前最强的前沿模型,面向长周期、高复杂度的软件工程与企业级任务,核心卖点是超长上下文窗口和低中高三档思考等级。它不提供免费额度,只能通过付费 Pro 订阅或按量付费 API 使用,且免费层数据会被用于产品改进。API 定价分促销价与正式价两阶段,正式价涨幅明显,但批量推理通道折扣极大,适合重复性任务摊薄成本。在 Vals AI 综合指数上以 68.9% 位列第一,但该指数混合金融、法律与文本任务,并非纯编程排名;终端编码智能体形态目前更适合测试,生产环境仍建议沿用成熟工具。
谷歌新一代前沿模型 Gemini 4 Argon 发布后引发大量讨论,但开发者最关心的三个问题始终没变:它免费吗?写代码该怎么用?和 Claude、GPT 相比到底强在哪?本文结合独立测评数据与官方定价信息,给出一个不带滤镜的判断。
定位:谷歌最强前沿模型,主打长上下文与复杂工程
按照谷歌官方说法,Gemini 4 Argon 属于前沿(Frontier)级别模型,即谷歌当前体量最大、能力最强的一档,面向的是长周期、高复杂度的任务:真实软件工程、大规模代码迁移、企业级工作负载,以及安全相关的代码审查。
它最突出的能力是超长上下文窗口,可以一次性吞下体量极大的代码库或长文档。默认情况下,单次输出也能给出相当可观的 token 量。输入侧支持文本、图像、视频与 PDF,输出目前仅支持文本。
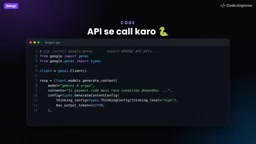
模型内置三档思考等级——低、中、高。简单函数用小档位即可,复杂重构或跨文件推理则建议直接拉到中高等级。需要提醒的是,模型在"思考"阶段本身也会消耗 token,配置最大输出时必须留足余量,否则容易出现答案被截断的情况。
上下文窗口指模型单次推理能接收的 token 总量,包含输入提示与历史对话。早期模型的窗口通常只有几千 token,处理一个中等规模文件便需要切分;而前沿模型的窗口已扩展到数十万甚至百万级,可以把整个代码仓库、技术文档或长篇合同一次性放进同一次请求。窗口越大,模型越能在全局范围内建立跨文件、跨章节的引用关系,这也是长周期工程任务(如整库迁移、遗留系统理解)能够成立的前提。不过窗口大并不等于有效利用,模型在超长输入中仍可能出现中段信息遗漏,实际使用时建议把关键约束放在输入的开头和结尾,并对超长材料做结构化分段。
免费吗?答案是明确的否定
很多人的第一反应是:Gemini 网页版不是有免费入口吗?但根据谷歌官方文档的说明,Argon 并不在免费层开放,普通免费版 Gemini 也用不到它。想直接调用,需要走付费的 Pro 订阅,或者使用面向开发者的按量付费 API。
另一个入口是谷歌的编码智能体产品(桌面应用与终端 CLI 形态),目前对个人用户开放于较高档位的订阅计划中。换句话说,想低成本试水,官方并没有留下太多空隙。
值得单独提醒的是免费层的隐性成本:在免费额度下产生的数据,谷歌会用于改进自家产品。换句话说,你省下的是钱,付出的是数据。对于涉及商业代码或敏感信息的场景,这一点比价格本身更值得权衡。
按量付费 API 与订阅制是两种不同的计费逻辑。订阅制按月收取固定费用,换取一定额度或功能权限;按量付费则按实际消耗的 token 数计费,输入与输出通常分开定价,输出单价一般高于输入。对开发者而言,按量付费的好处是成本与用量直接挂钩,小规模试验时花费可控;风险在于缺乏天然上限,一旦思考等级调高或陷入重试循环,账单可能在短时间内迅速膨胀。因此生产环境接入时,通常需要在网关层设置每日预算、单次请求 token 上限与告警阈值,把不可控的变量提前锁死。
定价结构:短期促销价与正式价差距明显
按量付费 API 的定价分为两个阶段。在促销期内,输入与输出都处于明显更低的价位;促销结束后价格会回到正式水平,涨幅相当可观。这意味着如果打算长期依赖它跑批量任务,成本模型需要按正式价来算,而不是按眼下的优惠价。
有一个细节容易被忽略:官方对批量推理给出了极高的折扣力度,幅度接近九折以上。对于需要反复跑同一份代码库的场景,通过批处理通道提交能显著摊薄成本。
另一个实用建议是把预算上限设好。按量付费最怕的不是单价高,而是失控——尤其是思考等级调高后,单次请求的 token 消耗会成倍上升。
真实水平:独立测评第一,但优势并不全面
关于"比 Claude 和 GPT 更好吗"这个问题,独立测评给出的答案是有条件的。在 Vals AI 的综合指数上,Gemini 4 Argon 拿到了第一,得分 68.9%。但需要看清这个指数的构成:它并不只测代码,还混合了金融、法律和文本类任务。也就是说,这是一个综合能力榜,而不是纯粹的编程能力榜。
对开发者的实际含义是:如果你做的是纯代码生成或大型仓库重构,Argon 的长上下文优势很明显;但如果你的工作流高度依赖终端里的编码智能体,目前 Claude 在这块的成熟度仍被不少开发者认为更稳妥,Argon 相关的终端智能体形态更适合测试验证,生产环境使用还需谨慎。
Vals AI 是一家对基础模型做独立评测的机构,其指数把多个领域的任务(代码、金融、法律、文本理解等)按权重汇总成单一分数,用于横向比较模型的综合能力。这类综合榜的价值在于覆盖面广、口径统一,局限则在于分数会被任务构成稀释:一个在代码上明显领先的模型,如果金融或法律项稍弱,综合分未必拉开差距;反之亦然。阅读此类榜单时应关注分项得分与任务分布,而不是只看总排名。对开发者来说,更可靠的做法是用自己业务中的真实样本构建小型评测集,再结合公开榜单做交叉判断。
怎么选:三类开发者的不同路径
独立开发者或小团队:如果只是偶尔写写脚本、做原型验证,优先考虑按量付费 API 并设好预算上限,不要一上来就订阅高档位方案。
维护大型代码库的团队:Argon 的超长上下文是核心卖点,适合整库理解、跨文件迁移和遗留系统改造。建议用批量通道处理重复性任务,把成本压下来。
需要终端编码智能体的团队:现阶段可以把它当作补充方案做测试,生产主链路继续留在已经验证过的工具上,等官方把智能体形态打磨成熟再迁移。
结论
Gemini 4 Argon 是谷歌目前最强的模型,长上下文和复杂工程任务是它的主场,但它不免费,正式价也不便宜。独立测评的综合第一值得参考,但要分清那是跨领域综合分而非纯代码分。对多数开发者而言,更理性的做法是:把它当作处理超长上下文任务的专用工具,而不是全盘替换现有工作流。
你更看重长上下文能力,还是终端智能体的成熟度?这决定了 Argon 现在值不值得进入你的工具箱。
相关推荐

Reddit帖子被删引发AI内容审核争议
Reddit一则帖子被平台以违反内容政策为由删除,页面仅显示移除提示。事件折射出AI内容审核系统在透明度、误判风险和申诉机制方面的普遍困境,值得内容平台与创作者关注。

DSH+Ollama本地部署大模型实战:免费对话大肥鱼
B站UP主实测DSH+Ollama本地部署大模型全流程:从Ollama安装、迅雷加速下载、魔搭GGUF模型导入,到DSH自定义API地址配置,并对比千问3.5 4B、8B、Gemma等模型在8G显存下的表现,给出本地部署与API调用的选择建议。

899元Mac Mini实测:能替代200美元AI订阅吗?
实测M4 Mac mini能否替代200美元AI订阅:16GB内存装不下大模型,速度与质量均有差距,但隐私、无上限和近零运行成本让它成为常驻智能体的理想宿主。附各配置选购建议与省钱策略。