Gemini Robotics 2.5 发布:成功率最高提升100%的机器人VLA模型

DeepMind 发布最强 VLA 模型 Gemini Robotics 2.5,成功率最高翻倍并在奔驰工厂试点达 96%。
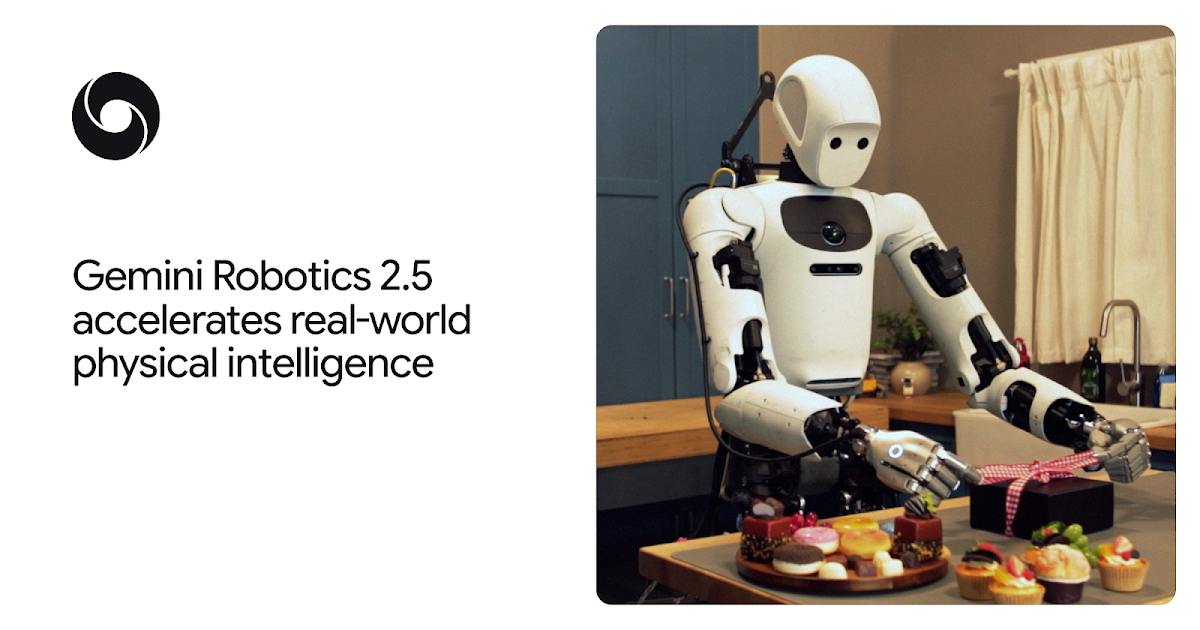
Google DeepMind 在 Product Hunt 发布 Gemini Robotics 2.5,称其为迄今最强的视觉-语言-动作(VLA)模型,可将视觉与语言输入转化为机器人手和手臂的动作。相比上一代,任务成功率提升 30% 至 100%,完成速度加快 20% 至 30%。在工业验证方面,搭载于 Apptronik Apollo 2 人形机器人的该模型在梅赛德斯-奔驰零件配套试点中达到 96% 任务成功率。模型支持跨机器人形态工作,正逐步向机器人合作伙伴开放而非全面公开。Product Hunt 上线获 75 票、当日排名第 7,受众覆盖 AI 研究者与开发者社区,后续合作伙伴名单与接入方式仍待官方披露。
Google DeepMind 在 Product Hunt 发布了 Gemini Robotics 2.5,官方称这是其迄今能力最强的视觉-语言-动作(VLA)模型。它把机器人看到和听到的内容转化为手和手臂的动作,并且首次把「跨机器人形态」和「工业级试点验证」同时摆上了台面。
从「看懂」到「动手」:VLA 模型到底在解决什么
VLA 模型的核心命题是让机器人理解自然语言指令,并结合视觉输入生成可执行的动作序列。传统机器人依赖预编程的固定轨迹,换一个工位或换一种零件就要重新调试。Gemini Robotics 2.5 试图把这种适配成本压下来——同一套模型权重可以迁移到不同类型的机器人本体上。
据 DeepMind 公布的数据,Gemini Robotics 2.5 相比上一代基线模型,任务成功率提升了 30% 到 100%,完成速度加快了 20% 到 30%。成功率区间的上界翻倍,意味着在部分此前容易失败的场景中,模型的表现有了质的变化,而不只是小幅迭代。
视觉-语言-动作(VLA)模型是近年来具身智能领域的核心范式,其思想源头可追溯到视觉-语言模型(VLM)。VLM 通常以图像和文本为输入、输出文本描述或问答;VLA 在此基础上增加「动作」这一输出模态,把感知与语言理解直接映射为机器人可执行的关节角、末端位姿或动作 token 序列。
与传统的「感知—规划—控制」分层流水线相比,VLA 倾向于端到端训练:大规模机器人示教数据与互联网视觉语言数据共同预训练,使模型具备一定的语义泛化和指令跟随能力。代表性工作包括 RT-2、OpenVLA 以及 DeepMind 自家的 RT-X 系列。VLA 的主要挑战在于动作空间的高维连续性与不同机器人本体之间的异构性,这也是「跨形态」成为该赛道关键指标的背景。
奔驰工厂试点:96% 成功率意味着什么
最有说服力的验证来自工业场景。DeepMind 披露,Gemini Robotics 2.5 在与 Apptronik 合作的 Apollo 2 人形机器人上,于梅赛德斯-奔驰的零件配套(parts-kitting)试点中达到了 96% 的任务成功率。
零件配套是典型的「高频、重复、容错率低」工序:机器人需要从料箱中识别并抓取正确零件,放到指定位置。96% 的成功率已经接近可部署的门槛,但距离完全无人化仍有差距——剩余的失败样本如何处理,往往决定了实际产线的综合效率。
| 指标 | Gemini Robotics 2.5 表现 |
|---|---|
| 成功率 vs 上一代 | 提升 30% – 100% |
| 任务完成速度 | 加快 20% – 30% |
| 奔驰试点成功率 | 96% |
**零件配套(parts-kitting)**是制造业物流环节中的一道工序:按照工单从仓储料箱中拣选出一组正确的零部件,装入配套容器后送往装配线。它的难点在于零件品类多、外观相近、摆放姿态随机,且错拣或漏拣会直接导致下游装配停线。
正因如此,该工序长期依赖人工或高度定制的自动化设备。引入人形机器人做零件配套,考验的不仅是抓取精度,还包括对料箱内遮挡、堆叠的视觉推理能力。96% 的单次成功率在学术基准上已属较高水平,但工业部署通常还要求更低的故障率与可预测的失败恢复机制,这也是该试点被视为「接近门槛」而非「已达门槛」的原因。
跨机器人形态:通用性的真正门槛
DeepMind 强调 Gemini Robotics 2.5 可「跨机器人类型工作」。这句话的分量在于:不同机器人的关节数量、运动学约束、传感器配置差异巨大,一套 VLA 模型要在多种本体上保持可用,需要在动作表示层面做抽象,而不是针对单一硬件过拟合。
从产品节奏看,该模型正在向机器人合作伙伴逐步开放(rolling out to robotics partners),并非全面公开可用。这种「先合作、后开放」的路径在机器人领域并不罕见——真实硬件数据本身就是稀缺资源,早期合作方往往承担了数据飞轮的启动角色。
**跨机器人形态(cross-embodiment)**指同一个策略模型能够驱动结构不同的机器人,例如轮式机械臂、四足机器人和人形机器人。不同本体的自由度数量、关节限位、连杆长度与传感器布局各不相同,直接复用原始动作输出几乎不可行。
主流做法是在动作表示层面做统一,例如把动作抽象为末端执行器的六自由度位姿增量,或采用离散化的动作 token,使模型学习「做什么」而非「每个关节转多少度」。跨形态能力的价值在于数据复用:来自多种机器人的示教数据可以汇入同一训练集,缓解单一硬件数据稀缺的问题。它也是衡量 VLA 模型能否从实验室走向通用机器人平台的关键标尺。
发布信号与行业位置
Gemini Robotics 2.5 在 Product Hunt 上线后获得 75 票支持,排名当日第 7,分类标签覆盖人工智能、GitHub 与 YouTube——这说明它的受众不只是机器人研究者,也包括关注开源生态与开发者工具的群体。
从竞争格局看,VLA 模型正成为具身智能的主战场。Gemini Robotics 2.5 的差异化不在于单项指标,而在于「性能提升 + 工业试点 + 跨形态」三件事同时成立。对开发者而言,值得关注的后续信息是:合作伙伴名单、模型接入方式,以及是否会有面向开发者的 API 或开源权重放出。
现阶段 Product Hunt 页面仅提供官网跳转,评论互动很少,更多细节仍待 DeepMind 官方技术博客补充。
相关推荐

Claude Code 推出 Code Mode:用一段代码批量调用工具
Claude Code 在 v2.1.323 中推出实验性 Code Mode:模型写一段 JavaScript 批量调用工具,减少往返推理与上下文开销。本文梳理其原理、适用场景、安全审查粒度、已知限制与开启方式,并对比 Codex、OpenCode 等同类实现。

开源AI提权工具实测:动动嘴就能拿临时Root?
B站开源项目演示用AI自动完成Android临时Root提权:接入主流大模型、按提示配对ADB,剩下全交给AI。本文拆解其操作流程、技术逻辑与安全风险,并分析AI Agent吃掉极客操作的趋势。
DeepSeek官方App能力拆成全家桶API,还开源前端Demo
DeepSeek 将官方 App 的联网搜索、网页抓取、文档图像解析、语音合成与识别拆成独立 API 开放,并提供对话集成与可导入历史记录的开源前端。搜索抓取每千次5元、文件解析千页1.5元、语音限时5折,对外须开安全校验与AI标识。