GitHub Copilot Fusion对决Claude Code:路由与自选的路线之争

GitHub Fusion Max以路由编排逼近Claude Code分数,但控制权与成本结构截然不同。
GitHub宣称Copilot Fusion Max在编码代理基准上得分60,与Claude Code仅差两分,且每任务API成本约为后者一半。但Fusion本质是路由器而非模型,通过单模型、Cascade、Critique三种协作模式自动调度底层模型,用户只选努力档位;Claude Code则把模型选择权交给用户。两者产品哲学相反:前者是托管服务思路,降低决策负担;后者是专业工具思路,强调可预测性。计费上Fusion按各模型标准费率计费,高强度档位可能抵消路由节省;Claude Code从订阅额度扣除,边界清晰但可能撞上限。此外,Fusion丢弃草稿时文件修改不会回滚,提交前需人工检查。两分差距成立,但不代表能力等同。
GitHub最近抛出一个颇具挑衅性的说法:Copilot Fusion Max在Artificial Analysis Coding Agent Index上得分60,与Claude Code的差距仅在两分之内,而平均每任务的API成本大约只有后者的一半。数字本身很抓眼球,但把两分差距直接读成"打平",会错过一个更本质的问题——Fusion压根不是模型,它是路由器。
Fusion不是模型,是编排层
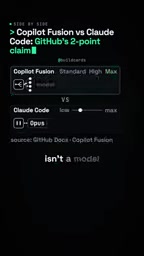
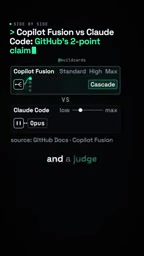
GitHub对Fusion的定义很明确:针对每个提示词,它自行挑选模型以及模型之间的协作方式,用户不直接接触底层模型。目前披露的协作模式有三种。单模型模式,由一个模型从头做到尾;Cascade模式,先让一个高效模型起草,再由一个"裁判"决定接受还是升级到更强的模型;Critique模式,让其他模型审查初稿,原模型据此修订。
这个设计的含义是,Fusion的60分不是某一个模型的成绩,而是一套调度策略的成绩。它更接近"用便宜的模型干大部分活,只在关键处动用贵模型"的工程优化,而不是在模型能力上追平Claude Code。宣传口径里的"两分之内",比较的是一套编排系统和一款具体产品,维度并不完全对等。
值得肯定的是成本侧的表现。按素材给出的口径,Fusion Max在拿到60分的同时,平均每任务API成本约为对手的一半,这在规模化使用编码代理时是实打实的差异。
Artificial Analysis Coding Agent Index 是一个专门评估编码代理(coding agent)综合表现的第三方基准。与传统的代码生成基准(如HumanEval)只测单轮函数补全不同,它更关注代理在真实任务中的端到端能力:理解需求、多文件编辑、运行测试、迭代修复等。评分通常综合任务完成率、代码正确性与效率,满分100。因此分数反映的是“代理系统”而非“裸模型”的能力,这也解释了为什么一个路由系统能与具体产品放在同一张表上比较——但需注意,基准任务分布、评分权重和是否允许人工介入等细节,会显著影响分数的可比性。
控制权在谁手里
两者的产品哲学正好相反。Fusion里,你只选"努力程度"——standard、high、max三档,模型由系统决定。Claude Code则把选择权交回用户:通过/model指定Opus或Sonnet,再单独设定从low到max的努力等级。
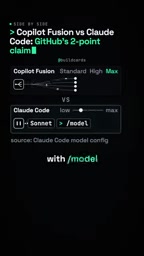
这不是细节差异。对需要可预测行为、需要针对特定任务反复调优的开发者来说,能指定模型意味着可以把不确定性压到最低;而对不想研究模型差异、只想拿到结果的用户,Fusion的自动路由降低了决策负担。前者是专业工具的思路,后者是托管服务的思路。
模型路由(model routing) 是一种在推理时根据输入动态选择底层模型的调度技术。常见策略包括:按任务难度分档(简单任务用便宜小模型,复杂任务升级到大模型)、按领域专长分派(代码、数学、写作各用其长)、以及级联(cascade)——先由低成本模型尝试,失败或置信度不足时再升级。路由的核心价值是用混合成本逼近单一强模型的平均质量,但代价是行为可预测性下降:同一提示词可能因路由决策不同而得到不同结果。对开发者而言,路由系统是黑盒,调试和复现问题的难度高于固定模型。
计费方式的隐性成本
计费结构直接影响长期开销。Fusion对每个实际调用的模型按其标准费率计费,因此high和max档可能消耗更多credits——路由省下的钱,在高强度档位上会被部分抵消。素材提到付费Copilot计划在11月30日前可享Fusion模型成本30%的折扣,这属于限时优惠,不适合作为长期成本基准。
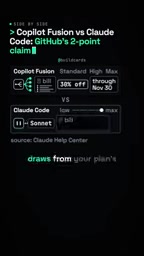
Claude Code走的是订阅额度路线,在Claude计划内从套餐的用量上限中扣除,成本边界更清晰,但重度使用时可能先撞上额度天花板。两种模式没有绝对优劣,取决于使用强度和对成本可预测性的偏好。
API 按 token 计费 vs. 订阅额度制 是两种根本不同的成本模型。按 token 计费(Fusion 采用)意味着每次调用按输入/输出 token 数乘以对应模型单价结算,成本随使用量线性增长,但边界透明、可精确核算;高强度档位因调用更贵的模型而单价上升。订阅额度制(Claude Code 采用)则是预付固定月费换取一定用量上限,超出后限流或降级,成本可预测但存在“用不满浪费、用超了撞墙”的问题。选择时需评估使用强度的方差:波动大的团队更适合按量计费,稳定高强度的团队订阅制更划算。
一个必须知道的操作风险
素材里最容易被忽略但最该记住的一条:如果Fusion丢弃了某个草稿,该草稿已经产生的文件修改不会自动回滚。这意味着自动路由在后台试错时,工作区可能留下半成品改动。提交前人工review是必要步骤,尤其在Cascade和Critique这类多轮协作模式下。这类"编排带来的副作用",是评估代理工具时容易漏掉的成本项。
怎么选
两分差距的说法成立,但它衡量的是一套路由系统在特定基准上的表现,不代表能力等同。需要精细控制模型与行为的场景,Claude Code的显式选择更合适;希望把模型选择外包、同时压住平均成本,Fusion的自动编排有吸引力。真正要盯住的,是折扣到期后的实际账单,以及被丢弃草稿留下的文件改动。
(本文基于单一视频来源的转述,GitHub的基准数据与折扣细节建议以官方文档核实。)
相关推荐

9家AI订阅套餐积分换算:每亿Token真实成本揭秘
B站UP主实测火山、阿里、腾讯、百度、智谱、小米、MiniMax等9家AI订阅套餐,统一换算每亿Token真实成本,拆解固定额度与三档系数两类计费逻辑,揭示缓存、时段折扣和窗口限额对实际额度的影响。

Vibe Coding入门:用意图表达代替手写代码
Vibe Coding 是什么?B站137集实战课程给出定义:核心不是写代码而是表达意图。本文解析 Vibe Coding 的生产力逻辑、适合人群与入门预期,帮助零基础者判断是否值得投入学习。
LangChain入门指南:从LangGraph到Deep Agents的智能体开发路线
理清LangChain、LangGraph和Deep Agents的封装关系,掌握智能体开发框架的学习路线与选型逻辑,适合大模型开发入门者参考。