GitHub爆火8款AI编程神器:补齐Agent能力短板

八款开源工具补齐AI编程Agent在验证、规划、token效率和设计规范上的短板
AI编程Agent能生成大量代码,但在结果验证、决策规划、token效率和设计规范等方面仍存在明显不足。本文梳理了八款针对这些痛点的开源工具:Image to 3JS将图片转化为可交互的代码驱动3D模型;Reticle自动验证Agent构建的应用是否真正可用,解决「假完成」问题;Chisel压缩冗余回复,实测可将同一任务的token消耗从约1500降至600;UISkills和SwiftUI Skills分别解决设计技能选择难题和iOS原生界面还原问题;Ouroboros让Agent构建前厘清需求并计划,构建后独立检验;Caliper测试自建skill的实际效用;Antislop则自动清除代码中的糟糕模式。这些工具的共同逻辑是用外部约束来弥补模型本身的局限,而非等待模型自身进化。
AI编程Agent已经能构建你要求的大部分功能,但仍有很多事情它无法独立完成。开发者社区为此打造了一批工具来填补这些空白。国外知名频道AI Labs梳理了八款真正经得起考验的开源项目,其中两款已在GitHub上登上趋势榜。这些工具从3D建模、结果验证到token优化,覆盖了Agent工作流的多个痛点。本文逐一拆解它们的作用与使用方式。
让图片变成可交互3D模型:Image to 3JS
你在网上看到的那些可滚动、带动画的产品落地页,很多都用到了3D模型。Image to 3JS 正是解决这个需求的工具,也是当前GitHub趋势榜上的热门项目。
它的核心思路是:把图片中的物体转化为完全由代码生成的3D模型。因为模型是代码构建的,Agent可以随意调整——改颜色、调整光照、添加动画,都无需你亲自操作复杂的3D建模软件。
使用方式很简单:把你想复现的图片交给Agent,并要求它调用Image to 3JS。Agent会分阶段构建物体,每构建一步就将模型与原图对比,发现差异先修正再继续添加细节。
需要提醒的是,这个流程会消耗大量token,耗时也较长。首次生成的模型可能达不到理想精度,但你可以持续要求Agent改进特定部分,逐步逼近产品演示中的细节水平。
验证Agent是否真的完成任务:Reticle
Agent一个老毛病是:明明任务没做完,却标记为「已完成」。它们通常只检查应用能否正常加载、设计是否落地,但背后仍有很多可能失败的环节。要抓住这些问题,唯一的办法是让Agent获得对浏览器中实际运行状况的更多访问权限。
Reticle 就是为此而生。当Agent声称应用已完成后,这个工具会检查应用是否真的按预期工作。它让Agent能够跟踪应用运行时内部发生的一切,从而定位问题所在。
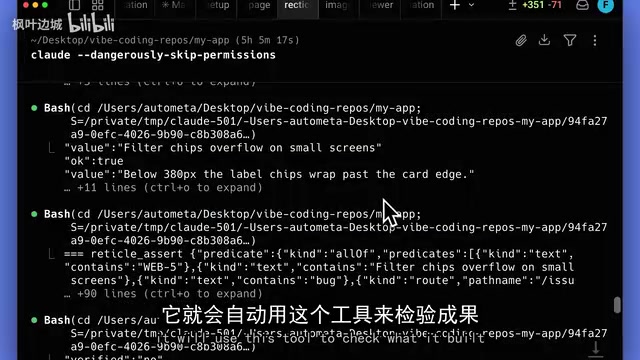
安装后,无论你是否在提示词中提及,Agent每次构建应用都会自动调用它。工具会像真实用户一样打开并操作应用,最终对测试的每个部分给出三种结论之一:成功、失败、或信息不足无法判断。
当某部分失败时,Reticle会解释出错原因,让Agent修复后重试。你自己打开应用时,角落会出现一个可交互的弹窗,还能回看历史检查记录,了解问题是如何被修复的。
压缩冗长回复,节省token:Chisel
最近大模型的回复越来越长,尤其是工作结束时的总结,Claude系列模型表现尤为明显。这些解释有些甚至因为结构混乱而毫无帮助,让人难以理解Agent到底想表达什么。
Chisel 的作用是让Agent用更少的词,避免编写任务不需要的代码,从而减少浪费在冗余解释和代码上的token。

作者公布了测试数据:在修改搜索框功能的例子中,不用Chisel时Agent回答消耗约1500 token,用了Chisel后同样任务只用约600 token。他还对比了Caveman、Ponytail等类似工具,Chisel整体消耗更少。
它作为Claude Code的插件安装,会附带四项skill和三个hook(hook是在会话特定节点自动运行的命令)——分别在会话开始时、你发送提示时、以及Agent使用工具后运行。对Claude Code用户还有额外好处:Chisel会在Agent读取工具返回信息前,删除重复或不必要的文本,防止上下文被无用内容填满。
Token是大语言模型处理文本的基本计量单位,大致可理解为词语或子词片段——英文中一个单词约等于1-2个token,中文一个汉字约等于1-2个token。Token消耗直接决定API调用费用与速度,也决定了模型在单次对话中能记住多少上下文。当Agent会话中积累了大量冗余解释、重复代码和无用的工具返回信息,上下文窗口会被快速填满,导致模型「忘记」早期的关键信息,同时推高使用成本。Hook是在特定事件触发时自动执行的脚本或命令,类似于流水线上的检查站——无需人工干预,每当满足预设条件(如会话开始、用户发送消息、工具调用完成)就自动运行。Chisel利用hook机制在信息流入模型前完成过滤,而非事后补救,因此能更彻底地减少无效token占用。
智能匹配设计技能:UISkills
市面上有大量提升设计的skill,每个都自带一套设计原则。但正因为数量太多,选择哪个最合适反而成了难题。
UISkills 是一个汇集不同作者设计skill的库。它让Agent自行搜索,并挑出最符合你需求的那个。工具同时提供MCP和终端两种运行方式。视频作者推荐MCP方式,因为其工具会在整个Agent会话中保持可用;终端方式则需要你主动告知Agent何时调用。
连接MCP后,它会出现在Agent的MCP工具列表中。你只需要求Agent为想做的设计调用UISkills,Agent会先在库中搜索匹配的skill,再缩小到相关项并获取使用说明。这样你就无需在开始前自己逐个挑选和安装设计skill。
**MCP(Model Context Protocol)**是Anthropic于2024年底提出的开放协议,旨在标准化大语言模型与外部工具、数据源之间的连接方式。你可以把它理解为AI领域的「USB接口」:工具开发者只需按照MCP规范暴露接口,任何兼容MCP的模型或Agent就能直接调用,无需为每个模型单独适配。相比在终端手动调用工具,MCP的优势在于工具会在整个会话周期内持续可用,Agent可以随时按需调用,而不必依赖用户在提示词中明确提醒。目前Claude、Cursor等主流AI编程工具均已支持MCP,这也是本文中多款工具优先提供MCP接入方式的原因。
先想清楚再动手:Ouroboros
如果你没有明确说明应用该如何工作,Agent会替你擅自决定这些细节。Ouroboros 帮助Agent在构建前先厘清这些细节,构建后再检查并把问题反馈给Agent修复。
设置完成后,你描述想构建的应用并要求使用Ouroboros。它会先进行「自我访谈」:生成关于你需求的问题,再基于你已描述的内容和项目现状来回答。只有当某个选择日后易于修改、且不偏离你的要求时,它才会自行填补小的缺失细节;一旦某个决策可能改变应用的本质,它就会暂停并询问你,同时记录所有假设。
这些答案汇成一份描述成品功能的计划。构建前Ouroboros会审查计划并解决发现的问题,只有计划通过后Agent才开始构建。构建完成后再检查应用是否符合计划——你可能没注意到,Agent的构建指令中从不包含这些检查如何运行、预期什么结果,保证了验证的独立性。若发现问题,它会让Agent修复并重新检查,确保改动没有破坏已有功能。
更多专项工具:SwiftUI Skills、Caliper与Antislop
针对iPhone应用,设计类skill相对稀缺。让Agent做iOS界面时,它会试图用模糊和背景来模仿苹果的「液态玻璃」(liquid glass)风格,结果往往只是个半透明按钮,且跟不上苹果的功能更新。
Swift UI Skills 提供了用苹果原生系统SwiftUI正确构建界面的指令,并持续跟进苹果最新变化。仓库含两个skill:一个讲解如何使用iOS 26内置的按钮和菜单及规避常见错误,另一个针对新发布的iPhone Duo宽屏尺寸如何排布内容。
当你创建了大量skill后,很难判断哪些还在真正帮助Agent。模型更新后这一问题更突出——新模型可能已内建了某个skill的能力,导致该skill白白增加token成本。

Caliper 就是用来测试你创建的skill是否名副其实、是否真的对工作流有影响。它能对比使用与不使用skill时Agent的表现。仓库附带两个辅助工具:GrillSkill会就skill应达成的目标访谈你,让测试贴合意图;EvaluateSkill帮Agent创建并运行这些测试(称为eval)。Caliper还能对MCP服务器等其他配置做同样对比。
最后是 Antislop,专门清除Agent写代码时惯用的糟糕模式。它依据作者编写的一套规则检查代码,发现问题就报告给Agent修正,无需你亲自读代码。你既可以让它在每次任务时自动运行检查,也可以在完成工作后要求它做一次最终审查。
**液态玻璃(Liquid Glass)**是苹果在2025年WWDC上随iOS 26/macOS Tahoe发布的全新设计语言,以动态折射、实时模糊和材质感知透明为核心视觉特征,取代了延续多年的扁平化风格。这一效果高度依赖苹果的私有图形框架,需要使用特定的SwiftUI原生组件才能正确渲染;若开发者试图用通用的模糊滤镜或半透明背景来「模拟」,不仅视觉效果偏差明显,还会在不同设备和系统版本上出现兼容性问题。这正是文章提到AI Agent在处理iOS界面时的典型困境——它缺乏对苹果最新API变化的实时感知,只能退而求其次地用近似手段替代,而SwiftUI Skills通过持续跟踪苹果官方文档来弥补这一滞后性。
写在最后
这八款工具的共同逻辑,是承认当前AI编程Agent的局限——它们能生成代码,但在结果验证、决策规划、token效率和设计规范上仍需外部约束。与其等待模型本身进化,不如用这些专项工具补齐工作流的缺口。对于重度使用Claude Code等Agent的开发者,Reticle和Ouroboros解决的「假完成」问题,以及Chisel的token优化,可能是最具实用价值的三项。
相关推荐

MiniMax H3开源工作流:低显存也能打造呼吸感皮肤
本文介绍B站UP主分享的MiniMax H3双采样工作流,通过融合模型、破线LoRA和低显存节点,解决AI人物面部油腻问题,并让12G显存设备也能运行。包含模型搭配、双采样逻辑与参数设置详解。

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。

12GB显卡跑125B MoE?Strata三级协同引擎解析
开源C++引擎Strata让12GB-16GB家用显卡本地跑125B MoE模型,生成速度达40-95 Token/s。本文拆解其显存、内存、固态三级协同原理,说明模型选型前提、硬件配置门槛与启动方式。