GLiNER 开源模型工作原理:Jev AI 的替代方案

GLiNER 以标签即输入和双向编码器实现高效零样本实体抽取,是闭源方案的开源替代。
GLiNER 是一个开源信息抽取模型家族,其核心创新在于把标签直接作为输入文本的一部分与待分析文本联合编码,使模型无需针对每个新实体类别重新训练,只需在推理时提供标签列表即可完成零样本或少样本抽取。家族成员均采用双向 Transformer 编码器架构,不含自回归头,因此推理更快、资源占用更低,在结构化抽取任务上参数效率高于自回归大模型。GLiNER 2.5 在保留原始 NER 能力的同时扩展了更多任务,并共享同一套联合编码接口以降低多任务部署复杂度。它适合合同、简历、文献等自定义字段抽取场景,但不具备自由文本生成能力,可作为 Jev AI 等闭源方案的开源可自托管替代。
在信息抽取领域,命名实体识别(NER)长期依赖大语言模型或专用分类器,但一个名为 GLiNER 的开源模型家族提供了截然不同的思路。据 YouTube 技术频道分析,GLiNER 不仅延续了原始 NER 任务,还扩展出更灵活的能力,成为 Jev AI 等闭源方案的有力替代。
GLiNER 的核心设计:标签即输入
GLiNER 的名字源自 Generalist 与 Named Entity Recognition 的结合。与传统的序列标注模型不同,GLiNER 将标签(labels)直接作为输入文本的一部分,与待分析文本一同送入模型。这相当于把“问题”和“状态”编码进输入,让模型在双向编码过程中动态理解需要抽取的实体类型。
据 YouTube 频道解释,这种设计让 GLiNER 无需针对每个新实体类别重新训练,只需在推理时提供标签列表即可完成抽取。原始模型专注于 NER,而最新的 GLiNER 2.5 仍保留该能力,同时支持更多任务。
零样本(Zero-shot)学习指的是模型在训练阶段从未见过某个任务或类别,却能在推理时直接完成该任务。传统监督学习要求每个目标类别都有标注样本,而零样本能力让模型可以泛化到新类别。GLiNER 通过把标签文本与输入文本一起编码,使模型能够比较二者的语义表示,从而判断文本片段是否属于给定标签,因此无需为每个新实体类别重新训练。严格来说,实际效果更接近“少样本提示”而非完全零样本,因为标签词本身的语义仍然依赖预训练阶段获得的语言知识。
双向编码器架构:无自回归头的优势
GLiNER 家族均采用双向编码器模型,属于 Transformer 的一种变体,但缺少语言模型中的自回归头。这意味着模型不是逐词生成输出,而是对输入序列进行双向上下文编码,从而更高效地理解标签与文本之间的对应关系。
这种架构带来的直接好处是推理速度更快、资源占用更低,尤其适合需要实时处理大量文本的抽取场景。与自回归大模型相比,GLiNER 在结构化信息抽取任务上表现出更高的参数效率。
自回归(Autoregressive)生成是指模型逐个预测下一个 token,并把已生成的 token 作为下一步输入,GPT 系列即采用这种方式。自回归头则是接在编码器之上、负责逐 token 输出概率分布的那层结构。去掉它之后,模型只剩编码器,输出的是每个 token 的上下文向量,而不是生成序列。GLiNER 正是在这些向量上做判别式打分:对文本中每个候选片段与每个标签分别计算匹配分数,再通过阈值筛选实体。这也是它“抽取而非生成”的本质,解释了为何它在结构化抽取上参数效率高,却无法完成摘要或对话这类需要自由生成的任务。
与传统 NER 及大模型方案的差异
传统 NER 模型通常为固定标签集训练,扩展新类别需要重新标注和微调。而 GLiNER 的“标签即输入”机制实现了零样本或少样本的实体抽取——用户只需在输入中列出目标标签,模型即可尝试识别。这与 Jev AI 等商业方案相比,提供了开源、可自托管的替代路径。
据同一来源分析,GLiNER 模型家族虽然具体任务不同,但共享同一核心思想:将标签和输入文本联合编码。这种统一接口降低了多任务部署的复杂度,开发者可以用同一套框架处理 NER、关系抽取等不同需求。
Jev AI 在文中被作为闭源商业信息抽取方案的代表提及,其具体产品细节和定价并未展开。需要说明的是,闭源方案通常提供托管 API、预训练好的领域模型以及配套的数据标注与部署服务,用户无需自行维护基础设施;代价是数据需离开本地、无法审计模型内部逻辑,且长期成本随调用量上升。GLiNER 的开源路线则相反:模型权重可下载、可本地部署、可微调,数据不出内网,但需要团队自行承担推理服务运维和效果评估。两者并非简单替代关系,选型取决于数据合规要求、调用规模和工程能力。
适用场景与局限
GLiNER 特别适合需要灵活定义实体类型的场景,例如从合同、简历或科研文献中抽取自定义字段。其双向编码器结构在长文本理解上也有优势。不过,由于缺少自回归生成能力,GLiNER 不适用于需要自由文本生成的任務,如摘要或对话。
对于寻求 Jev AI 替代方案的团队,GLiNER 提供了开源、可审计且易于集成的选择。随着 GLiNER 2.5 的发布,该系列在保持 NER 核心能力的同时,正逐步扩展为通用信息抽取工具。
相关推荐
5.3英寸手机众筹:小屏复兴还是599美元的无奈?
Enough Phone 在 Kickstarter 众筹,5.3 英寸小屏搭配 8GB 内存和 5000 万像素传感器,定价 599 美元。The Vergecast 讨论小屏手机能否在旗舰大屏与功能机之间找到中间地带,以及廉价手机为何越来越难做。
Asahi Linux弃用MIT转GPL:一场针对Omarchy的闹剧?
Asahi Linux将代码许可证从MIT改为GPL V2,指控Omarchy窃取代码并商业化。分析认为此举理由牵强且违反MIT协议,暴露开源社区政治分歧与AI争议。
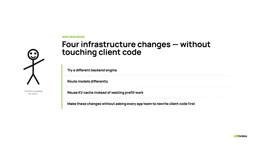
5分钟读懂NVIDIA Dynamo前端:兼容OpenAI的推理架构入口
NVIDIA Dynamo前端是什么?本文基于官方5分钟系列视频,解析它如何以OpenAI兼容API作为稳定边界,实现后端引擎替换、路由与KV缓存复用的解耦架构。