GPT-5.6发布:ChatGPT合并Codex,进化为AI工作台

OpenAI的战略转向:从聊天框到工作台
OpenAI刚刚发布了GPT-5.6,但这次真正值得关注的,并不是模型能力又提升了多少,而是一个关键的产品战略决定——将ChatGPT与编程工具Codex正式合并。这一举动背后,是OpenAI希望在商业化市场上追赶已占据一定优势的Anthropic。
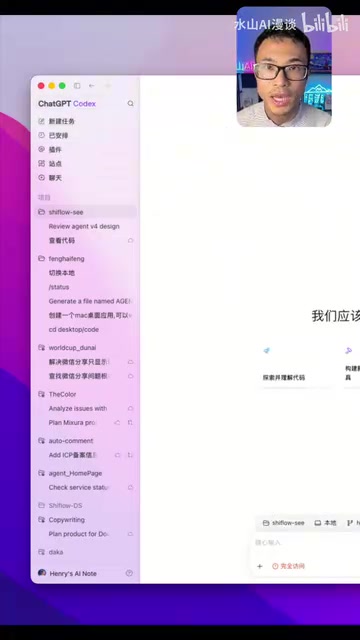
这次合并意味着ChatGPT不再只是一个简单的聊天框,而是开始转型为真正意义上的"AI工作台"。用户可以在界面左侧的工作区与Codex之间自由切换,形成完整的生产力流程,彻底告别过去单一的问答体验。
不只是回答,而是完成工作
新版本的Chat模式定位已经远超传统"回答问题"的范畴。它可以直接写代码、修改文档、制作表格、生成PPT,甚至能让AI Agent接管电脑、端到端执行一系列任务。通过新增的Site功能,用户还可以将产出结果直接部署为一个可访问的网页。
从"生成内容"到"完成任务"的跃迁,正是当前AI产品竞争的核心焦点。模型不再只被期待提供信息,而是要能够交付真正可用的成果。
三档模型命名:逻辑终于清晰了
GPT-5.6在模型分档上也做出了显著改进,三个版本分别命名为:
- Soul:旗舰版,面向最复杂的专业工作流
- Terra:日常均衡版,兼顾性能与效率
- Nuna:主打性价比的经济版本
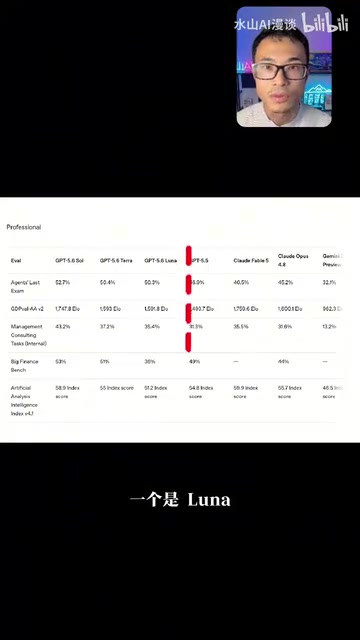
相比过去O系列、4O、Mini、High混杂让用户难以分辨的命名体系,这套三档逻辑清晰得多。用户可以根据任务复杂度和成本预算,快速匹配合适的版本。这种产品化思维的成熟,本身也是OpenAI在商业化道路上迈出的重要一步。
性能表现:正面对标Claude Fable 5
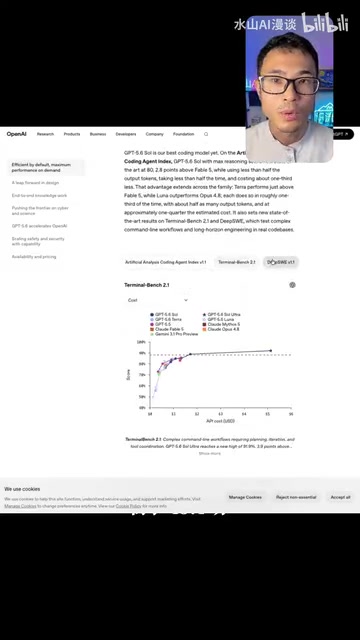
在性能层面,GPT-5.6 Soul主打长程专业工作流能力。在Agent能力测试LexExam中,GPT-5.6 Soul比Anthropic的Claude Fable 5高出13.1分。在编程Agent相关指标上,OpenAI也强调了更低的错误回退率、更短的任务耗时以及更优的成本控制。
跑分之外,可用性才是真正门槛
不过需要直言:这些benchmark分数的参考价值相当有限。当前主流评测基准,已经很难客观衡量顶级模型之间的真实差距。对于Claude Fable 5、GPT-5.6这类第一梯队模型而言,真正重要的不是数字高低,而是实际的稳定性与可用性。
这恰恰点出了AI行业当下最核心的转变:进入Agent时代,模型不能只是"更聪明",还必须能长时间稳定运行、成本可控,并真正嵌入实际工作流。一个偶尔天才但频繁翻车的模型,远不如一个能稳定交付结果的模型有价值。
Agent时代:竞争维度全面升级
从GPT-5.6的发布可以清晰看出,AI大模型的竞争正在进入新阶段。过去大家比拼参数规模和benchmark分数,而现在的关键词已经变成:稳定性、长程任务处理、成本效率、端到端任务交付。
OpenAI将ChatGPT与Codex合并,本质上是在构建完整的AI生产力平台,试图从Anthropic手中夺回商业化市场的主动权。三档模型的清晰划分,则显示出OpenAI在产品策略上正变得更加务实、更以用户为中心。
谁更强?实战才是最终裁判
跑分数据终究只是纸面参考。GPT-5.6 Soul与Claude Fable 5在真实场景下究竟谁更能打,仍需通过代码实战来检验。后续的实际任务对比测试,或许才是最值得期待的答案。
对开发者和企业用户而言,这场竞争的最终受益者正是我们自己——当两家顶尖厂商在稳定性、可用性和成本上激烈角逐,AI工作台的实用价值将被持续推向新的高度。
相关推荐

Claude Code 安装与防封号配置指南
Claude Code 国内安装教程:NPM 方式稳定安装,用 ccswitch 配置第三方模型绕开官方登录防封号,详解四种权限模式与提示词进阶技巧,助你安全高效使用 AI 编程工具。

十年民粹主义为何席卷全球?媒体结构是关键推手
Vox与《大西洋月刊》深度对话:十年民粹主义为何崛起?从广播、电视到社交媒体与AI,媒体结构的变迁如何成为民粹浪潮的关键推手。特朗普的权力悖论、拜登的通胀困境与未来走向全解析。

LLM推理引擎怎么选?七大主流方案全解析
七个主流LLM推理引擎怎么选?本文整理Llama CPP、MLXLM、XLama V3、Hugging Face Transformers、VLLM、SGLang、LMDeploy和TensorRT-LLM的优化方向与适用场景,帮你按CPU、GPU并发、显存受限和NVIDIA数据中心快速定位合适方案。