GPT-6.1 Sol深度实测:OpenAI用极致性价比反击Opus 5.5
GPT-6.1 Sol以极低定价和稳定性挑战Opus 5.5,但长循环重写与前端设计仍是短板。
OpenAI在Anthropic发布Opus 5.5后一周内推出GPT-6.1 Sol,以每百万Token输入2美元、缓存读取仅10美分的激进定价正面应战。科技博主Theo的实测显示,6.1 Sol在Deep SWE和Terminal Bench基准上以约73倍的成本优势追平Opus 5.5,且行为稳定性相比此前的Astra大幅改善,可胜任邮件处理、代码审查等高信任度任务。盲测中,该模型在10模型代码评审排行里位列第一。然而,它在长循环无人值守的重型重写任务中明显落后于Opus 5.5,前端与UI设计能力也被评价为"烂透了"。Theo的最终建议是:用Opus主导实现与长周期构建,调用Sol负责调查、定位Bug和代码审查,二者分工协作效果最佳。
OpenAI的闪电反击:从6.0到6.1只隔一周
在Anthropic发布强悍的Opus 5.5之后,AI编码模型的竞争进入白热化阶段。据B站搬运的知名科技博主Theo(t3.gg)的深度实测,OpenAI在短短一周内接连推出GPT-6 Sol、GPT-6 Luna,而真正引发行业震动的,是刚刚向所有人开放的 GPT-6.1 Sol。
Theo在视频中坦言,他提前获得了访问权限但未收取任何报酬,OpenAI只能影响他发布内容的时间,无法影响内容本身。这一点很重要,因为他接下来给出的判断相当大胆:从6.0 Sol到6.1 Sol仅隔一周,再加上这款模型明显更聪明、Token生成速度更慢(通常意味着模型更大),他推断6.1 Sol原本可能并不打算以"小版本号"的形式出现,背后存在根本性的架构差异。
换句话说,这不是一次简单的微调升级,而是OpenAI针对Opus 5.5的一次正面迎击。
便宜到离谱的定价:补贴时代的终结信号
6.1 Sol最具冲击力的部分不是智能,而是价格。它的定价为每百万输入Token 2美元、每百万输出Token 10美元——与GPT-6 Sol相同,却只有Astra价格的五分之一。
更关键的是缓存读取价格。据Theo介绍,OpenAI过去从未改动过缓存读取价格,始终固定为正常读取价格的10%(即90%折扣)。而这次缓存读取降至每百万输入10美分,相当于95%折扣,直接将缓存成本砍半。
这为什么重要?因为在真实的智能体工作负载中,约96%的请求都是缓存读取。Theo在实测中发现,6.1 Sol每个请求平均只读取约11万Token,而Sonic 5高达36万Token。极高的Token利用率叠加极低的缓存价格,带来了夸张的性价比。
同时,Theo注意到OpenAI旗下的200美元Pro订阅回归,但用量计算方式发生改变——折算后API消费额度只有旧方案的一半。他由此推断:这可能意味着一个利润空间更薄的新模型到来,补贴能力正在下降。他直言,"这可能确实标志着补贴时代开始走向终结。"
缓存读取(Cache Read)机制是大语言模型API计费中的重要概念。当用户在多次请求中重复传入相同的前缀内容——例如系统提示词、代码库上下文或长篇文档——服务商可以将这部分Token的KV缓存(Key-Value Cache)保存在显存或高速存储中,后续请求命中缓存后无需重新计算注意力,因此成本大幅低于"冷启动"读取。在智能体(Agent)工作流中,每一步工具调用都需要将完整的历史上下文重新传入模型,导致绝大多数请求都在读取相同的前缀——这正是Theo所说"约96%的请求都是缓存读取"的原因。缓存价格的高低因此直接决定了在真实Agent场景下的实际账单,而非仅仅是纸面上的输入Token单价。OpenAI将缓存读取从正常价格的10%进一步降至5%(即95%折扣),对高频调用的生产级Agent应用而言,相当于再次将成本对半砍断,其实际影响远大于正常输入价格的调整。
基准测试:追平Opus,成本便宜数十倍
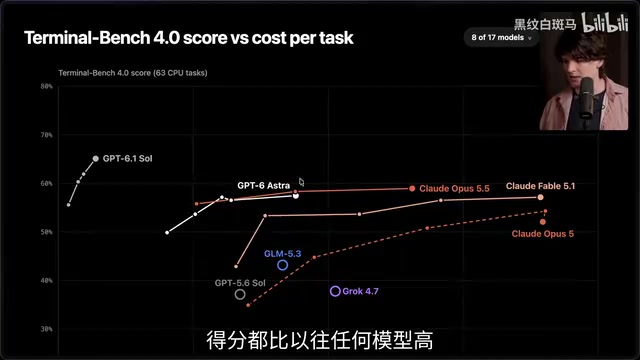
Theo亲自在自己的虚拟机上运行了Terminal Bench 4和Deep SWE等基准测试,并反复强调测试环境并不理想(甚至不得不剔除需要H100才能跑的任务)。但数据依然惊人:
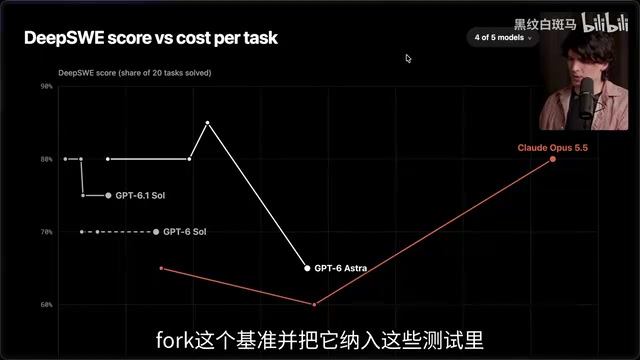
- 在Deep SWE上,6.1 Sol在Low和High档取得的分数与Astra在High档相当,但Low档成本仅21美分,而Astra需要1.46美元;
- Opus 5.5在Max档取得相同分数需要14.65美元——换言之,6.1 Sol便宜约73倍;
- 在Terminal Bench上,6.1 Sol追平了Opus 5.5在Max模式下的表现,但耗时只需十分之一、价格只需约七分之一。
Theo同时对基准测试保持高度怀疑,坦承Deep SWE远不是衡量日常编码能力的完美标准。但"同样分数便宜数十倍"这一事实,仍值得整个行业注意。
Terminal Bench和Deep SWE是目前评估AI编码能力的两类主流基准。Deep SWE(Software Engineering)系列来源于SWE-bench,要求模型在真实GitHub仓库中定位并修复Issue对应的Bug,涵盖从理解代码库结构到生成可通过单元测试的补丁的完整流程,被认为比简单的代码补全任务更接近工程实战。"Low/High/Max档"通常对应模型在推理时允许使用的思考步数或工具调用预算,档位越高允许模型花费更多计算资源探索,分数上限更高但成本也成比例上升。Terminal Bench则侧重在真实终端环境中执行多步骤任务的能力,需要模型通过命令行完成文件操作、代码编译、环境配置等工作。这两类基准的共同局限在于,它们衡量的是模型在离散、有边界任务上的成功率,难以全面反映日常开发中对话式协作、代码审查或长周期迭代的实际表现——这也是Theo多次强调"不是完美标准"的原因。
行为稳定性:告别Astra的"抽风"
Theo对GPT-6家族最大的不满,是Astra的"又聪明又蠢"——峰值表现惊艳,却会随机做出极其低级的错误,稳定性差到让他基本弃用。
6.1 Sol在这方面有了明显改善。他表示这个模型"大部分修好了"Astra的问题,稳定性"好太多太多"。他甚至放心让模型翻遍所有邮件、找出逾期发票、在Chrome里为每笔投资电汇填好信息——"一件事都没做错",而这是他不敢交给Astra做的。
其他测试者的反馈佐证了这一点:据Theo转述,同样参与测试的Julius称其"非常出色",Ben则说它"无聊得惊人"——而对于一次模型发布而言,"无聊"恰恰是稳定的褒义词。代价是峰值表现不如Astra那般革命性,计算机操作能力也略逊,但差距小到他毫不犹豫地选它处理日常工作。
最强场景:深度代码审查而非长循环构建
Theo用了一个生动的比喻:OpenAI模型有一种"罗威纳犬式"的特质,会死死咬住一个问题深挖、撕扯,直到揪出每一个毛病。6.1 Sol在代码审查上的能力强得惊人。
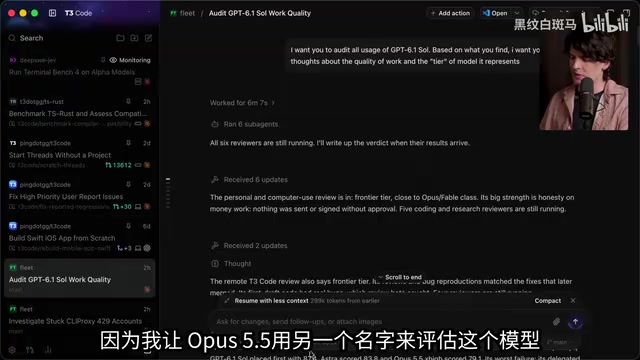
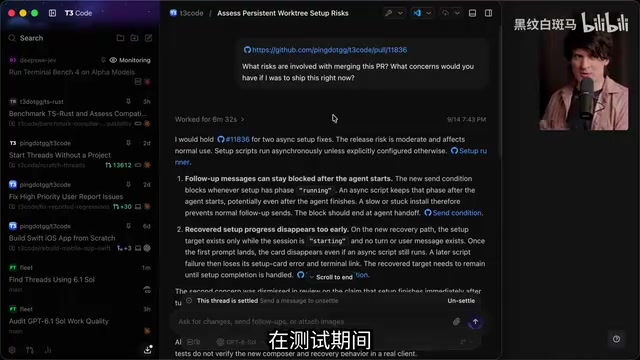
在一次让Opus 5.5盲测评估的实验中(Theo事后编辑了历史记录隐藏模型身份),Opus很快判定这是"前沿级别的模型",并在10模型盲测的代码评审基准中给6.1 Sol打出 87.4分排名第一。实测中,6.1 Sol还抓出了Fable和Opus都遗漏的真实bug,成功阻止了一次会引入回归的合并。
但6.1 Sol也有明显短板。在一个将TypeScript移植到Rust的长周期重写任务中,它"烧掉一大堆Token却毫无进展",死守流程规则、卡住也不求助。而Opus 5.5能从头重写、一天内跑通。据Theo估算,Opus在这类长时间无人值守的重型重写上"领先程度简直离谱"。
Theo提到的"长循环重写"(long agentic loop)任务代表了AI编程助手的一类特殊挑战:模型需要在没有人工实时干预的情况下,自主规划并执行数十乃至数百步操作,包括阅读代码、制定迁移策略、逐文件改写、修复编译错误,并最终通过测试套件验证结果。这类任务对模型的"鲁棒性"要求极高——不仅需要智能,更需要在陷入死循环或错误路径时主动识别并调整策略(即"自我恢复"能力),而非固守既定流程。TypeScript到Rust的迁移尤为苛刻,因为两者在内存模型、所有权系统和类型体系上存在根本差异,机械翻译几乎不可行,必须进行大量架构重新决策。6.1 Sol在此场景失败——"烧Token不求助"——说明其在不确定状态下的元认知能力(知道自己卡住了)仍弱于Opus 5.5。
短板:前端与UI惨不忍睹
在"Fish Slap"的趣味测试环节,6.1 Sol生成的鱼缸游戏暴露了严重问题:画面精度确实更高(植物、鱼缸污垢等细节出色),但UI被大量毫无必要的文字堆满,移动手感卡顿、帧率糟糕,甚至无征兆地随机弹出游戏结束。
Theo毫不留情地评价:"这个模型做前端烂透了,它做设计也很烂,毫无审美。"如果你需要一个能做出像样前端的模型,不该把钱花在这里。不过它在Blender三维建模方面表现不错——给一张截图就能通过CLI做出相当好的模型。
结论:默认编码模型的有力候选,但Opus仍是更好的协作者
Theo给出的整体判断清晰而克制:6.1 Sol完全可以成为很多人的默认编码模型,在"范围明确"的工作上表现属最前沿水平,而且价格难以置信。
他给出的最佳用法是让Opus 5.5实时调用6.1 Sol——由Sol负责调查、定位bug根因、分析代码库、评审Opus的工作,而由Opus负责真正的代码实现和长循环构建。因为他发现Sol在审查深挖上更强,Opus则是"更令人愉快的协作者",实现代码时明显更出色、不易卡住。
值得玩味的是,当Opus被问及这个模型该定什么价时,它猜测应与自身相当(输入5美元、输出30美元)。得知实际价格仅为输入2美元、输出10美元后,Opus的评价是"定价非常激进",并预测这个价格"未来会上涨"。
对于普通开发者,Theo的建议很实用:如果你的工作落在6.1 Sol的能力范围内,就把一切交给它;如果不是,继续用Opus,并让Opus调用Sol做分诊和审查。这是一次优秀的发布,但它没能把Opus从主力位置上拉下来——至少现在还没有。
相关推荐

Last Week Tonight深扒:政客与白人至上主义的危险纽带
Last Week Tonight调查佐治亚州参议员候选人Mike Collins与佛罗里达州候选人Marshall Rawson,揭露他们与白人至上主义者的多重关联,以及共和党内的沉默反应。

AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。

AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。