GPT-6 Astra 深度解析:百万上下文、定价与实测表现
GPT-6 Astra以105万token上下文、多项智能体基准新高和首个Critical安全评级定位顶级专业旗舰模型。
OpenAI发布的GPT-6 Astra是其当前能力上限最高的模型,核心亮点包括约105万token的超长上下文窗口、每百万token输入$10/输出$50的高端定价,以及在Terminal-Bench 4.0和OSWorld 2.0两项智能体基准上的纪录刷新。同时,Astra成为OpenAI首个在网络安全维度获评"Critical"级别的模型,代表其在安全相关任务上能力显著提升,但也意味着潜在滥用风险更高,配套更严格的访问管控。对开发者而言,Astra可通过Codex和OpenCode环境调用,适合整项目级代码任务,但基准成绩不能直接等同于生产表现,高成本结构与安全合规要求使其更适合有硬性能力需求的专业场景,而非日常通用替代品。
OpenAI 最新发布的 GPT-6 Astra 被定位为其"最高能力"模型(max-capability model),从公开信息来看,这款模型在上下文窗口、基准测试和安全评级上都释放出不少值得关注的信号。本文梳理它的核心参数、基准表现的真实含义,以及验证过的调用方式。
Astra 是什么:核心参数一览
GPT-6 Astra 最直观的升级体现在两个数字上:1.05M(约 105 万)token 的上下文窗口,以及 每百万 token 输入 10 美元、输出 50 美元 的定价。
超过百万级别的上下文意味着 Astra 可以在单次对话中容纳大型代码库、长篇文档或多轮复杂交互,而不必频繁做分块与检索。这对处理整仓库级别的代码理解、长合同分析、大规模日志排查等场景尤为关键。
定价方面,$10/$50 的组合属于典型的高端旗舰定价——输出成本是输入成本的 5 倍,提示开发者在设计应用时需要格外关注生成长度的控制。相比常见的中端模型,这个价位显然是面向对能力上限有硬需求、且愿意为质量付费的专业场景。
上下文窗口(context window)指模型在单次推理中能够同时处理的最大 token 数量,涵盖输入提示与生成输出的总和。token 并非直接等于字符或单词:英文中一个 token 约对应 4 个字符或 0.75 个词,中文因字符密度更高,通常一个汉字对应 1-2 个 token。1.05M token 的上下文窗口换算为英文约等于 75-80 万单词,相当于一部中等规模的长篇小说,或数十万行代码。从 GPT-3.5 的 4K、GPT-4 早期的 8K-32K,到 GPT-4o 的 128K,再到 Astra 的 105 万,上下文窗口的扩展路径折射出业界在长程记忆与注意力机制上的持续突破。更大的窗口降低了对检索增强生成(RAG)的依赖,但也意味着单次调用的计算成本与延迟都可能随之上升,需要在架构设计中权衡取舍。
基准测试:新高背后的边界
根据官方释放的信息,Astra 在 Terminal-Bench 4.0 和 OSWorld 2.0 上都刷新了成绩。这两项基准分别衡量模型在终端命令环境和操作系统级别任务中的执行能力,属于近来评估"能动手办事"的智能体(agentic)能力的重要标尺。
基准说明了什么
Terminal-Bench 与 OSWorld 的高分,反映出 Astra 在任务规划、工具调用和多步骤执行上有实质性提升。对于希望把模型嵌入到自动化工作流、CLI 工具或桌面操作代理中的团队,这类分数比传统的问答类评测更有参考价值。
Terminal-Bench 4.0 是专门评测语言模型在真实终端环境中执行命令行任务能力的基准,涵盖文件操作、进程管理、脚本编写和多步骤 shell 任务等场景,要求模型不仅能生成代码,还要能在反馈循环中根据执行结果动态调整。OSWorld 2.0 则模拟完整的桌面操作系统环境,测试模型通过截图感知、GUI 交互和跨应用协作完成复杂任务的能力,例如在浏览器、文件管理器和办公软件之间协同操作。两者的共同特点是:任务具有延迟反馈性(mid-task feedback)和长程依赖性,这对模型的工作记忆和规划能力要求远超单轮问答基准。在这两项测试上取得领先,意味着 Astra 在"感知→规划→执行→校正"的完整智能体循环中具备更强的鲁棒性。
基准没有说的
需要清醒看待的是,基准分数并不能直接等同于生产环境表现。原文特别强调了"benchmarks do and do not say"这一点——刷新纪录说明模型在受控任务集上表现优异,但并不保证在你的具体业务数据、边缘场景或长尾需求上同样出色。基准的任务分布、评分口径都可能与真实使用存在偏差,因此上线前的独立验证仍不可或缺。
首个"Critical"网络安全评级:能力与风险并存
Astra 是 OpenAI 首个在网络安全维度被评为 Critical(关键级) 的模型。这是一个双面信号。
一方面,它印证了模型在安全相关任务上的能力已经达到相当高的水平——能够理解、分析乃至操作复杂的技术系统。另一方面,Critical 评级也意味着 OpenAI 认为这种能力具备被滥用的潜在风险,因此可能配套更严格的使用政策、访问控制或监控机制。
对企业用户而言,这提示在部署 Astra 处理安全敏感任务时,需要同步考虑合规、审计和权限边界,而不能简单当作一个更强的通用模型来用。
OpenAI 的安全评级体系来自其《准备框架》(Preparedness Framework),将模型在网络安全、生物武器、化学武器、放射性威胁及自主复制等维度的潜在危害分为 Low、Medium、High 和 Critical 四个等级。Critical 是最高级别,代表 OpenAI 判断该模型在该维度上具备"可独立实施大规模伤害"的潜在能力,例如能够协助发现并利用新型漏洞、生成可部署的攻击工具链,或显著降低高级威胁行为者(APT)的攻击门槛。根据框架规定,评级达到 Critical 的模型原则上不应部署,除非通过额外的缓解措施将风险降至可接受水平。Astra 能够获准发布,意味着 OpenAI 认为已为该评级配套了足够的访问限制与监控机制,但企业用户仍需了解这一背景,以便在自身合规体系中做出相应的风险管控安排。
如何调用:Codex 与 OpenCode
原文提供了在 Codex 和 OpenCode 环境中试用 Astra 的验证命令。这两个都是面向开发者的编程与代码执行环境,配合 Astra 的百万级上下文和强化的终端任务能力,理论上能够胜任整项目级别的代码生成、重构与调试。
对于想要上手的开发者,建议的路径是:
- 从小规模、可验证的任务开始,测试模型在你自己代码库上的实际表现;
- 关注 token 消耗,尤其是长上下文场景下的成本累积;
- 针对安全敏感操作,预留人工复核环节。
由于原始素材未展开具体命令细节,实际调用时应以 OpenAI 官方文档给出的最新命令与参数为准。
小结:旗舰能力,理性使用
GPT-6 Astra 代表了当前 OpenAI 在能力上限上的最新尝试:百万级上下文、多项基准新高、以及首个 Critical 安全评级。它更像是为高强度、专业化任务准备的工具,而非日常通用替代品。
对于评估是否采用的团队,关键不在于基准数字有多亮眼,而在于这些能力能否在你的真实场景中稳定兑现,以及 $10/$50 的成本结构是否与预期收益匹配。先小范围验证、再逐步放量,是面对这类旗舰模型更稳妥的策略。
相关推荐
VCP V工程实测:Token缓存95%命中,AI控制AI螺旋编程
VCP V工程实测:单轮对话Token缓存命中率95%以上,用AI控制AI实现螺旋编程,主控Agent策划、施工Agent写码,已策划工程可完全脱手。附完整配置步骤与局限分析。
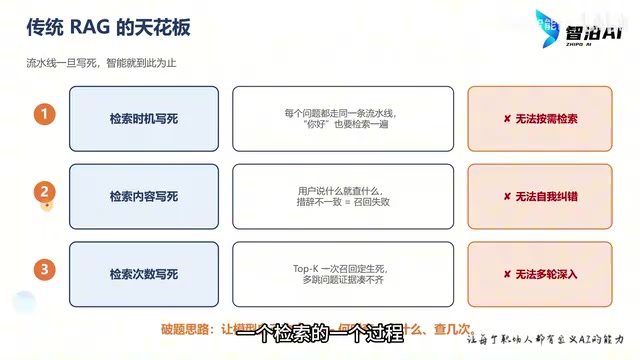
Agentic RAG实战:从原理到代码,手把手搭建智能检索系统
传统RAG检索时机、内容、次数全部写死,导致答非所问。本文基于B站教程拆解Agentic RAG原理:将检索封装为工具交给大模型自主决策,附四工具设计与完整代码实现,手把手搭建能自我纠错、多跳查询的智能检索系统。
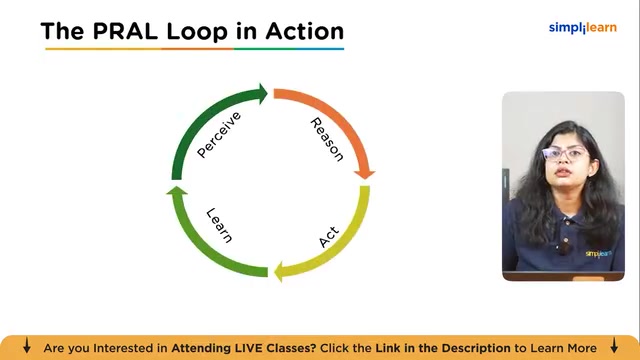
1小时搞懂Agentic AI:架构、设计模式与实战搭建
Simplilearn的Agentic AI速成课程解析:智能体三层架构(感知、认知、动作)、单智能体与多智能体对比、感知推理执行学习循环、三种设计模式,以及研究智能体、应用构建和反馈修复循环的实战演示。