GPT-6 Astra直接改权重修模型?MIT论文与泄露信息全解析

前沿模型直接编辑权重、纯代码生成动画、WiFi感知走红,模型正从答题走向动手。
本周AI圈的焦点是MIT论文提出的"权重空间编程":GPT-6 Astra 仅凭原始权重识别小型网络对应的游戏,并通过改动约0.016%的参数,把一个小模型的 Math 500 分数从7.9%提升到48.1%,还能从零写出能玩 Breakout 的网络。但质疑者指出,这本质上是一次聪明的循环修复,且借助了代码和标准可解释性工具,论文标题略有夸大。Simon Willison 的本地复现显示任务可行但极其耗时。另一边,OpenAI官方图表中未具名内部模型在 BenchCAD 2.0 上大幅领先 Astra,被视为 GPT-6.2 临近的强线索;Anthropic 的 Fable 5.5 测试者持续产出可逐帧编辑的纯代码动画;Claude Code 生成 WiFi 雷达代码的帖子因"床边第二个形状"走红,但装置细节无法核实。
引言:当前沿模型开始"修理"其他模型
本周AI圈最引人注目的消息,来自MIT的一篇论文:GPT-6 Astra被用来直接编辑另一个小模型的权重,全程没有训练。如果这个结果成立,意味着前沿模型第一次能"伸手"到另一个模型的内部做手术。另一边,OpenAI内部图表泄露、Fable 5.5的纯代码电影、Claude Code把路由器变成雷达的病毒式传播,共同拼出了这一周的技术图景。以下逐条拆解。
MIT论文:权重空间编程到底是什么
实验设计
据MIT四位研究者(由Rikia Takehi和Jaden Teo带队)的论文,他们提出了"权重空间编程"(weight space programming)的概念:把小型网络的原始权重交给GPT-6 Astra,让它读取、修复或从零写出新的权重。
最简单的测试里,Astra面对四个分别学会了不同街机游戏的小型网络,仅凭原始权重就准确说出了每个网络对应哪个游戏,且全程没有运行这些网络。
权重空间编程这个提法需要放在模型可解释性与权重操控的脉络里理解。传统上,要改变一个神经网络的行为,路径是准备数据、设计损失函数、跑梯度下降训练。权重空间编程的设想是把权重本身当作一种可读写的"程序文本"交给另一个模型,让它直接完成读取、诊断和写入。这条思路与机械可解释性(mechanistic interpretability)密切相关——后者试图把网络内部激活和权重分解成人类可理解的"特征"或"方向"。文章后面提到的"定位到两层内部的某个方向然后减掉",正是这类方法的典型操作:它假设某种能力或故障对应权重空间中的特定方向,因而可以通过向量运算直接增删。这类操作通常被称为激活引导(steering)或权重编辑,其难点在于方向是否稳定、是否泛化到其他任务,以及是否会误伤其他能力。
数学修复实验
更受关注的是修复实验。一个小型开源模型在Math 500测试上只拿到7.9%的分数。Astra在Python笔记本里让模型做了一些练习题,把问题定位到两层内部的某个方向,然后把这个方向减掉。这大约触及13万个权重,改动比例约0.016%,数学分数随即升到48.1%,指令遵循能力也大约提升了两倍。
Math 500是一个常用的数学推理评测集,包含500道竞赛风格的数学题,答案通常是一个整数或简单表达式,因此可用精确匹配自动判分。相比只考察小学算术的GSM8K,Math 500 的题目难度更高,模型需要多步推理,这也意味着"陷入重复输出"这类故障会造成严重失分——一旦模型在某个中间步骤进入循环,整道题就作废。所谓重复输出(degeneration / looping),指模型反复生成相同或高度相似的片段直到达到长度上限,常见诱因包括解码参数设置不当、训练数据分布偏差、以及模型对某些提示格式过拟合。这解释了为什么质疑者认为7.9%的低分更多反映的是解码循环而非数学能力缺失:切断循环后分数大幅回升,并不必然说明模型"学会了数学"。
从零写出网络
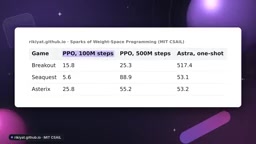
写作测试同样值得注意。从全零开始、没有数据也没有训练,Astra写出了一个能玩Breakout的小型网络,得分超过500分。作为对照,正常训练1亿步的网络得分约16分,训练5亿步后也才25分。
争议与复现:头条有点言过其实
质疑者的声音
Karen Zou指出,那个小型模型其实并非真的数学差,而是在93%的题目上陷入重复输出。Astra做的是找到循环并切断它,而一个不再循环的模型几乎在所有任务上都会变好。Adam Karvanen补充说,Astra这一步用的是代码和标准的可解释性技巧,这和"在心里读权重"是两回事。论文本身也承认,在一个不循环的小型Gemma模型上,同样的方法几乎没带来提升。
Simon Willison的本地测试
Simon Willison把"读权重认游戏"这项测试搬到了自己的笔记本上,用LM Studio跑一个量化后约17GB的模型。它确实做对了,但速度很慢:Pac-Man花了46分钟,Pong超过一小时。而通过OpenRouter调用的Kimi K 3.1 Pro,在10分钟内就认出了Breakout。Simon认为论文混了两个问题:模型单靠权重能做什么,以及模型借助代码能做什么。他表示自己还不准备宣布源码的终结。
量化指用更低精度的数值表示模型权重,例如把原本16位的浮点数压到8位甚至4位,以缩小显存占用、提升推理速度。Simon Willison 本地运行的约17GB模型正是量化后的产物,代价是数字精度损失可能影响需要精细读取权重信息的任务——这也部分解释了他观察到的高耗时。LM Studio是一个本地模型运行与管理的桌面应用,支持加载多种开源权重格式。而OpenRouter是聚合多家模型API的路由服务,通过它调用的模型运行在云端,算力远强于笔记本,因此同一项任务的时间差异不仅来自模型能力,也来自硬件与精度条件。在比较这类实验时,把"本地量化"与"云端全精度"放在一起讨论,容易混淆变量。
社区快速跟进
据开发者Adam Holtererer的测试,他让五个模型去编辑小型模型的权重,其中一个模型只改动了小型模型中极小一部分权重,数学正确题数就从96题中的24题几乎翻倍到46题。另一位开发者让模型手写了一个小型网络,用来分辨真实与伪造的法律引用,在没有一个标注样本的情况下得分97.8%,而训练版本需要大量标注数据才达到相近水平。
我的判断是,标题确实略微夸大了结论,因为那个数学修复本质上是一次聪明的循环修复。但反对方的观点也有道理:这些模型在学习写代码的过程中调试过无数小型神经网络问题,这本身就是一项被反复练习的技能。如果模型能定位并修复另一个模型内部的故障,下一步自然是实验室把这项技能对准自己的模型。
GPT-6.2泄露线索:OpenAI自己的图表
最强的线索来自OpenAI官方。它发布了一篇关于用ChatGPT和Codex做硬件工程的文章,其中一张图表对比了GPT-6 Astra与一个未具名的内部模型,测试基准叫BenchCAD 2.0,要求模型重建3D零件并找出电路板上的连接。Astra在最高推理设置下平均得分0.594,内部模型为0.875。
这条线索并非孤立。此前Codex使用图表中出现了GPT-6.2 Astra的标签,Sam Altman也说过OpenAI纳维-斯托克斯结果背后的模型就是下一代GPT。OpenAI没有在图表中给内部模型命名,所以不能断定是同一个,但在工程测试上这么大的差距,与外界听到的其他信息是吻合的。
OpenAI Codex团队的Thibault先开玩笑提到"一个胖GPT",随后又发了一条只写着ChatBLT的帖子。有人把它解读为6.2是一个非常大的模型,但OpenAI没有任何人确认。另有用户分享了一张网站截图,称GPT-6.2是一个非常大的模型,还有人贴出Codex桌面应用模型选择器里的GPT-6.2 Astra,但都只是单张截图。
价格方面也有传闻。Bindu Reddy称6.2可能降价60%,与Opus 5.5同价,还说用户在构建应用和盲测中更偏好Astra而非Opus,这些同样未经证实。
Fable 5.5:纯代码电影成为新常态
Anthropic的下一代模型更多是通过测试者而非官方渠道露面的。Mythos 5.5的页面标题在周日泄露,Fable 5.5的演示也没有放缓,而且全部由代码生成。
Muviz称他用Fable 5.5一次生成了一个42秒的动画,整个作品是单个HTML文件,基于3.js构建,每一帧都由代码绘制,声音也是合成的。他声称这超过了90%的视频模型,这个说法相当大胆。它与视频模型的区别在于,你可以打开文件修改任何部分,这种可编辑性是视频永远做不到的。
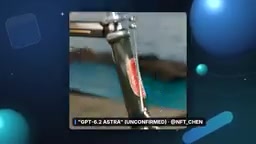
Chris Gpt则用了经典测试:宇航员在月球上骑着鹈鹕骑自行车,做成动画SVG。他指出自行车使用了真实的公路车几何结构,链条、曲柄和车轮联动运转,这在代码里很难做对。他给作品标的是Fable 5.5或Opus 5.6,而Anthropic两个名字都没公布,后者值得留意。
权重编辑的故事和这些电影指向同一个方向:最新的模型正在做过去需要专门工具才能完成的工作。
Claude WiFi雷达:一个真实的鬼故事
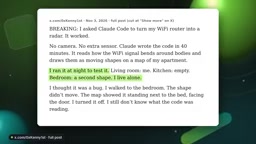
本周传播最广的Claude帖子,来自一位用户说他让Claude Code把家里的WiFi路由器变成雷达,Claude在40分钟内写出了代码。视频里,人在公寓地图上显示为移动的形状,面板甚至声称能读取心率和呼吸。
真正让它病毒式传播的是结尾:他说自己在夜里运行,看到床边站着第二个形状,而他独居。在回复中他承认反射和鬼影目标是已知问题,自己也不确定是什么造成的。WiFi感知本身是真实存在的,卡内基梅隆大学的研究者在2022年就展示过WiFi信号可以估计房间内人的姿态。但他的具体装置无法核实:帖子没说用的什么路由器,而这很关键,因为读取这种信号细节通常需要特定芯片或修改过的固件。当作一个底子有真东西的鬼故事来享受就好,第二个形状不能证明任何事。
WiFi感知(WiFi sensing)的原理是利用信道状态信息(CSI):WiFi信号在传播中会被人体反射、吸收和散射,接收端据此获得的每个子载波的幅度与相位会发生细微变化。人呼吸、心跳和肢体移动都会引起这种变化的周期性模式,经过信号处理后可以推断是否存在人体、大致位置乃至呼吸频率。难点在于CSI的获取:普通家用路由器通常不对外暴露原始CSI,需要特定网卡(如支持CSI提取的Intel网卡)或刷入修改过的固件,并且需要在受控环境中做大量校准。多径反射会造成鬼影:信号经墙壁、家具多次反射后,会在重建图上形成类似人体的虚假目标,这与文章提到的"第二个形状"高度吻合。因此这类演示即使代码真实,结论也需谨慎对待。
其他动态:Claude插件与Google校园策略
Claude现在可以在登录时自动连接插件,前提是插件服务器接受Claude作为可信签发者。对工作中使用一堆内部工具的用户来说,这省掉了大量零散的登录操作。
Google则调整了学校账号策略:在学校管理的学生账号上,Search、Gemini、Gemini Notebook和Classroom中的Gemini将默认关闭,需要管理员手动开启。问题在于,学校可开启的搜索选项包含AI功能,所以一所想要完全禁用AI的学校,也会连带失去Google Search。据纽约时报报道,这些变化将从明年初开始。预计学校会大力争取一个纯搜索选项,我认为Google最终会加上。
写在最后
这一周的主线很清楚:模型正在从"回答问题"走向"动手做事"——编辑权重、写出可运行的游戏网络、生成可编辑的动画文件。围绕GPT-6.2的泄露信息虽然都未获官方确认,但OpenAI自己的工程基准图表是其中分量最重的一块拼图。至于WiFi雷达的第二个形状,当技术故事看就好,别当证据。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。