GPT-6、Claude Opus 5.5实测对决:AI模型是否存在"特调作弊"?
GPT-6与Claude Opus 5.5同台竞技,"换猫猫"实测揭示AI跑分水分与真实泛化能力的差距。
OpenAI GPT-6系列与Anthropic Claude Opus 5.5几乎同期发布,引发社区对两大技术路线的正面比较。本次实测的亮点在于采用"换动物"手法——将经典测试题中的对象替换为"猫猫"——以此检验模型是否存在针对特定基准的过拟合(特调)问题。真正具备泛化推理能力的模型,无论题目主角如何变换,表现都应保持稳定;反之则说明其高分更多来自对训练数据的记忆。文章最终将选择权交还用户:与其迷信官方跑分,不如以自身真实使用场景为标准来评估模型,因为两家各有侧重,没有绝对赢家,只有更适合特定需求的模型。
两大顶级模型撞车发布
近期,OpenAI与Anthropic(Claude)几乎在同一时间释出了各自的最新旗舰模型,形成了针尖对麦芒的正面竞争。一边是OpenAI的GPT-6系列(含Sol、Luna等版本),另一边则是Anthropic的Claude Opus 5.5。发布时间的高度重合,本身就已经点燃了社区对两家技术路线孰强孰弱的讨论热情。
据B站相关UP主的实测视频分析,这种"撞车"并非偶然——顶级AI厂商往往会在竞品发布节点附近抢发,以争夺舆论声量和用户心智。对普通用户而言,问题的核心并不在于谁先谁后,而在于:面对同样的任务,这些模型究竟谁表现更好,又是否存在被人为"优化"过跑分的嫌疑。
用"换动物"揭穿特调嫌疑
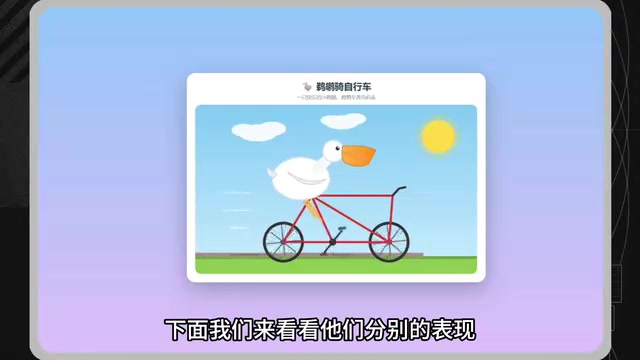
这次实测中一个颇具巧思的设计,是把常规测试题目里的对象替换成了"猫猫"。这背后的逻辑值得深究:许多模型在面对高频、经典的基准测试题时表现优异,但一旦把题目里的关键对象换成另一种动物或场景,表现就可能大幅波动。
这种现象往往暗示模型可能存在"特调"(针对特定测试集过拟合)的嫌疑——也就是说,模型可能在训练或调优阶段"背"过类似题目,而非真正具备泛化推理能力。通过更换测试对象来打乱模型的"记忆惯性",是社区评测者用来甄别模型真实能力的常见手段。
为什么"换个说法"能测出真本事
真正具备强推理能力的模型,无论题目里的主角是猫、狗还是任意对象,其解题逻辑应保持一致、结果稳定。反之,若某模型只在特定表述下表现拔群,换个动物就"翻车",那它的高分很可能来自对训练数据的记忆,而非真实理解。这也是为什么评测者需要不断变换题面,才能挤掉基准测试中的"水分"。
这种方法在学术界有对应的概念,称为分布外泛化测试(Out-of-Distribution Generalization)。标准基准测试集(如MMLU、HumanEval、GSM8K等)经过多年公开流传,已成为业界共知的"考纲"。若模型开发方在微调阶段使用了与测试集高度相似的数据,模型便会形成"题目-答案"的表层映射,而非习得背后的推理规则。换动物、换人名、换场景,本质上是在构造一个测试集的"同构变体"——逻辑结构完全相同,但表面符号全部替换——迫使模型必须依赖真实的逻辑推理才能作答,而无法靠记忆"抄近路"。这也是为何OpenAI、Google等机构内部评测时,往往会维护一套从不公开的私有测试集,并持续滚动更新题目。
谁更适合我们?评测的现实意义
对于终端用户来说,模型的意义并不在于跑分榜上的名次,而在于日常使用中的稳定性和可靠性。一款在标准测试里刷高分、却在真实场景中频繁出错的模型,实用价值反而有限。
从这次对比可以提炼出一个选型原则:与其盲信官方公布的基准成绩,不如关注模型在"非标准"、贴近自身使用场景任务中的表现。评测者最终把判断权交还给了观众——"做选择,相信大家都有判断了",这恰恰说明不同模型各有侧重,没有绝对的赢家,只有更适合特定需求的选择。
理性看待AI跑分
随着大模型竞争白热化,"跑分军备竞赛"愈演愈烈,特调、过拟合基准的争议也随之增多。作为用户,保持一份对营销数据的审慎,用自己真实的工作任务去检验模型,才是最靠谱的评估方式。这次"换猫猫"实测正是这种理性精神的体现。
过拟合基准(Benchmark Overfitting),又称"Goodhart定律在AI评测中的体现":当一个指标变成目标本身,它就不再是好指标。目前主流大模型基准(如MMLU、BigBench、MATH等)均已被广泛用于模型的训练数据筛选与强化学习奖励信号设计,导致高分越来越难以映射到真实能力的提升。学术界正在探索动态基准(如HELM、LiveBench)和对抗性评测(Adversarial NLI)等替代方案,以求在公开评测和防刷分之间取得平衡。对普通用户而言,最直接的反制策略就是:把自己每天真实遇到的典型问题整理成个人测试集,用它来横向对比不同模型,这份"私有基准"的参考价值往往远超任何公开榜单。
小结
这场GPT-6与Claude Opus 5.5的正面对决,与其说是分出高下,不如说揭示了当下AI评测的一个关键议题:如何辨别模型的真实能力与"应试"技巧。变换测试对象、关注真实场景表现,是每一个AI使用者都应掌握的判断力。至于哪个模型最适合你,答案或许要在自己的实际使用中才能找到。
相关推荐
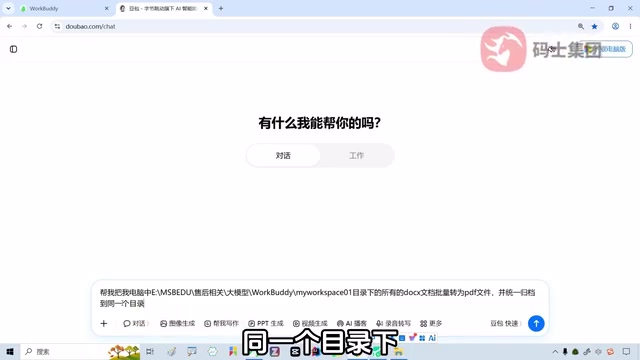
WorkBuddy AI智能体实战:从大模型到Agent的落地差异
通过批量转PDF实战对比,解析WorkBuddy AI智能体与大模型产品的本质差异,涵盖授权执行、积分消耗、场景适配与落地认知,帮你判断Agent工具是否适合当前工作流。
GrokBot之父:月合千个PR,智能体自动合并的工程心法
SpaceX背景AI工程师分享GrokBot工作流:一个月合入约千个PR,智能体自动合并20个。核心方法论围绕验证技能、EVAL测试、Dune架构与硬性CI约束,揭示如何从本地信任走向云端代理自动化。
Bright Data评测:免费额度、AI智能体MCP服务器与定价
Bright Data 提供免费 5000 额度、开源 MCP 服务器及代理/抓取 API。了解其定价模式、AI 助手集成方式和合规注意事项。