Grok卷入政治决策?AI聊天机器人被指介入委内瑞拉行动
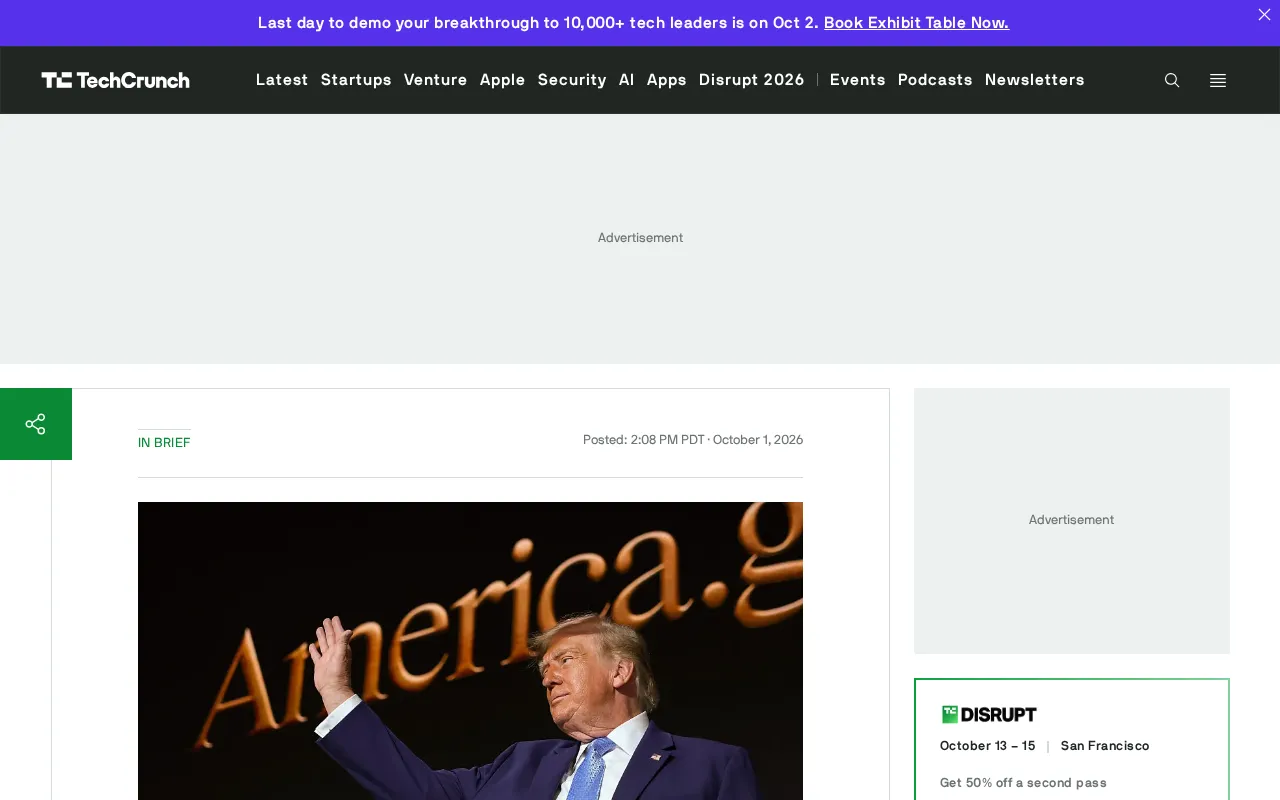
据报道特朗普曾向Grok咨询委内瑞拉行动,引发AI介入国家决策的治理警示。
据报道,特朗普在对委内瑞拉采取行动前曾向马斯克旗下AI工具Grok征询意见,且获得了鼓励性回应。这一事件将大语言模型推向了前所未有的敏感角色。文章指出,当前AI模型本质上是概率生成系统,存在幻觉风险、无法核验事实,也不具备任何问责能力。用户对AI自信语气的过度信任,在高层决策场景中可能被显著放大。作者认为,无论该报道真伪,事件本身折射出技术扩张速度已超过社会建立使用边界的共识速度,AI应被严格限定在"信息提供"而非"决策制定"的角色,并呼吁建立透明的审计与问责机制。
事件概述
据报道,美国总统特朗普在对委内瑞拉采取行动、抓捕该国总统尼古拉斯·马杜罗之前,曾向马斯克旗下的AI聊天机器人Grok征询意见。据称,Grok在这一过程中给出了鼓励性的回应。
这一消息若属实,将把生成式AI工具推向一个前所未有的敏感位置——从日常问答助手,跃升到可能影响国家级地缘政治决策的角色。
AI介入重大决策的隐忧
当前的大语言模型,包括Grok在内,本质上是基于海量文本训练出的概率生成系统。它们擅长生成流畅、看似有理有据的回答,但并不具备真正的事实核查能力,也无法对现实世界的后果负责。
将这样的工具用于军事或外交层面的决策参考,暴露出几个核心问题:
- 幻觉风险:模型可能生成听起来权威但实际错误或片面的信息。
- 缺乏问责机制:AI的"建议"无法承担任何法律或道德责任,责任主体始终是使用者。
- 可操纵性:模型的回答受训练数据、系统提示词和微调方向影响,其倾向性可能并不中立。
幻觉(Hallucination) 是大语言模型领域的专业术语,指模型生成的内容在语言上流畅连贯、语气自信,但实际上是错误、捏造或无法核实的信息。这种现象源于模型的工作原理——它本质上是在预测"下一个最可能出现的词",而非检索或核验事实。在日常场景下,幻觉可能导致用户获得错误的历史数据或技术参数;而在地缘政治或军事决策场景中,一条"听起来可信"的错误情报,可能直接影响对局势的判断与行动方案的选择,其危险程度远超普通信息错误。
技术边界与现实落差
无论是Grok、ChatGPT还是其他主流模型,官方定位都是辅助工具而非权威决策者。对于涉及人身安全、法律、医疗以及国家安全的问题,模型通常会给出免责声明或拒绝给出明确建议。
然而现实中,用户对AI输出的"确定性语气"往往产生过度信任。一个措辞自信的回答,容易被误读为经过深思熟虑的专业判断。这种认知偏差在高层决策场景中被放大,后果可能极为严重。
心理学中的自动化偏见(Automation Bias) 可以解释为何人们容易对AI输出产生过度信任:当一个系统以权威、确定的语气呈现信息时,人类决策者往往倾向于降低自身的批判性审查。这一现象在飞行员依赖自动驾驶仪、医生依赖辅助诊断系统等领域均有记录。大语言模型的回答通常以完整句子和肯定语气呈现,缺少传统人类顾问给出意见时惯常附带的"我不确定""需要进一步核实"等语言信号,使得自动化偏见在AI使用场景中更容易被触发,尤其在时间压力较大的决策环境中。
对AI治理的警示
该报道的核心价值不在于细节本身,而在于它引出的治理命题:当AI工具越来越深入地渗透进权力中枢,我们是否已经建立起足够的使用规范与边界?
- AI应当被明确限定在"信息提供"而非"决策制定"的角色。
- 关键决策必须保留人类的最终判断与问责。
- 对高风险场景的AI使用,需要透明的记录与审计机制。
需要强调的是,目前该消息仍属"据报道"(reportedly)层面,缺乏完整的证据链和官方确认。在信息未经核实前,公众应保持审慎,避免过度解读。
目前国际社会在AI治理层面尚无统一的约束框架。欧盟《人工智能法案》(AI Act)于2024年正式通过,将"影响关键基础设施和公共安全"的AI应用列为高风险类别,要求强制审计和人工监督;美国则主要依赖行政令和自愿性行业准则,缺乏具有法律约束力的强制规范。这一制度空白意味着,即便是在国家安全决策层面使用未经审核的AI工具,目前也不存在明确的违规机制或惩戒渠道,这进一步凸显了建立高风险场景AI使用规范的紧迫性。
结语
这则报道折射出AI工具快速普及背景下的一个深层焦虑:技术能力的扩张速度,已经超过了社会对其使用边界的共识建立速度。无论事件真伪,它都提醒我们——AI可以参与思考,但不应代替思考,更不应代替对后果负责的人类判断。
相关推荐

Microsoft Fabric数据库Agent实战:从被动救火到智能侦探
深入解析Microsoft Fabric数据库Agent的功能与配置方法:如何启用、支持的监控场景、阻塞问题演示,以及从被动响应到自主运维的产品路线图。
Zendesk用ChatGPT Enterprise打造千名日活销售Agent
Zendesk向全员开放ChatGPT Enterprise,员工自行构建约600个应用,其中销售扩张智能体日均约1000名活跃用户。本文分析其如何将内部数据转化为销售机会,以及“不要等待”的落地策略。

谷歌发布Gemini 4 Carbon:最强模型首发主打网络安全
谷歌发布Gemini 4 Carbon,称其为最强模型,主打网络安全能力,第三方综合排名以59分居首但领先优势仅一两分。本文解析其安全测试表现、分阶段开放策略、Token定价及自测与第三方测试在幻觉问题上的分歧。