GRP-Obliteration:单个提示词即可解除大模型安全对齐

GRP-Obliteration声称用单个无标注提示词即可解除大模型安全对齐,再度暴露开源权重防护的脆弱性。
GRP-Obliteration是一项宣称能以"单个未标注提示词"完成大模型去对齐的技术,在Hacker News引发关注。它呼应了此前abliteration方法的思路——通过定位并消除模型权重中与拒绝行为相关的方向向量来绕过安全限制——但将所需数据压缩至极致。这再次揭示开源权重模型安全对齐的本质困境:一切在权重层面施加的防护理论上均可被逆向剥离。文章同时指出,该工作目前在Hacker News上几乎没有社区讨论与验证,具体实现细节尚不透明,应作为值得持续跟踪的研究线索而非成熟威胁来理性看待。对从业者而言,核心启示是:不能将对齐微调视为唯一安全屏障,需转向数据过滤、能力限制与分发治理的多层防御体系。
一个提示词就能击穿大模型的安全防线?
近日,一项名为 GRP-Obliteration 的技术出现在 Hacker News 上,其副标题极具冲击力:"Unaligning LLMs with a Single Unlabeled Prompt"(用单个未标注的提示词解除大模型的对齐)。这项工作触及了当前大语言模型(LLM)安全领域最核心的软肋——所谓的"安全对齐"究竟有多牢固。
对齐(Alignment)是指通过 RLHF、DPO 等训练手段,让模型学会拒绝有害请求、遵循人类价值观。而"去对齐"(Unalignment / Obliteration)研究则试图揭示:这层看似坚固的防护,可能只是覆盖在原始模型能力之上的一层"薄漆"。
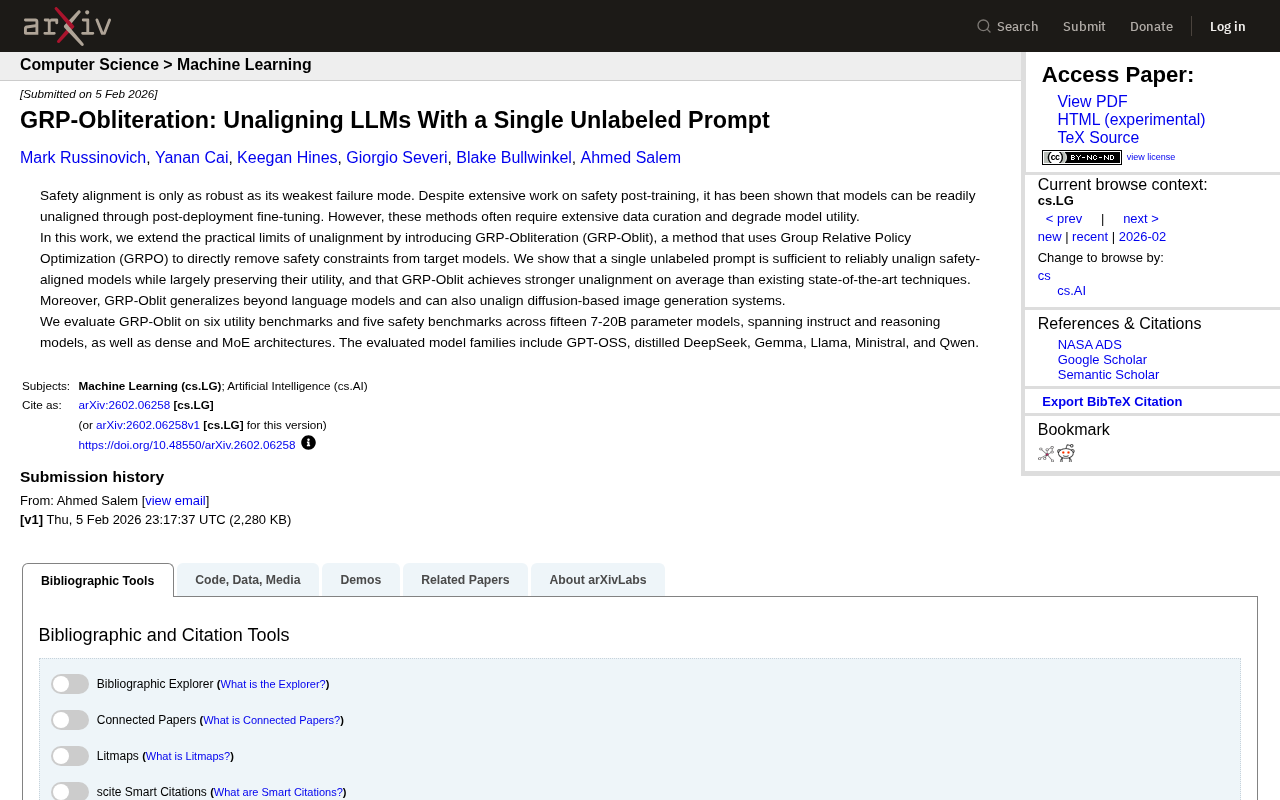
GRP-Obliteration 的核心思路
从命名来看,这项技术的关键词有两个:GRP(很可能指代 Group Relative Policy 一类的强化学习优化范式)与 Obliteration(抹除)。后者呼应了此前学界广为讨论的 "abliteration"(消融)方法——通过识别并移除模型内部与"拒绝行为"相关的特定方向向量,从而让模型不再触发安全拒答。
真正引人注目的是其宣称的门槛:只需一个未标注的提示词(single unlabeled prompt)。传统的越狱或去对齐方法往往需要成对的有害/无害数据、大量对比样本,或精心设计的对抗前缀。若这项技术真能仅凭单条无标签提示就完成对齐移除,意味着攻击成本被压到了极低的水平。
为什么"单提示词"如此关键
安全研究中,攻击的"数据依赖"程度往往决定了其现实威胁等级。需要成千上万条标注样本的方法,实施门槛高、可复现性差;而一个无需标注、无需大规模数据的方法一旦成立,几乎任何拿到开源权重的人都能复现。这也正是此类研究引发关注的原因——它衡量的不是"能不能破防",而是"破防有多容易"。
Abliteration(消融)方法由 Maxime Labonne 等研究者于2024年提出并推广,其核心原理是:通过在模型残差流(residual stream)中寻找"拒绝方向"(refusal direction)——即一个在有害/无害提示激活值之间系统性差异最大的线性方向——然后将该方向从模型的权重矩阵中正交投影消除。操作上,研究者只需收集少量有害与无害提示,提取各层的激活差异,拟合出这一方向向量,再修改 Attention 和 MLP 权重使其对该方向"失明"。整个过程无需重新训练,仅做权重编辑即可完成。实验表明,经过 abliteration 处理的模型在常规能力测评上几乎不退化,但拒绝有害请求的概率大幅下降。这说明"对齐"可能主要储存在权重空间的少数维度中,而非弥散于整个模型。GRP-Obliteration 若能将这一流程压缩至单个无标注提示词,意味着连"收集有害/无害对比样本"这一步也被省去,攻击门槛进一步降低。
在大模型安全评估框架中,攻击方法通常按"访问级别"分类:黑盒攻击(只能通过 API 调用)、灰盒攻击(可访问 logits 或嵌入)和白盒攻击(完全访问权重)。GRP-Obliteration 属于白盒攻击范畴,针对的是已公开权重的开源模型(如 LLaMA、Mistral 系列)。值得注意的是,白盒攻击本身并不新鲜,但其威胁等级取决于"操作复杂度":早期的 GCG(Greedy Coordinate Gradient)等对抗攻击需要数千步梯度优化;而权重编辑类方法将门槛压至普通用户可操作的范围。若 GRP-Obliteration 真正做到单提示词驱动,则意味着即便不具备深度学习工程能力的用户,也可能通过一行调用完成去对齐,这是威胁等级跃升的关键节点。
对开源模型安全的深层拷问
这类研究反复印证了一个业界共识:开源权重模型的安全对齐是可逆的。一旦模型权重公开,任何在权重层面施加的安全约束理论上都可以被针对性地剥离。GRP-Obliteration 若成立,将进一步压缩"移除对齐"所需的资源和技术门槛。
这带来一个绕不开的矛盾:开源推动了透明、可审计与创新,但也让"对齐即安全"的假设变得脆弱。对模型发布方而言,仅靠对齐微调无法阻止恶意使用者恢复模型的原始能力;真正的防护可能需要转向数据源头的过滤、能力本身的限制,以及分发环节的治理。
攻击研究的双刃剑属性
值得说明的是,这类工作在学术语境下多以"红队"(red-teaming)和安全评估的名义出现。研究者揭示脆弱性,目的往往是推动更鲁棒的防御机制。理解攻击面,才能构建更有针对性的防御。但同样没错,公开的低成本去对齐方法本身也构成了潜在的滥用风险,这也是社区在讨论此类成果时始终存在的伦理张力。
从防御视角看,业界已提出若干应对开源权重被恶意修改的思路。其一是能力蒸馏分离:将真正危险的原子能力(如合成生化武器的详细步骤)在预训练数据阶段就加以过滤,而非在微调阶段"压制"——因为压制可以被逆转,但从未学到的知识无法被"解锁"。其二是数字水印与溯源:在权重中嵌入难以消除的指纹,使恶意改版可被追踪。其三是分级开放:仅开放量化或剪枝后的推理端权重,而非完整的全精度权重,增加权重级攻击的难度。然而这些方案各有代价:数据过滤可能损害模型的正常用途;水印研究尚不成熟;分级开放与开源精神存在根本张力。这也说明,单纯技术手段难以根治开源模型的安全困境,政策与社区规范层面的治理同样不可或缺。
信息有限下的理性看待
需要客观指出的是,本次 Hacker News 的信息量非常有限——帖子仅有 3 个点赞、0 条评论,尚未形成充分的社区讨论与验证。GRP-Obliteration 的具体实现细节、适用模型范围、实际效果的量化指标,以及它相较于已有 abliteration 方法的真正改进之处,都还有待原始论文或代码库的进一步佐证。
因此,在缺乏同行评审和独立复现的情况下,宜将其视为一个值得关注的研究方向线索,而非已被证实的成熟威胁。对从业者的建议是:持续跟踪权重级安全攻击的进展,在部署开源模型时不要将对齐微调当作唯一的安全屏障。
小结
GRP-Obliteration 再次把"LLM 安全对齐的稳固性"这一命题摆到台前。无论其最终效果如何,它所指向的问题都真实存在:当模型权重可获取时,安全防护需要更系统的多层设计。对于开源生态而言,如何在开放与安全之间取得平衡,仍是一道没有标准答案的难题。
相关推荐
AI Agent开发四阶段学习路线:从入门到企业级实战
AI Agent开发零基础学习路线全解析:从核心概念、ReAct范式,到多智能体协作、Prompt调优与企业级实战项目,系统掌握规划、记忆、工具调用、RAG与MCP,帮你少走弯路成为AI核心人才。
DeepSeek Harness 新玩法:Agent 监督 Agent 的自进化实验
一位 B 站 UP 主基于 DeepSeek Harness 实现「Agent 监督 Agent」的自进化实验:用官方原版 DSH 作稳定监督者,驱动自研 Agent 完成任务并自动修复 bug,配合台账机制和 CDP、Chrome DevTools MCP 实现近乎无人值守的软件迭代。
用DeepSeek+3款工具,5分钟生成专业PPT
手把手教你用DeepSeek生成PPT大纲,再通过通义、Kimi、扣子三款免费AI工具一键生成专业PPT,5分钟搞定演示文稿,附完整实操步骤。