谷歌Android XR智能眼镜上手:隐私设计比Meta更主动
谷歌Android XR智能眼镜以预防式隐私设计和Gemini体验,向Meta发起正面挑战。
谷歌联合三星、Warby Parker和Gentle Monster推出Android XR智能眼镜,上手体验显示其在隐私设计上采取主动预防策略:只要传感器即将保存数据,隐私灯就会亮起,规则同样覆盖可能涉及视频的Gemini请求;人脸图像在上传云端前即被模糊化,Gemini因此无法识别具体人物。谷歌还承诺数据不用于AI训练和广告定向,并限制遮挡隐私灯的配件推广与骚扰性视频传播。在AI体验上,Gemini的对话自然度、纠错与不确定性表达能力在演示中优于Meta AI。体验者认为,智能眼镜的真正瓶颈是文化接受度而非技术,更多竞争有望让隐私被推到产品设计更前排。
谷歌带着Android XR杀入智能眼镜战场
智能眼镜赛道即将迎来一位重量级选手。在体验了来自Google、Samsung、Warby Parker和Gentle Monster联合打造的Android XR智能眼镜后,一个直观感受是:Meta在这个领域将面临真正的竞争压力。
这款产品在硬件上由三星参与打造,外观设计则拉来了Warby Parker和Gentle Monster两个时尚眼镜品牌背书,试图摆脱早期智能眼镜"科技感过重"的刻板印象。但真正让它在体验中脱颖而出的,不是造型,而是隐私设计上的主动姿态。
据该YouTube频道的上手体验,谷歌在隐私问题上采取的是"预防式"策略,而非Meta那样在争议出现后再被动调整。这种思路差异贯穿了整场演示。
隐私机制:灯光先亮,数据后动
智能眼镜最敏感的争议点始终是偷拍。谷歌保留了隐私指示灯,但关键改进在于触发逻辑:只要传感器即将以任何方式保存数据,指示灯就会亮起,而且这一规则同样适用于可能涉及视频画面的Gemini请求。
换句话说,隐私灯不再只是"摄像头正在工作"的提示,而是"数据即将被留存"的预警。对于一个随时可能调用云端AI的设备来说,这个边界划得更清楚。
另一个技术细节更有意思:眼镜会在数据上传云端之前,先对图像中的人脸进行模糊化处理。体验者在现场做了实测——让Gemini识别一张主编Nilay Patel的照片,结果Gemini直接表示无法做到,因为人脸已被出于隐私原因遮挡。
此外,谷歌明确表示这些数据不会被用于训练AI,也不会用于广告定向。
端侧处理与云端AI的边界
文中提到的“数据上传云端前先模糊人脸”,涉及智能眼镜架构中的一个关键分野:端侧计算(on-device)与云端推理(cloud inference)。智能眼镜受限于体积、功耗和散热,本地芯片通常只能承担唤醒词识别、简单图像预处理等轻量任务,而Gemini这类多模态大模型的推理仍需依赖云端。所谓“上传前模糊”,意味着人脸检测与打码必须在眼镜本地或配对手机的端侧完成,再决定哪些像素可以离开设备。这一机制的技术难点在于端侧算力与延迟的平衡:打码若不够快,会拖慢用户感知的响应速度;若不够彻底,则隐私承诺形同虚设。它也解释了为何Gemini“无法识别”照片中的人——模型收到的输入本身就已缺失可识别信息,而非模型被额外限制。
生态层面的"自断财路"
谷歌在隐私上的承诺不止于设备本身,还延伸到了商业生态。它表示愿意动用Google Shopping和Google Ads等产品,不推广、不投放那些专门用来遮挡隐私LED灯的镜头盖类产品。
YouTube作为谷歌旗下平台同样被纳入这一体系:由恶作剧者拍摄的、或可能用于骚扰女性的眼镜视频,会被平台下架。谷歌不希望在自己的社交媒体上助长这类行为。也正因如此,直播功能短期内不会在这款眼镜上提供——至少不会一开始就开放。
这种"用广告和平台规则给自己设限"的做法,在商业逻辑上并不划算,但恰恰说明谷歌试图把隐私打造成差异化卖点。
隐私LED为何成为行业争议焦点
智能眼镜上的隐私指示灯并非新事物,Google Glass时代就已存在,但围绕它的攻防从未停止。核心矛盾在于:指示灯是旁观者判断自己是否被拍摄的唯一可见信号,而用户又有动机用胶带、贴纸或第三方镜头盖将其遮挡。Meta Ray-Ban眼镜曾因指示灯亮度不足、易被改装而受到批评,这类配件在电商平台上也有流通。谷歌此次表态不推广、不投放遮挡类配件,实际上是在用平台权力为自己的硬件信任背书——因为一旦指示灯可被轻易绕过,整套隐私设计的社会契约就会瓦解。值得注意的是,这种自我约束依赖谷歌对Shopping和Ads的控制力,对其他厂商并无强制力,因此它更像是一种姿态而非行业标准。
Gemini在眼镜上的表现压过Meta AI
抛开隐私不谈,体验中另一个让Meta警惕的点是Gemini在眼镜端的实际表现。即便是在演示环节,对话的自然流畅度也已经拉开差距:可以像日常聊天一样来回交流,模型会更新信息,甚至能意识到自己的错误。
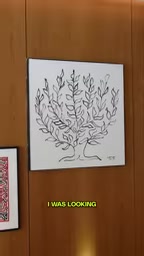
它会主动告诉你,当前拍摄的画面可能不足以得出准确结果。体验者对着马蒂斯的画作拍照时,Gemini表示看起来像马蒂斯的作品,但当前角度难以确认,建议靠近一些再看。
其他能力还包括:对着书本让它总结某一页内容,再把总结要点发送到消息应用里。体验者的评价是,这些功能Meta曾宣布"即将到来",但目前并未真正可用,而谷歌这边已经能在演示中跑通。
多模态模型在可穿戴设备上的交互范式
Gemini在眼镜端的表现,反映的是多模态大模型从“问答工具”向“环境感知助手”的转变。传统语音助手依赖单一语音输入,而眼镜场景天然携带第一视角画面、位置和动作信息,模型需要同时理解“用户看到了什么”和“用户想干什么”。文中Gemini主动指出当前角度不足以确认画作、建议靠近再看,体现的是模型对自身不确定性的表达(uncertainty expression),这是可穿戴AI体验的关键能力——设备屏幕极小甚至没有屏幕,模型必须用自然语言管理用户预期,而不是给出似是而非的答案。这种交互对延迟和上下文连续性的要求,也远高于手机上的单轮对话。
技术不是瓶颈,文化才是
体验者的一个判断值得玩味:智能眼镜的问题从来不在技术层面,而在于这是一个小众品类所面临的文化接受度问题。
正因如此,这个赛道出现更多竞争是好事。谷歌和Meta互相较劲的结果,可能会让隐私被推到产品设计的更前排,让产品本身变得更好。对用户来说,真正的赢家不是某一家公司,而是那个不必在"好用"和"不被偷拍"之间做选择的未来。
从这次上手来看,谷歌至少证明了一件事:智能眼镜的隐私设计可以从"出了事再补"变成"设计时就防"。剩下的问题,是这套理念能否在量产和真实使用场景中扛住考验。
相关推荐
Anthropic双版本登顶智能指数,API费降20%
Anthropic 发布 Fable 5.2 与 Mythos 5.2 双版本,同底座评测得分 65 登顶智能指数第一,API 调用费降 20%。同期 Google 新增两款第八代 TPU,Meta 推出主攻智能体重复任务的 Muse Ember,蚂蚁灵波开源触觉模型 Limbo Touch,Claude Code 被曝明文落盘敏感信息。
Anthropic发布Fable 5.2:号称全球最强AI模型
Anthropic发布Fable 5.2与Mythos 5.2,多项基准创纪录,科研任务提升显著。本文解析其基准表现、游戏与硬件实测、API定价,以及它究竟适合哪些用户。
Claude Fable 5.2实测:1000智能体30小时证明费马大定理
Claude Fable 5.2与Mesos 5.2发布:1000个AI智能体30小时形式化证明费马大定理,价格降20%、速度提升30%,在电路设计、物理、化学、运筹与网络安全任务中展现长链条工程能力,同时被主动限制AI自我改进。