H²R:用分层提示奖励提升数学推理

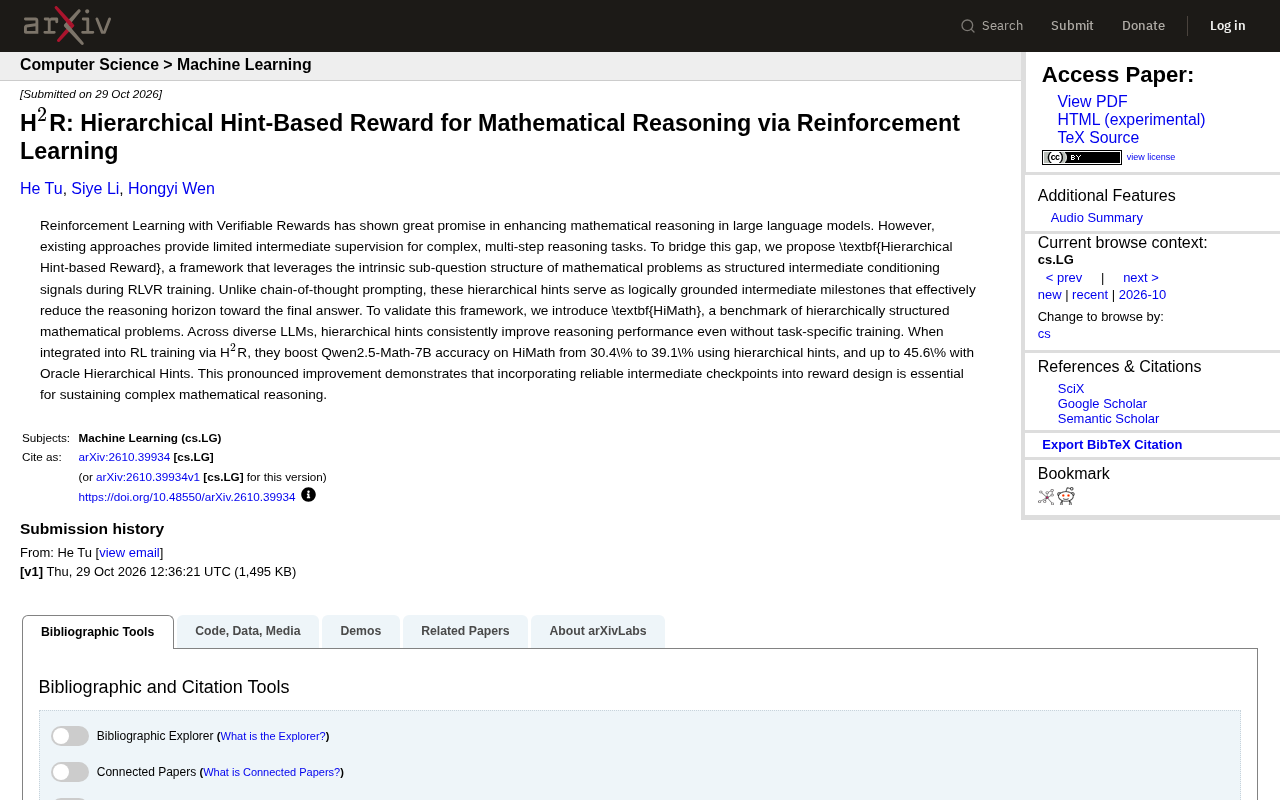
H²R 用数学题的子问题结构充当中间奖励,弥补 RLVR 稀疏奖励对多步推理监督不足。
论文针对 RLVR 仅依据最终答案发放奖励、难以监督多步推理中间步骤的问题,提出 Hierarchical Hint-based Reward(H²R)框架,利用数学题固有的子问题结构作为结构化中间条件信号,把每个子问题的答案变成可验证的检查点,从而缩短模型通向最终答案的推理跨度。作者同时构建分层数学基准 HiMath,使子问题结构的引导效果可被系统评测。实验显示,即使不做任务特定训练,分层提示也能在多种大模型上一致提升推理表现;集成进 RL 训练后,Qwen2.5-Math-7B 在 HiMath 上准确率显著提升,使用 Oracle 分层提示时增益更大。论文由此主张,把可靠中间检查点纳入奖励设计是维持复杂数学推理能力的关键。
强化学习正成为提升大语言模型数学推理能力的关键路径,但现有方法在中间步骤的监督上仍显薄弱。一篇新论文提出的 Hierarchical Hint-based Reward(H²R)框架,尝试用数学题固有的子问题结构作为结构化中间信号,为复杂推理提供更密集的引导。
问题:稀疏奖励难以支撑多步推理
Reinforcement Learning with Verifiable Rewards(RLVR)在数学推理任务上展现出巨大潜力,但它主要依赖最终答案的正确性来发放奖励。对于需要多步推导的复杂题目,这种稀疏奖励让模型难以判断中间步骤是否合理,推理路径的探索效率因此受限。
论文指出,现有方法对复杂、多步推理任务的中间监督有限。换句话说,模型只知道“最后答对了没有”,却不知道“哪一步走对了、哪一步走偏了”。这正是 H²R 想要填补的空白。
RLVR(Reinforcement Learning with Verifiable Rewards,可验证奖励强化学习)是近年针对数学、代码等有标准答案任务发展出的训练范式。它的核心在于奖励信号来自可自动判定的验证器——例如数学题用符号求解器比对最终答案、代码题用单元测试判定是否通过——而不依赖人类偏好标注或训练奖励模型。这一特性使 RLVR 具备可扩展、低成本的优点,在 DeepSeek广告-R1 等工作之后被广泛采用。但其代价也同样明显:验证器通常只对整条回答给出二值判断,奖励粒度过粗,对多步推理过程中的局部错误缺乏反馈,探索效率受限。H²R 正是在这一范式上叠加中间信号的改进。
H²R 的核心思路:把子问题变成里程碑
H²R 的关键设计,是利用数学问题内在的子问题结构,在 RLVR 训练过程中引入结构化的中间条件信号。与链式思维(chain-of-thought)提示不同,这些分层提示被定位为“有逻辑依据的中间里程碑”,其作用是有效缩短模型通向最终答案的推理跨度。
可以这样理解:一道多步数学题往往可以拆成若干递进的小问题,每个小问题的答案天然构成一个可验证的检查点。H²R 把这些检查点纳入奖励设计,让模型在训练中不仅对齐最终答案,也对齐中间推理的关键节点。论文强调,将可靠的中间检查点纳入奖励设计,是维持复杂数学推理能力的关键。
Oracle Hierarchical Hints 中的“Oracle”源于强化学习与序列决策中的 oracle 概念,指拥有完整信息或理想判断能力的参考者。在此语境下,Oracle 分层提示意味着由更强模型、标准解答或人工校验给出的、可信度接近上限的子问题检查点,而非由策略模型自身生成。它并不用于部署阶段,而是作为上界参照:用理想提示下的表现与自动生成提示下的表现对比,可以量化“提示质量”这一变量对奖励有效性和最终准确率的贡献,从而判断性能瓶颈究竟来自奖励设计还是来自提示生成。这种上界分析是评估中间监督方法时常用的诊断手段。
HiMath 基准:为分层结构提供评测土壤
为验证该框架,作者同时构建了 HiMath,一个由分层结构数学问题组成的基准。它的价值在于让“子问题结构”从抽象概念变成可评测的对象,使分层提示的效果能够被系统观察,而不再只是训练技巧层面的经验判断。
实验发现:分层提示本身就有增益
论文报告了一个值得关注的结论:在多种大语言模型上,即使不进行任务特定训练,分层提示也能一致地提升推理表现。这说明子问题结构所携带的引导信息具有跨模型的通用性,而非依赖特定模型的微调适配。
当分层提示被集成进 RL 训练、形成 H²R 之后,增益进一步放大。以 Qwen2.5-Math-7B 为例,使用分层提示后其在 HiMath 上的准确率明显提升;而采用 Oracle Hierarchical Hints(即提供更可靠的分层提示)时,准确率还能再上一个台阶。论文将这一显著提升视为对核心论点的直接支持:可靠的中间检查点对持续进行复杂数学推理不可或缺。
需要说明的是,Oracle 设定代表一种理想化的上界参考,它提示了分层提示质量对最终收益的影响方向——提示越可靠,奖励信号越有效。
链式思维(chain-of-thought)提示要求模型在给出答案前显式写出逐步推导,其作用是引导模型把计算摊开到多个 token 上,减少一步到位的推理负担,但提示本身并不携带关于“哪一步算对”的监督信号。H²R 所讲的分层提示则依附于题目固有的子问题分解:每个子问题的答案都是可独立核验的里程碑,因而能把一条长推理链切成若干段可打分的区间。两者的区别可以概括为:链式思维提供的是展开推理的格式,分层提示提供的是检查推理的位置;前者是输出层面的技巧,后者是奖励层面的结构,这也解释了为何分层提示可以在不做任务特定训练时单独带来跨模型增益。
启示:奖励设计正在从“看结果”转向“看过程”
H²R 的思路反映了一个更宏观的趋势:数学推理的强化学习正在从结果导向的稀疏奖励,转向过程感知的密集奖励。子问题结构是一种低成本、可验证、天然存在的中间信号,把它用于奖励设计,等于在不引入额外人工标注的前提下,为模型提供了更多可对齐的锚点。
当然,这条路仍有待回答的问题:分层提示如何自动生成、质量如何保证、在不同题型上的泛化边界在哪里,都是后续研究需要处理的方向。但至少从 HiMath 上的实验结果看,把中间检查点写进奖励函数,是一条值得继续投入的路线。
相关推荐
触屏MacBook与混乱的苹果:一场刻意为之的冒险
The Vergecast 深入讨论触屏 MacBook Pro 的发布逻辑、ProLed 命名争议、iPad 被 iPhone 与 Mac 两头挤压的困境,以及苹果在 AI 时代如何靠高端硬件维持竞争力。

研究权力50年:Robert Caro的写作与权力洞察
Robert Caro研究权力50年,在访谈中谈Lyndon Johnson的说服力与杠杆、Robert Moses从理想主义到冷酷的变迁、大规模建设的困境,以及传记写作中压缩主题与孤独专注的方法。

2万美元的机器人能替你干家务吗?实测结果令人意外
一段YouTube实测视频展示2万美元机器人如何响应洗碗、关灯、倒垃圾、喂狗等指令。本文分析其真实能力边界、语音交互技术现状,以及家务机器人距离普及还有多远。