哈佛大学揭秘:中国AI为何集体押注开源
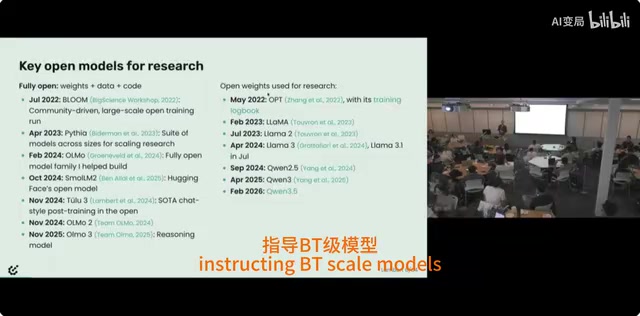
中国实验室密集发布开放权重模型,开源成为第二梯队获取用户的务实策略。
Nathan Lambert 在哈佛讨论中判断,开源模型已成为不可阻挡的力量,但 AI 圈关注度仍然偏低。中国实验室(DeepSeek、Kimi、GLM、Qwen 等)形成了全球最集中的开放权重模型阵营,动机包括 DeepSeek 的意识形态驱动,以及其他实验室作为第二梯队通过开放发布获取用户的务实策略。R1 发布和智能体能力突破是两个关键节点。许可证出现分化,越来越多公司设置收入门槛寻求推理市场分成。后训练栈成为开源模型进入企业的路径,但蒸馏争议和六个月差距是否重要仍是开放问题。
开源模型正在成为一股不可忽视的力量
在哈佛大学的一场讨论中,开源模型领域的资深研究者Nathan Lambert分享了他对中国AI生态的观察。他的核心判断是:开源模型已经是一股"不可阻挡的力量"——能够训练模型的机构越来越多,参与的 continents 越来越广,新的投资浪潮还会不断到来。他甚至直言,AI圈子里对开源模型的关注度"有点太低了"。
这个判断放在中国AI的语境下尤其成立。DeepSeek广告、Kimi、GLM、Qwen、MiniMax、小米……一批中国实验室在过去几年里密集发布开放权重模型,形成了全球开源AI版图中最集中的一股力量。Nathan Lambert的观察是,这背后既有意识形态的驱动,也有非常务实的商业计算。
开放权重不等于开源:一个被压缩的讨论
要理解中国AI的开源选择,先要厘清"开放"的层次。Lambert提醒,几年前开源模型社区最大的争论是"什么才算开源模型",如今讨论变得务实了一些:像Llama系列和中国模型这样可以直接下载权重的,属于"开放权重模型";而真正意义上的开源模型会释放训练所用的全部数据和代码。
后者对科研极其重要。很多博士生在完全开放的模型上做研究,但Lambert指出一个有意思的事实:这类完全开放的模型"历史上都来自美国而非中国",属于对基础研究基础设施的投资。中国实验室的主流选择是开放权重——权重可下载、细节不公开,但足以让生态快速扩散。
许可证是另一个容易被忽略的维度。DeepSeek多数模型采用MIT许可,GLM在近期之前也是如此,用户可以自由使用。但越来越多公司开始设置"收入门槛":想在自有基础设施上部署Kimi或GLM 5.2,需要单独签协议。Lambert认为,这是中国公司试图从美国 inference 市场中分得收入分成的一种实验,而出口管制和实体清单会给这类商业合作带来很大的不确定性。
开放权重模型(Open-weight model) 指模型参数可公开下载、允许用户自行部署和微调的模型,但训练数据、训练代码和完整训练流程通常不公开。它与严格意义上的开源模型(Open-source model)有本质区别:后者遵循开源定义,要求释放训练数据、代码和可复现的训练细节。开放权重降低了使用门槛,使生态快速扩散,但无法满足学术研究对可复现性和透明度的需求。因此,开放权重常被视为商业策略工具,而非科研基础设施。
Copyleft 许可 是自由软件运动中的一种许可机制,要求修改后的衍生作品必须沿用相同许可条款发布,从而保证自由流通。与之相对,宽松式开源许可(如 MIT、Apache 2.0)允许衍生作品闭源使用。开源 AI 社区在许可证选择上的分歧,本质上就是这两种理念的延续:是优先保证下游自由,还是优先扩大采用范围。
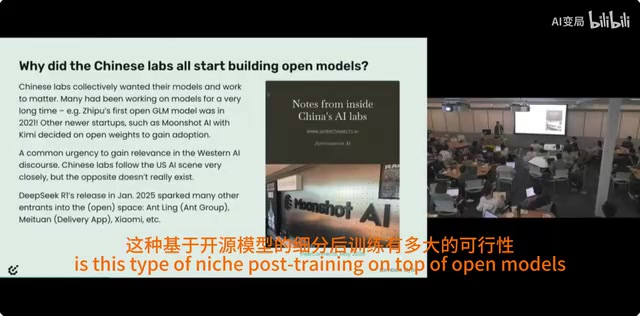
中国实验室为什么选择开源?
这是整场讨论中最核心的问题。Lambert给出的解释是多层次的,并非单一动机。
意识形态:DeepSeek的特殊性
Lambert认为DeepSeek"很可能在意识形态上就是认真的"——真正相信开源超级智能这条路。他用一个细节佐证:DeepSeek背后是量化基金,创始人已经足够富有,"不需要赚钱"。但这不代表DeepSeek没有商业回报,其推理服务的收入数据显示这块业务相当可观。
务实主义:第二名的唯一打法
对其他中国实验室,Lambert的判断更冷静:"作为第二梯队的玩家,让别人用我们模型的唯一方式就是开放发布,把成本压到最低,尽可能送到更多人手里。"这句话点出了开源在中国的商业逻辑——不是情怀,而是获取用户的必要手段。
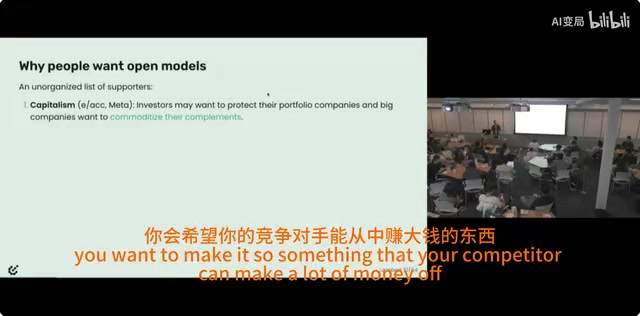
他把这归结为一个更普遍的科技行业规律:"商品化互补品"。Meta开源Llama的算盘是让AI变便宜,从而让自己在推荐引擎、聊天机器人等业务上赚更多;VC们追捧开放权重,是因为错过了投资OpenAI,如今手里有一堆需要便宜智能的互补产品。中国公司的逻辑类似,只是处境更急迫。
生态拐点:R1与智能体时刻
时间线上有两个关键节点。第一个是2025年夏天,Lambert观察到"有这么多中国实验室在做这些模型"成为普遍认知;很多团队原本就有大型技术团队,DeepSeek R1发布后决定做LLM,六到九个月内就推出了大模型。
第二个节点是R1之后,AI在中国真正走向主流——此前中国没有经历美国那种"每个网站都加个聊天机器人"的阶段。而更近的一次跃迁是智能体能力:Claude Code带动的智能体浪潮中,GLM 5.2和Kimi K3等开源模型开始具备"真正好用"的开放智能体行为,直接点燃了一轮经济热潮,也带来了今天要辩论的网络安全风险。
智能体(Agent)能力 指模型不仅能生成文本,还能自主规划、调用工具、执行多步骤任务并与外部环境交互的能力。与传统对话模型相比,智能体模型需要更强的推理、工具使用和错误恢复能力。Claude Code 等产品的出现推动了这一方向,而开源模型在智能体行为上的成熟,意味着用户可以在自有基础设施上部署可执行复杂任务的 AI 系统,这对企业和开发者具有显著吸引力,也带来了新的安全与监管挑战。
自建智能:美团、蚂蚁的另一种开源
Lambert特别提到一类中国玩家:美团(类似DoorDash)和蚂蚁集团(中国最大的金融科技公司)。它们的做法是训练一个通用模型并开放权重,再针对自己的智能体场景做微调——本质上是"拥有自己的智能"。开放权重让更多人了解并构建在其技术栈上,同时它们本来就要建模型来支撑自家产品,开源与否可能并不影响成本账。
这种模式可持续性"存疑",因为开放权重本身赚不到多少钱,但对这些公司来说,省下的是向DeepSeek等公司支付巨额API费用的钱。Lambert也提醒,中国企业对软件付费的意愿传统上偏低,SaaS市场的发展路径与美国很不一样,这会影响开源模型的变现空间。
后训练产业与蒸馏争议
开源模型如何进入企业?Lambert认为路径是后训练。他观察到"每个 needle lab 都在收敛为开源计算、数据、RL环境、评估和后训练栈"的组合,因为这是开放模型触达拥有专有数据的企业的方式——这些企业不愿把数据交给前沿实验室。他不认为多数这类公司会成功,真正稀缺的是严谨的评估设计与后训练集成能力。
关于"中国模型只是蒸馏美国模型"的指控,Lambert承认这是个"大问题",但他同时强调中国实验室"非常擅长造模型"。他更愿意把问题引向另一个方向:随着前沿模型能力继续提升,六个月的差距是否还重要?他的判断带着一点哲学意味——"我不认为智能可以走向无限"。
后训练(Post-training) 指在预训练基础模型之上,通过监督微调、强化学习、偏好对齐等手段,使模型适应特定任务或领域的过程。对于开源模型而言,后训练是企业将专有数据与开放权重结合的关键路径:企业无需从零训练模型,只需在开源权重上做后训练即可获得定制化能力,同时避免将数据交给前沿实验室。后训练栈通常包括数据管理、计算资源、强化学习环境、评估体系和集成工具,其成熟度直接决定开源模型能否在企业场景中落地。
模型蒸馏(Distillation) 指用一个强大模型(教师模型)的输出训练另一个模型(学生模型),使学生模型以更低成本获得接近教师模型的能力。在开源 AI 语境中,蒸馏争议在于:中国开放权重模型是否大量使用了美国前沿模型的输出作为训练数据,从而以较低成本缩小能力差距。这一做法在技术上普遍存在,但涉及许可证条款和数据使用伦理,因此成为竞争与政策讨论的焦点。
一个分散且难以协调的社区
开源AI社区并非铁板一块。Lambert列举了支持开放模型的多种动机:资本主义与竞争、对科学进步的信念、反权力集中的安全考量、以及自由软件运动延续下来的自由主张。这些人在X上"经常和同为开源支持者的我大吵一架",这种去中心化带来思想多样性的好处,也让社区很难在政策建议上形成合力。
他还讲了一段开源史:自由软件运动催生了copyleft许可,要求修改后的作品保持自由流通,很多公司不愿接受这种下游约束;开源则是更务实的折中。这段历史对理解今天开源AI的许可证之争仍有参考价值。
竞争格局仍在快速变化
Lambert用扎克伯格的例子说明这个领域变化之快:一篇阐述开放模型为何是前进之路的博客,一年后就变成了"我们其实不会那么开放"的个人超级智能备忘录。
中国这边同样在洗牌。小米是被点名"正在上升"的实验室,挖来了DeepSeek的罗立(音)领军,其开放权重模型在Artificial Analysis指数上占据榜首数月。MiniMax则被认为是最"BenchMax"的中国实验室,产品成功或许比模型本身更重要。而DeepSeek凭借最新模型"又回到了最高点"——极其便宜且性能很强。
Lambert的收尾带着一丝紧迫感:本周可能还会有新的多万亿参数顶级模型发布,叠加在已经足够多的风险讨论之上。对中国AI的开源选择,这既是机会,也是一道尚未有答案的经济学试题。
相关推荐

Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。

AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。