Harbor:统一80+基准的AI Agent评估框架详解
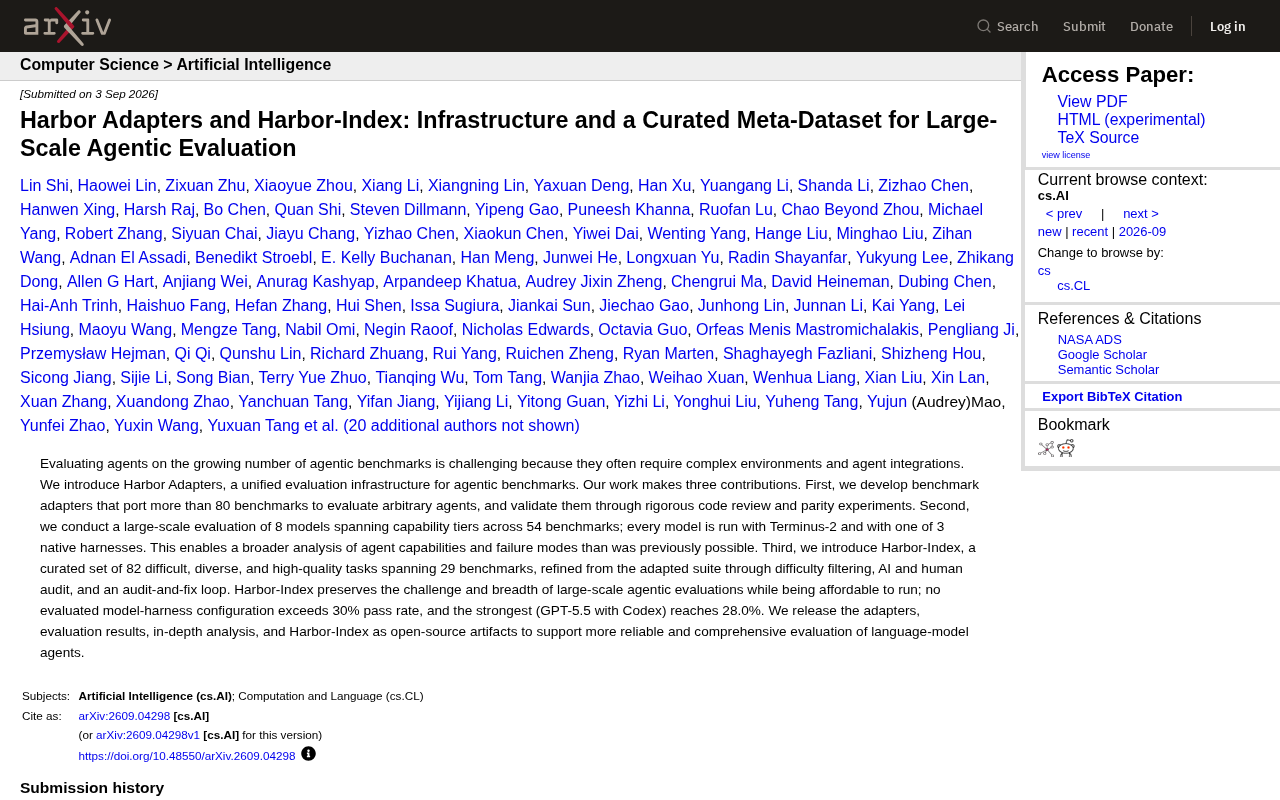
Harbor通过统一适配器整合80+基准、大规模交叉评估与高质量元数据集,为AI Agent评估提供标准化基础设施。
Harbor是一项旨在解决AI Agent评估碎片化问题的系统性工程,由Harbor Adapters、大规模交叉评估实验和Harbor-Index三部分构成。Harbor Adapters通过统一适配器层将超过80个异构基准测试纳入同一框架,消除了为每个基准单独搭建环境的重复工作。基于此基础设施,研究团队完成了8个模型×54个基准的大规模评估,发现即使最强的GPT-5.5配置通过率也仅为28%,揭示了当前Agent技术的普遍局限。Harbor-Index则从中提炼出82个经严格筛选的高难度任务,作为高区分度的标准评测集供社区使用。三大组件全部开源,有望推动行业评估标准化。
Harbor:统一80+基准的AI Agent评估框架详解
随着AI Agent技术的快速发展,如何系统化地评估其能力成为行业难题。来自arXiv的最新研究论文提出了Harbor Adapters和Harbor-Index,为大规模Agent评估提供了统一的基础设施和高质量元数据集。
AI Agent评估面临的碎片化难题
当前AI Agent评估面临的核心挑战在于基准测试的碎片化——每个benchmark都需要特定的环境配置和集成方式,这使得跨基准比较变得异常复杂。Harbor Adapters通过开发统一的适配器层,成功将超过80个基准测试移植到可评估任意Agent的框架中。
研究团队采用了严格的代码审查和对等实验来验证适配器的准确性。这意味着开发者无需为每个基准重新构建评估环境,而是可以通过标准化接口进行测试。这种设计理念类似于软件工程中的适配器模式,将异构系统抽象为统一接口。
大规模实证研究:8模型×54基准的交叉评估
基于Harbor基础设施,研究团队开展了迄今为止最大规模的Agent能力评估实验之一。他们选取了跨越不同能力层级的8个模型,在54个基准测试上进行评估,每个模型都使用Terminus-2或三种原生harness之一运行。
这种大规模交叉评估揭示了以往单一基准测试无法发现的模式:
- 不同模型在特定任务类型上表现出显著差异
- 某些失败模式跨模型普遍存在
- 即使是最强的配置(GPT-5.5配合Codex)在Harbor-Index上的通过率也仅为28.0%
这些发现表明,当前AI Agent技术距离通用智能还有相当距离。
Harbor-Index:82个精心筛选的高质量评估任务
Harbor-Index是研究的第三个核心贡献——一个包含82个精心策划的高难度任务集,跨越29个基准测试。这个元数据集的构建经历了多轮严格筛选:
- 难度过滤:排除过于简单的任务,确保对现有模型构成真正挑战
- AI与人工双重审核:双重审核机制保证每个任务的质量和评测意义
- 审核-修复迭代循环:发现问题后进行持续优化,直至达到质量标准
最终的Harbor-Index在保持评估广度和挑战性的同时,大幅降低了运行成本。关键指标显示,所有被评估的模型-harness配置在Harbor-Index上的通过率均未超过30%,充分证明了数据集的高区分度和实际价值。
全面开源:推动Agent评估行业标准化
研究团队将所有适配器、评估结果、深度分析报告以及Harbor-Index作为开源资源发布。这种开放策略有望加速Agent评估方法的标准化进程。
对于AI研究者和开发者而言,Harbor提供了三个直接价值:
- 降低评估门槛:无需为每个基准单独搭建环境,统一框架即可完成测试
- 结果可比性:统一框架确保跨研究、跨团队的公平比较
- 高质量基准参照:Harbor-Index可作为模型开发的北极星指标
总结与展望
这项工作表明,AI Agent评估正在从分散的单点测试走向系统化的基础设施建设。Harbor通过统一适配器整合80+基准、大规模交叉评估揭示能力短板、高质量元数据集提供评测标杆这三大支柱,为行业树立了新的评估范式。随着越来越多基准被纳入Harbor生态,研究社区将获得对Agent能力更全面、更可靠的认知。
相关推荐
本地部署私人DeepSeek全攻略:联网+知识库+隐私安全
手把手教你用Ollama、Chatbox、AnythingLLM搭建纯本地、可联网、带知识库的私人DeepSeek。涵盖蒸馏版模型选择、RAG知识库原理与API调用,隐私安全零门槛部署全流程干货。
AI Agent开发四阶段学习路线:从入门到企业级实战
AI Agent开发零基础学习路线全解析:从核心概念、ReAct范式,到多智能体协作、Prompt调优与企业级实战项目,系统掌握规划、记忆、工具调用、RAG与MCP,帮你少走弯路成为AI核心人才。
DeepSeek Harness 新玩法:Agent 监督 Agent 的自进化实验
一位 B 站 UP 主基于 DeepSeek Harness 实现「Agent 监督 Agent」的自进化实验:用官方原版 DSH 作稳定监督者,驱动自研 Agent 完成任务并自动修复 bug,配合台账机制和 CDP、Chrome DevTools MCP 实现近乎无人值守的软件迭代。