黑客逆向三星电视,发现板载AI监听与OpenAI账号封禁

黑客逆向三星电视称发现板载AI监听,OpenAI账号被封引发隐私与风控争议。
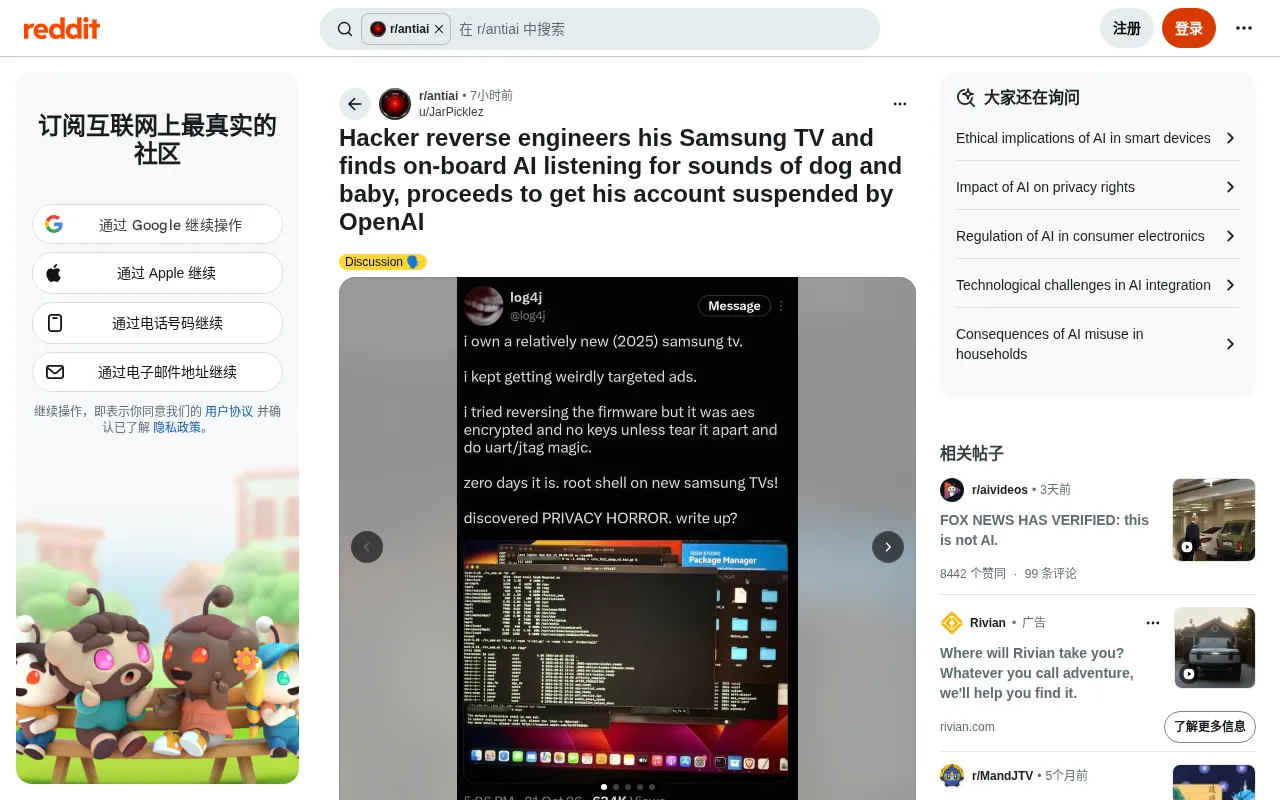
一名黑客在Hacker News发帖称,对三星智能电视固件逆向后发现板载AI组件与音频采集链路存在关联,暗示音频可能在唤醒词之外被本地AI处理后上传云端,且其关联的OpenAI账号在探索过程中被封禁。事件迅速从技术拆解转向对厂商安全策略与隐私边界的质疑。但文章强调,该发现仅有单一来源描述,缺乏固件镜像、流量抓包或官方回应的交叉验证,社区讨论以追问细节和谨慎观望为主。文章进一步分析了智能电视长期带电带麦克风的隐私困局,并为研究者提出使用隔离环境、独立账号、保存完整证据链及标注证据强度等实操建议,指出核心命题是用户有权知道AI听到了什么、数据去了哪里。
事件起源:一次电视逆向工程引发的隐私警报
在Hacker News社区引发讨论的一则帖子中,一位黑客对三星智能电视进行了逆向工程分析,声称在设备固件层面发现了常驻的AI监听机制。据帖子描述,该电视内置的AI功能并不像官方宣传的那样仅在唤醒词触发后工作,而是存在某种形式的后台音频处理行为。更令社区关注的是,该黑客在探索过程中关联到的OpenAI账号随后遭到封禁,这一巧合让讨论迅速从技术拆解转向了对厂商安全策略和隐私边界的质疑。
需要说明的是,目前这一事件仅有单一来源的帖子描述,缺乏固件镜像、流量抓包或官方回应的交叉验证。Hacker News上的53个点和8条评论表明讨论仍处于早期阶段,社区反应以谨慎观望和追问技术细节为主,而非一边倒的定论。
逆向分析透露的技术细节
板载AI与音频处理路径
据发帖人描述,逆向工作集中在电视的固件与本地服务层。其核心发现是设备上存在与AI推理相关的组件,且这些组件与音频采集链路存在关联。传统智能电视的语音助手通常依赖唤醒词检测(如低功耗DSP常驻监听特定关键词),而该黑客暗示三星的实现可能更复杂——音频数据在本地AI模块处理后,可能被送往云端做进一步分析。
从工程角度看,智能电视的麦克风常驻本身并不新鲜。争议点在于透明度和数据流向:用户是否被明确告知音频数据的处理范围,以及本地处理与云端上传之间的边界在哪里。帖子并未提供完整的调用栈或数据包证据,因此这一发现更应被视为待验证的技术线索,而非已确证的监听行为。
唤醒词检测(Wake Word Detection) 是智能音箱和电视语音助手中常见的低功耗常驻监听技术。其典型实现是将一个极小的神经网络模型(如几十KB量级的关键词识别模型)固化在专用的低功耗DSP或协处理器上,该芯片持续以极低功耗运行,仅对音频流做本地关键词匹配(如“Hi Bixby”“Alexa”),未命中时音频数据不离开芯片、也不进入主处理器。只有检测到唤醒词后,主SoC才被唤醒并开始完整的语音识别与云端上传流程。理解这一架构很重要,因为争议的核心正是:三星的实现是否偏离了“唤醒词之前音频不出芯片”这一行业惯例,以及所谓的“本地AI模块”是否扩大了音频数据的处理范围。
OpenAI账号封禁的连锁反应
发帖人提到其OpenAI账号在探索过程中被暂停使用。这一细节之所以引发关注,是因为它暗示了要么存在自动化风控对异常API调用的误判,要么是厂商与AI服务商之间存在某种联动机制。从公开信息看,OpenAI对违反使用政策的账号有封禁机制,但通常针对滥用、自动化爬取或违规内容生成。将电视逆向行为与账号封禁建立因果链,目前只是发帖人的推测。
社区评论中有观点认为,更可能的解释是逆向过程中产生的异常请求触发了风控规则,而非针对研究行为的定向打击。无论哪种情况,这都提醒研究者:在涉及联网AI服务的硬件逆向时,需要使用隔离环境和独立账号,避免个人账号因异常流量被误伤。
API风控与异常流量检测 是云服务商识别滥用行为的常见机制。OpenAI等平台会对账号的请求频率、来源IP、请求模式、并发量等特征做实时评分,一旦偏离正常使用基线(例如短时间内来自陌生IP的高频调用、自动化脚本特征明显的请求序列),就可能触发自动封禁或限流。这类系统通常不区分“恶意攻击”与“善意研究”,只要行为模式异常即可能误伤。因此,硬件逆向过程中若复用了个人账号去调用云端AI接口,被风控拦截是可预期的技术后果,而非一定是针对研究行为的定向报复。使用一次性账号和隔离网络正是规避此类误判的标准做法。
智能电视隐私的行业困局
这起事件并非孤例。智能电视作为家庭中常年通电、带麦克风和摄像头的设备,长期处于隐私争议的中心。从语音助手误唤醒、到广告追踪、再到固件更新引入的新数据采集行为,厂商在功能创新与用户知情权之间的平衡始终难以令人满意。三星此前曾在多个市场的电视隐私政策中说明语音数据的收集与传输,但政策文本的模糊性让普通用户难以判断实际行为。
逆向工程在这一语境下扮演了双重角色:它既是安全研究者发现漏洞的手段,也可能触碰厂商设定的技术边界。当研究者公开发现时,厂商往往面临两难——承认问题会引发信任危机,否认则可能被进一步的技术证据反驳。对用户而言,这类事件的实际意义在于:应该主动检查电视的隐私设置,关闭不必要的语音采集功能,并关注固件更新日志中关于数据处理的说明。
自动内容识别(ACR) 是智能电视隐私争议中一个常被忽视但影响广泛的技术。ACR通过定期截取屏幕画面并提取特征指纹,与内容数据库比对以识别用户正在观看的节目,用于精准广告投放和收视率统计。与语音采集不同,ACR采集的是屏幕内容而非声音,且往往在隐私政策中以较模糊的措辞披露,用户难以察觉。这使得“电视在看什么”与“电视在听什么”构成两条平行的数据采集链路。讨论智能电视的监听问题时,将音频链路与ACR等视觉/内容链路一并纳入考量,才能完整评估设备的实际数据采集面。
对开发者与研究者的启示
从技术社区的反应看,这起事件的价值不在于结论,而在于方法。它展示了如何通过固件逆向和网络流量观察来审视消费电子设备的AI行为,同时也暴露了研究过程中的操作风险。对于关注AI硬件安全的开发者,以下几点值得留意:对联网设备进行逆向时使用专用网络和一次性账号;记录并保存完整的流量与日志证据,以便区分本地处理与云端传输;在公开发现时明确标注证据强度,避免将推测表述为事实。
在厂商层面,智能电视的AI功能设计需要更高的透明度。本地AI推理本可以成为隐私友好的方案——如果音频数据确实在设备端完成处理且不上传,这反而值得作为卖点宣传。问题在于,当前的产品沟通往往强调功能而回避数据流向,给了猜测和恐慌滋生的空间。这起黑客发现无论最终是否被证实,都指向同一个行业命题:当AI进入客厅,用户有权知道它听到了什么、以及这些数据去了哪里。
证据强度分级 是安全研究中区分“推测”与“确证”的方法论基础。业界通常将发现分为几个层级:行为观察(如流量异常)、组件识别(如发现相关二进制或服务)、调用链还原(完整的函数调用与数据流)、以及可复现的端到端验证(抓包证明数据实际外传)。公开发布时标注发现所处的层级,既保护研究者信誉,也避免社区将线索误读为定论。本文事件目前停留在“组件关联”层级,缺乏抓包与调用栈证据,这正是社区保持谨慎观望的根本原因,也是负责任披露(Responsible Disclosure)流程中厂商沟通应先于公开的前提。
相关推荐
ReLU网络集合的闭性新证:单隐层弱闭,双隐层非闭
新研究证明单隐层ReLU网络集合在W^{1,p}中弱闭,保证Deep Ritz等方法解的存在性;而双隐层网络集合非闭,推翻已有猜想。
FlowMoP:随机多人运动预测新框架
FlowMoP提出条件流匹配框架,联合生成多个智能体的多样化未来运动,通过B样条重参数化与双流Transformer实现交互感知预测,在CMU-Mocap和3DPW上超越确定性基线,并建立WorldPose首个运动预测基线。
分级卷积网络:无需尺度参数的尺度不变性与抗模糊鲁棒性
分级卷积网络利用图像高斯射流的分级向量空间结构,通过回缩操作实现无需尺度参数的尺度不变性,并在未知高斯模糊下显著提升鲁棒性。MNIST实验显示,两像素模糊下准确率保持88.4%,优于尺度归一化导数的66.2%。