Hermes接入Qwen3-8B本地部署:低配电脑也能跑自动化工作流
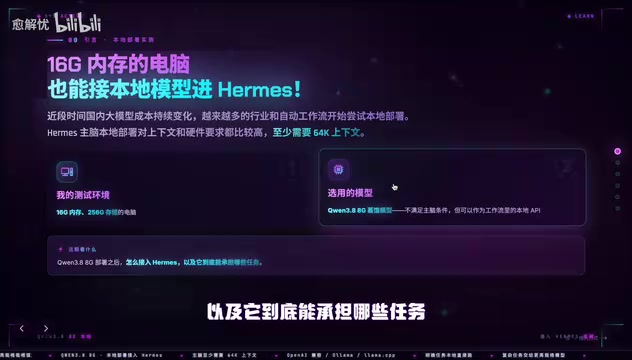
16G内存低配机通过Qwen3-8B蒸馏模型接入Hermes,实现主脑调度加本地执行的分层部署方案。
本文记录了在16G内存低配电脑上将Qwen3-8B蒸馏模型接入Hermes Agent工作流的实测过程。由于Hermes作为任务主脑需要至少64K上下文支持,低配设备无法直接运行,因此采用"主脑+本地执行模型"的分工策略:Hermes负责任务规划与调度,Qwen3-8B蒸馏模型以本地API形式承担内容提取、文本整理、格式转换等规则明确的执行型任务,复杂推理和长上下文任务则仍交给更高规格的模型。本地部署可通过OpenAI兼容接口、Ollama或llama.cpp三种方式实现,但核心难点不在于启动模型,而在于保证服务稳定、接口配置完整,确保Hermes能持续可靠地调用。这套分层调度方案在控制成本的同时兼顾了复杂任务质量,为低配本地部署提供了务实的落地参考。
随着大模型使用成本的变化,越来越多的行业和自动化工作流开始尝试本地部署方案。其中,Hermes Agent(下称Hermes)作为任务主脑对硬件和上下文要求较高——最低需要64K上下文支持。在有限硬件条件下,如何让本地模型融入这套体系,成了不少开发者关心的问题。
本文基于B站UP主在一台16G内存、256G存储电脑上的实测,探讨如何将Qwen3-8B蒸馏模型部署到本地,并接入Hermes工作流中承担实际任务。
为什么选择Qwen3-8B蒸馏模型
Hermes主脑对上下文和硬件的要求,决定了它并不适合直接跑在低配设备上。作为替代思路,可以把轻量级本地模型当作Hermes工作流中调用的本地API,专门负责执行层面的具体任务。
这台测试机配置为16G内存、256G存储,明显达不到Hermes主脑的运行门槛。因此UP主选用了Qwen3-8B蒸馏模型——这个模型虽然无法胜任主脑角色,却足以作为工作流中被调用的执行单元。这种"主脑+执行"的分工,正是低配环境下落地本地部署的关键思路。
**蒸馏模型(Distilled Model)**是指通过知识蒸馏技术,将大型"教师模型"的能力压缩迁移到更小的"学生模型"中。具体做法是让小模型模仿大模型的输出分布,而不只是学习原始标注数据,从而在参数量大幅缩减的情况下,尽可能保留大模型的推理能力。Qwen3-8B蒸馏版就是以更大规模Qwen3模型为教师训练而来,相比同参数量的基础训练模型,通常在指令跟随和推理质量上更具优势。这也是为什么在低配硬件上,蒸馏模型往往比同体积的普通模型更值得优先选用。
本地部署的三种接入方式
将模型跑起来只是第一步。目前本地模型主要有三种应用方式:通过OpenAI兼容接口运行、使用Ollama、或直接用llama.cpp提供服务。方式不同,但最终目标一致——让Hermes能够顺利调用本地模型。
这里有个容易被忽视的坑:如果只启动了模型却没有完成平台注册和接口配置,使用时就可能出现连接中断、模型找不到或调用失败等问题。换句话说,本地部署的核心不只是把模型"跑起来",更重要的是让它能够正常对接应用环境,稳定地被上层调用。
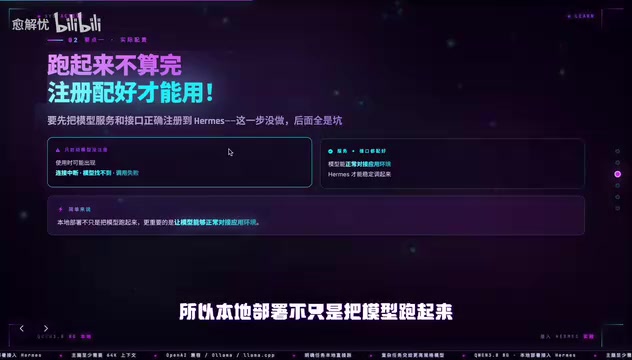
三种接入方式各有侧重:OpenAI兼容接口是指本地推理框架(如vLLM、LM Studio等)对外暴露与OpenAI API规范相同的HTTP端点,上层应用无需修改调用代码即可切换到本地模型,兼容性最强;Ollama是一款专为本地大模型设计的一体化管理工具,提供模型下载、版本管理和服务启动的统一入口,对新手最为友好,内置的/api/chat接口也支持多数主流客户端;llama.cpp则是基于C++实现的高效推理引擎,擅长在纯CPU或低显存环境下以量化格式(如GGUF)运行模型,性能开销最小,但配置相对底层。三者都可以对外提供API服务供Hermes调用,选择时主要考量硬件条件和运维复杂度。
8G模型能承担哪些任务
接入完成后,UP主对模型进行了实际能力测试,涵盖文本生成、内容整理、信息提取、简单分析和代码生成等场景。
实测结论比较明确:只要任务目标清晰,这个规模的模型基本都能完成,尤其在重复性高、规则明确的任务上表现稳定。内容提取、文本整理、分类、格式转换、简单数据处理和基础代码任务,都可以直接交给它处理。
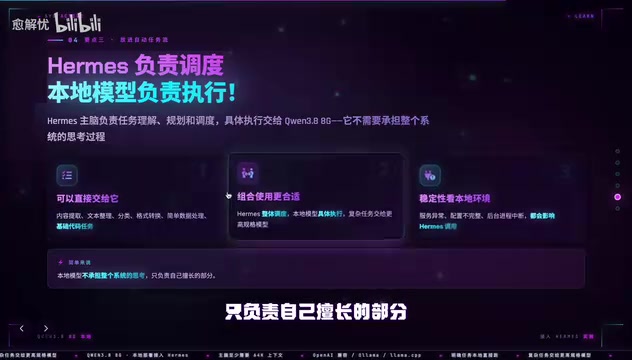
换个角度看,这类任务的共同点在于"不需要长链条推理"。本地模型不擅长复杂多步骤思考,但对边界清晰的执行型工作游刃有余,这也为后续的分工奠定了基础。
Hermes + 本地模型的分工模式
真正的价值体现在将本地模型放进Hermes的自动任务流之后。整套逻辑是:Hermes主脑负责任务理解、规划和调度,把具体执行任务下发给Qwen3-8B蒸馏模型。
这样一来,本地模型不必承担整个系统的思考过程,只需要做自己擅长的部分。从实际应用来看,这种组合方式颇具实用性:
- Hermes负责整体调度:任务拆解、流程规划、判断哪些任务交给谁;
- 本地模型负责具体执行:内容提取、文本整理、格式转换等明确任务;
- 高规格模型处理复杂环节:长上下文、复杂推理和多步骤任务仍需交给更强的模型。
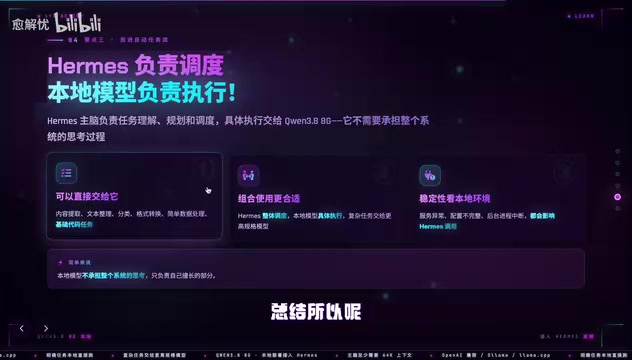
这种分层调度既控制了成本,又保证了复杂任务的质量,是本地化落地一个务实的折中方案。
Hermes Agent作为任务主脑,其核心机制类似于ReAct(Reasoning + Acting)框架:它先对用户目标进行整体规划,将复杂目标拆解为子任务序列,再根据每个子任务的特征选择合适的工具或下游模型来执行,最终汇总结果完成整体目标。这种"规划—调度—执行"的分层架构,使得主脑本身不需要亲自完成每一个细粒度操作,只需维持全局上下文和决策逻辑。正因如此,Hermes对上下文窗口(最低64K)和推理能力要求高,而下游执行单元只需处理有限上下文的单次任务,8B量级的本地模型在这一层完全够用。
稳定性才是本地部署的真正门槛
值得警惕的是,本地应用的稳定性高度依赖本地环境。无论采用OpenAI兼容接口、Ollama还是llama.cpp,只要服务异常、配置不完整或后台进程中断,都会直接影响Hermes的调用链。
这也印证了前文的判断:本地部署的核心不在于"能不能启动",而在于"跑起来之后能不能被稳定调用"。对于要接入自动化工作流的场景来说,服务的可靠性甚至比模型本身的能力更值得投入精力去保障。
结论
这次实测表明,Qwen3-8B蒸馏模型虽然不适合作为Hermes主脑,但作为本地执行模型已经可以落地于部分场景。合理的用法是:简单、重复、明确的任务交给本地模型;长上下文、复杂推理和多步骤任务交给更高规格的模型。
只有在这样的分工下,本地模型才能真正成为自动任务流中的有效辅助工具,而不是勉强承担超出能力范围的角色。对于希望在低配设备上尝试本地部署的用户,这套"主脑调度 + 本地执行"的思路值得参考。
相关推荐
Boox Palma 3发布:新增手写笔支持与全新设计
Boox Palma 3正式发布,新增手写笔支持并采用全新简洁设计。作为口袋尺寸的黑白电子墨水屏阅读器,它在功能升级的同时价格明显上涨。本文解析Palma 3的核心变化与升级价值。
Cursor 3.0 完整入门指南:从零上手 AI 编程 IDE
Cursor 3.0 完整入门教程:从下载安装、创建项目到并行子代理、云端开发、技能与自动化等高级功能。零基础也能上手这款 AI 编程 IDE,掌握模型选择、设计模式与 Git 版本控制的实用技巧。
Codex+Playwright封装测试Skill:UI自动化不再手敲命令
把 Playwright 封装成 Codex Skill,让 AI Agent 通过自然语言完成 UI 自动化测试。本文详解安装加载、Sauce Demo 实战、PO 分层模板,以及 MCP 与 CLI+Skill 的选型对照。