Hibana:统一内存设备上的高速Agent推理引擎

Hibana为统一内存设备打造专用推理引擎,协同三项技术显著提升本地Agent吞吐。
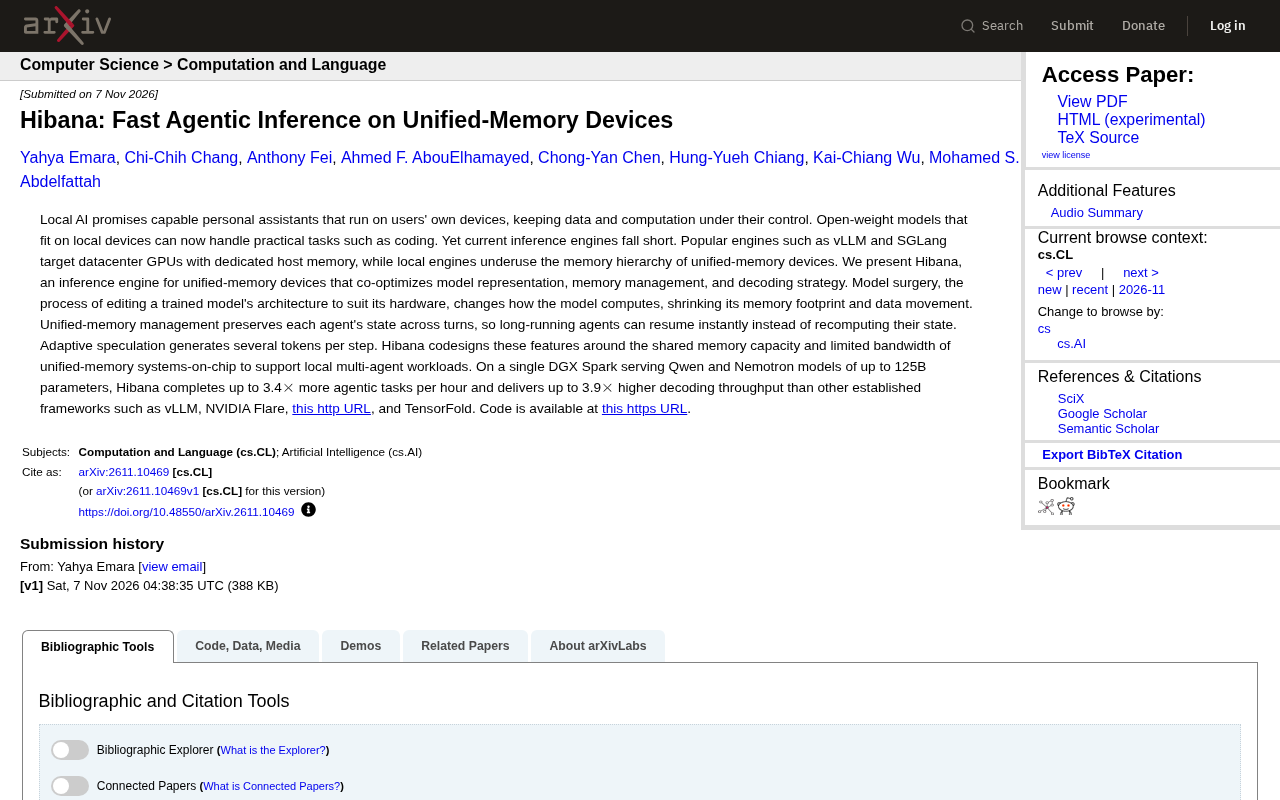
文章介绍了一个名为Hibana的推理引擎,专为统一内存设备(如DGX Spark)设计。现有主流引擎vLLM和SGLang面向数据中心GPU、依赖独立主机内存,而本地引擎又未充分利用统一内存的存储层次,这一矛盾催生了Hibana。它通过三项协同技术解决问题:模型手术从架构层面缩小内存足迹与数据移动;统一内存管理跨轮次保留各Agent状态,避免重复计算;自适应推测让每步生成多个token以提升解码吞吐。在单台DGX Spark上运行高达125B参数的Qwen和Nemotron模型时,Hibana相比vLLM、NVIDIA Flare、llama.cpp和TensorFold,每小时Agent任务数最多提升3.4倍,解码吞吐最多提升3.9倍。代码已在GitHub开源,但其在笔记本、手机等其他设备形态上的表现仍待验证。
为什么本地AI需要专门的推理引擎
本地AI的愿景是让个人助手在用户自己的设备上运行,数据与计算完全受控。开权重模型已经能处理编程等实用任务,但推理引擎却拖了后腿。主流的vLLM和SGLang针对数据中心GPU设计,依赖独立的主机内存;而本地引擎又未能充分利用统一内存设备的存储层次。这一矛盾催生了Hibana——一个专为统一内存设备设计的推理引擎,它协同优化模型表示、内存管理和解码策略。
统一内存(Unified Memory) 是理解本文的关键硬件背景。在传统的数据中心GPU(如NVIDIA H100)上,GPU拥有独立的显存(HBM),CPU与GPU之间通过PCIe/NVLink互联,数据需要在主机内存与显存之间显式搬运,推理引擎(如vLLM的PagedAttention)正是围绕这一“显存—主机内存”两级层次做调度。而统一内存SoC(如NVIDIA DGX Spark搭载的GB10、Apple Silicon的M系列芯片)让CPU与GPU共享同一块物理内存,消除了显式拷贝,但也意味着模型权重、KV Cache和Agent状态全部竞争同一容量与同一带宽。这使传统引擎的显存管理假设失效:既不能靠“把冷数据换出到主机内存”来腾挪空间(因为本就是同一块内存),又必须更精细地控制数据移动以节省带宽。Hibana的设计正是从这一硬件约束出发的。
三项核心技术协同设计
Hibana的核心思路是围绕统一内存SoC的共享内存容量和有限带宽,将三项技术进行协同设计,以支持本地多智能体工作负载。
模型手术:改变计算方式,缩小内存足迹
模型手术(Model Surgery)是指编辑已训练模型的架构以适配硬件。Hibana通过模型手术改变模型的计算方式,从而缩小内存占用和数据移动。这并非简单的量化或剪枝,而是从架构层面让模型更适应统一内存设备的特性,减少对带宽的压力。
统一内存管理:跨轮次保留Agent状态
长时运行的Agent需要在多轮对话中保持状态。Hibana的统一内存管理能够跨轮次保留每个Agent的状态,让Agent可以即时恢复,而不是重新计算状态。这对于需要持续交互的本地多智能体场景至关重要,避免了重复计算带来的延迟和能耗。
自适应推测:每步生成多个token
自适应推测(Adaptive Speculation)技术让模型每步生成多个token,从而提升解码吞吐量。与固定策略的推测解码不同,Hibana的自适应机制能根据负载和硬件状态动态调整,在有限带宽下最大化吞吐。
推测解码(Speculative Decoding) 是自适应推测的技术基础。其原理是用一个轻量级“草稿模型”或额外的预测头,先快速生成若干候选token,再由目标大模型一次性并行验证这些候选,接受其中正确的部分。由于大模型的前向计算在验证阶段是并行的,整体上能用一次大模型前向换来多个token的输出,从而突破自回归解码“每步只能出一个token”的吞吐瓶颈。关键在于草稿的接受率:接受率越高,加速越明显;而接受率会随任务类型、上下文和硬件负载波动。固定长度、固定草稿策略的推测解码在负载变化时容易失效,这正是Hibana强调“自适应”的原因——动态调整每步生成的候选数量与策略,在统一内存有限带宽下维持较高的有效吞吐。
性能表现:单台DGX Spark上的实测
在单台DGX Spark上 serving 参数量高达125B的Qwen和Nemotron模型时,Hibana相比vLLM、NVIDIA Flare、llama.cpp和TensorFold等框架,每小时完成的Agent任务数最多提升3.4倍,解码吞吐量最多提升3.9倍。这些数据来自官方描述,展示了统一内存设备上协同设计带来的显著收益。
有意思的是,Hibana的代码已在GitHub开源(https://github.com/sharar-project/hibana),供开发者复现和进一步优化。
DGX Spark 是NVIDIA推出的小型桌面级AI计算设备,搭载GB10 Grace Blackwell超级芯片,采用统一内存架构,CPU与GPU共享大容量内存(约128GB量级),可在本地运行百亿至千亿参数级别的模型。它的定位介于工作站与边缘设备之间,正是“本地AI”愿景的典型载体。也正因如此,在DGX Spark上对比Hibana与vLLM、llama.cpp等引擎具有代表性:后者多为数据中心GPU或纯CPU场景优化,在统一内存设备上难以发挥硬件潜力。需要注意的是,DGX Spark只是统一内存设备的一个形态,笔记本、手机等设备的带宽与容量差异更大,因此文中提到的加速比不能简单外推。
对本地AI生态的意义
Hibana的出现填补了本地推理引擎的空白。它不追求在数据中心GPU上刷榜,而是聚焦于统一内存设备的实际瓶颈——内存容量和带宽。通过模型手术、状态保留和自适应推测的三重协同,它为本地多智能体工作负载提供了可行的基础设施。随着开权重模型能力增强,这类专用引擎有望让个人AI助手真正落地,在保护隐私的同时提供接近云端的体验。
不过,Hibana目前仅公开了在DGX Spark上的测试结果,更多设备形态(如笔记本、手机)上的表现仍有待验证。其开源策略将加速社区探索,但生态建设仍需时间。
相关推荐

Hermes Agent零基础教程:自进化AI智能体实战
Hermes Agent零基础教程:详解这个GitHub两月获41.7K星的开源自进化AI智能体,从Harness Engineering核心理念、学习循环、三层记忆系统到WSL安装与实战配置,小白也能轻松上手。
AI Agent落地实战:用WorkBuddy打造智能办公助理
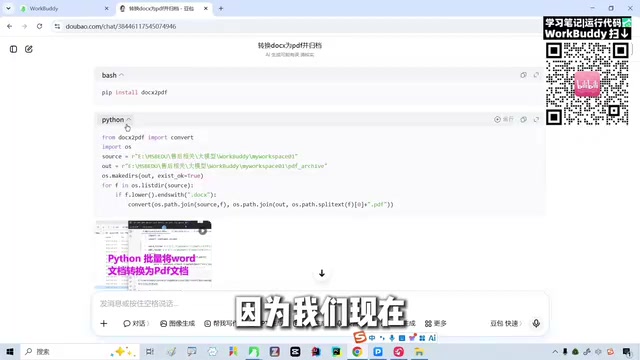
本文通过实战案例演示如何用腾讯WorkBuddy完成文件批量转换与归档,对比聊天大模型与AI Agent的能力差异,分析WorkBuddy的积分体系、适用场景与产品定位,为办公自动化选型提供参考。
从单卡瓶颈到千亿参数:大模型分布式并行6大关键问题
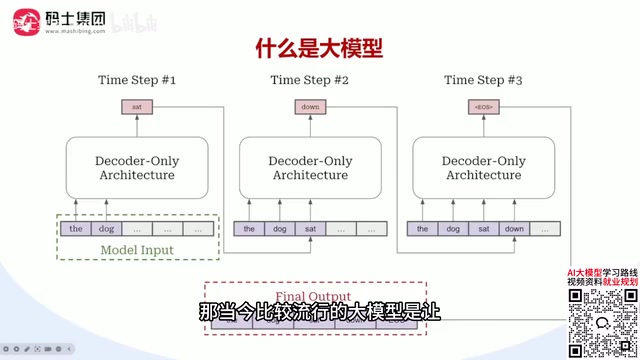
基于B站教程梳理大模型分布式并行核心知识:从decoder-only架构的逐token生成与X乘W计算本质出发,解析单卡瓶颈下数据并行、张量并行、流水线并行等6个关键问题,适合私有化部署与模型训练场景的学习者建立系统认知。